1. 자료의 표현
- bit
- nibble = 4bit = 16진수 1자리
- Byte = 8bit = 256가지 정보 표현
- Word - cpu가 한번에 처리할 수 있는 명령 단위, 일반적으로 풀 워드 (4byte)가 기본
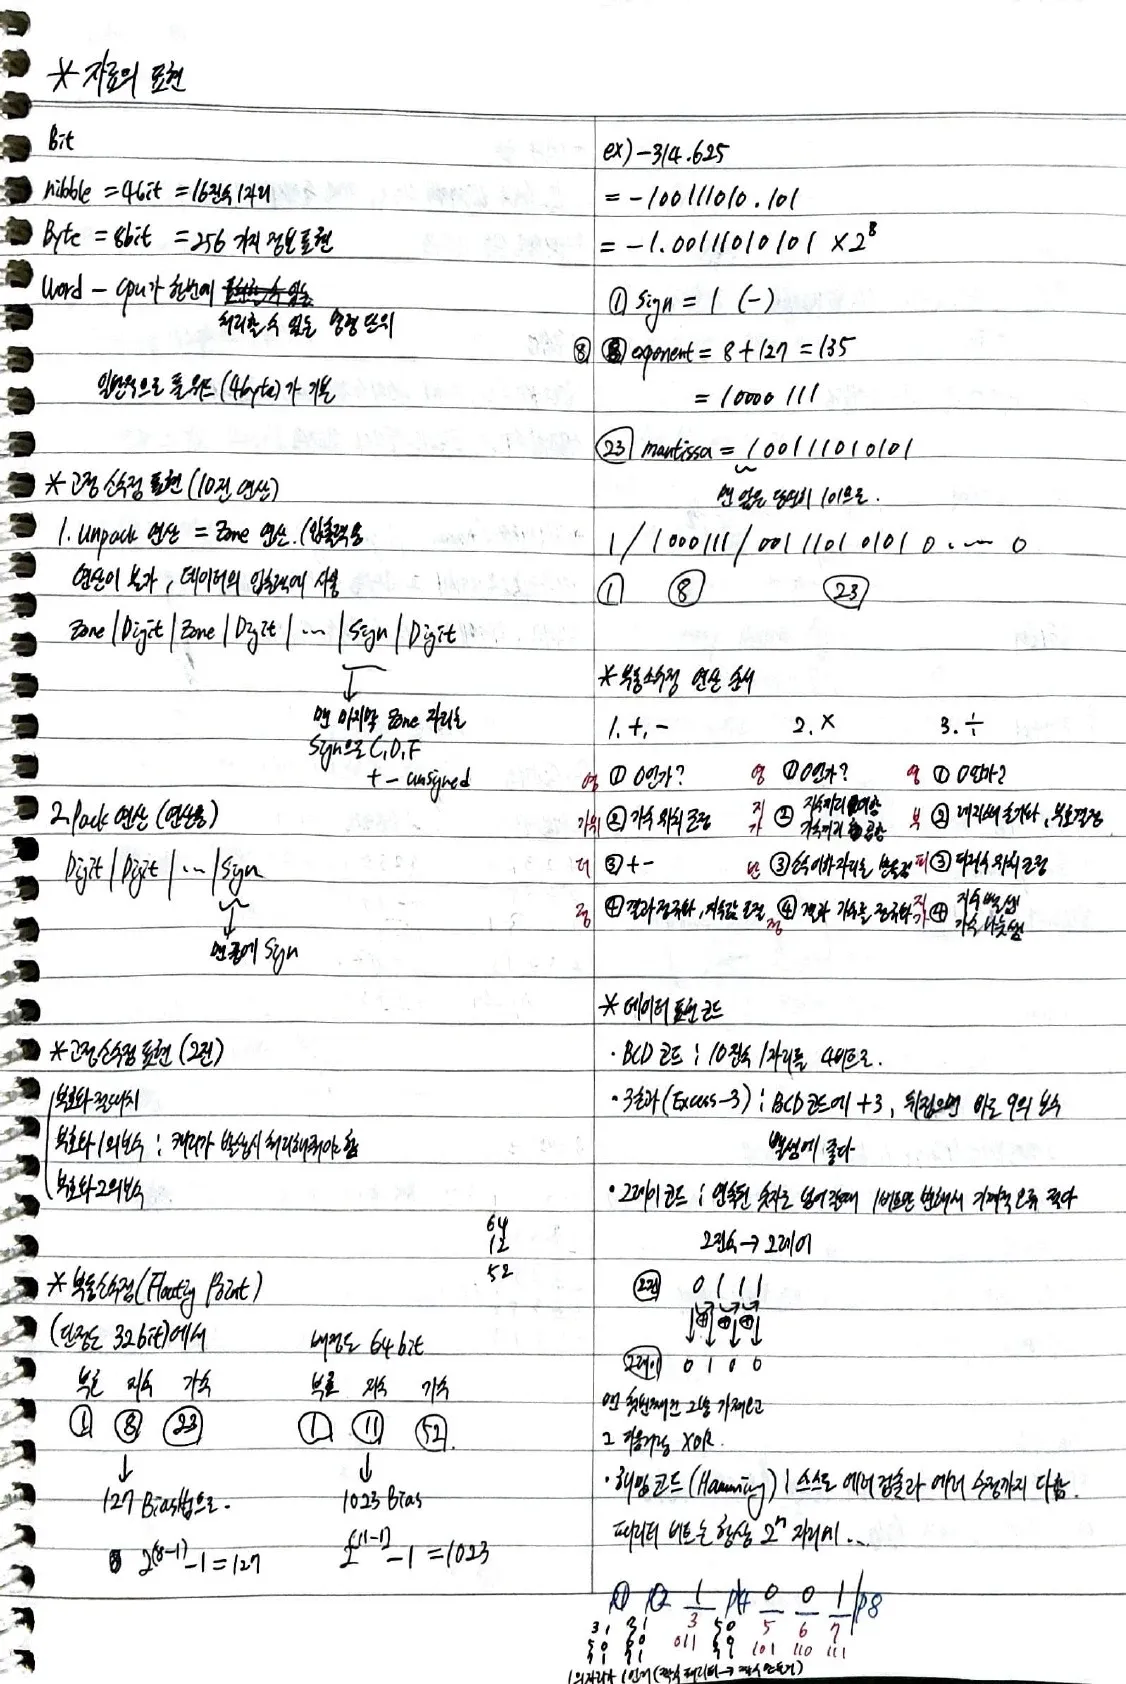
고정 소수점 표현(10진 연산)
- unpack 연산, Zone 연산 (입출력용)
- 연산이 불가, 데이터의 입출력에 사용
- Zone | digit | zone | digit | … | sign | digit
- 맨 마지막 zone 자리는 sign 으로 C,D,F = +, -, unsigned
- pack 연산 (연산용)
- digit | digit | … | sign
- 맨 끝에 sign
고정 소수점 표현 (2진)
- 부호화 절대치 : 시프트할때 부호는 냅두고 옮기기
- 부호화 1의 보수 : 캐리 발생시 처리해줘야함
- 부호화 2의 보수
부동소수점 Floating Point
- 단정도 32비트에서
- 부호 지수 가수 - 1, 8, 23 비트
- 지수는 127 bias 법으로 (2^(8-1) -1) = 127
- 배정도 64비트
- 부호 지수 가수 - 1, 11, 52
- 지수 1023 bias
- -316.625 = -1.00111010101 x 2^8
- sign = 1 (음수)
- exponent = 8+127 = 135 = 10000111
- mantissa = 100111010101 인데, 맨 앞은 어떤수든 당연히 1이므로 맨앞 1은 버린다. 나머지 뒤는 0으로 채움
- 각각 1 8 23 자리
부동소수점 연산 순서
- 더하기, 빼기 - 영 가위 더정
- 0인가?
- 가수 위치 조정
- 더하기 빼기
- 결과 정규화, 지수값 조절
- 곱하기 - 영 지가 반 정
- 0인가?
- 지수끼리 더하고 가수끼리 곱함 (곱셈이니까 당연)
- 소수 이하 자리는 반올림
- 결과 가수를 정규화
- 나누기 - 영 부 피 지가
- 0인가?
- 레지스터 초기화, 부호 결정
- 피제수 위치 조정
- 지수 뺄셈 가수 나눗셈
데이터 표현 코드
- BCD 코드 : 10진수 1자리를 4비트로
- 3초과(Excess-3) : BCD 코드에 +3, 뒤집으면 바로 9의 보수, 뺄셈에 좋다
- 그레이 코드 : 연속된 숫자로 넘어갈때 1비트만 변해서 기계적 오류가 적다
- 2진수 → 그레이 변환
- 2진수 0111
- 맨 처음 0은 그냥 가져오고 그 다음거랑 2진수 안에서 xor 하면서 퐁당퐁당 하듯이
- 0100
- 해밍코드 : 스스로 에러 검출과 에러 수정까지 다함. 패리티비트는 항상 2^n 자리에
- p1 p2 1 p4 0 0 1
- p1
- 3자리 1 (2진수 바꿀때 011 - 1의자리가 1인거 p1에서 체크)
- 5자리 0
- 7자리 1
- p1 = 0 (짝수 패리티니까 전체 짝수가 되게 만들기)
- p2
- 3자리 1
- 6자리 0
- 7자리 1
- p2 = 0
- p4
- 5자리 0
- 6자리 0
- 7자리 1
- p4 = 1
- p1
- p1 p2 1 p4 0 0 1
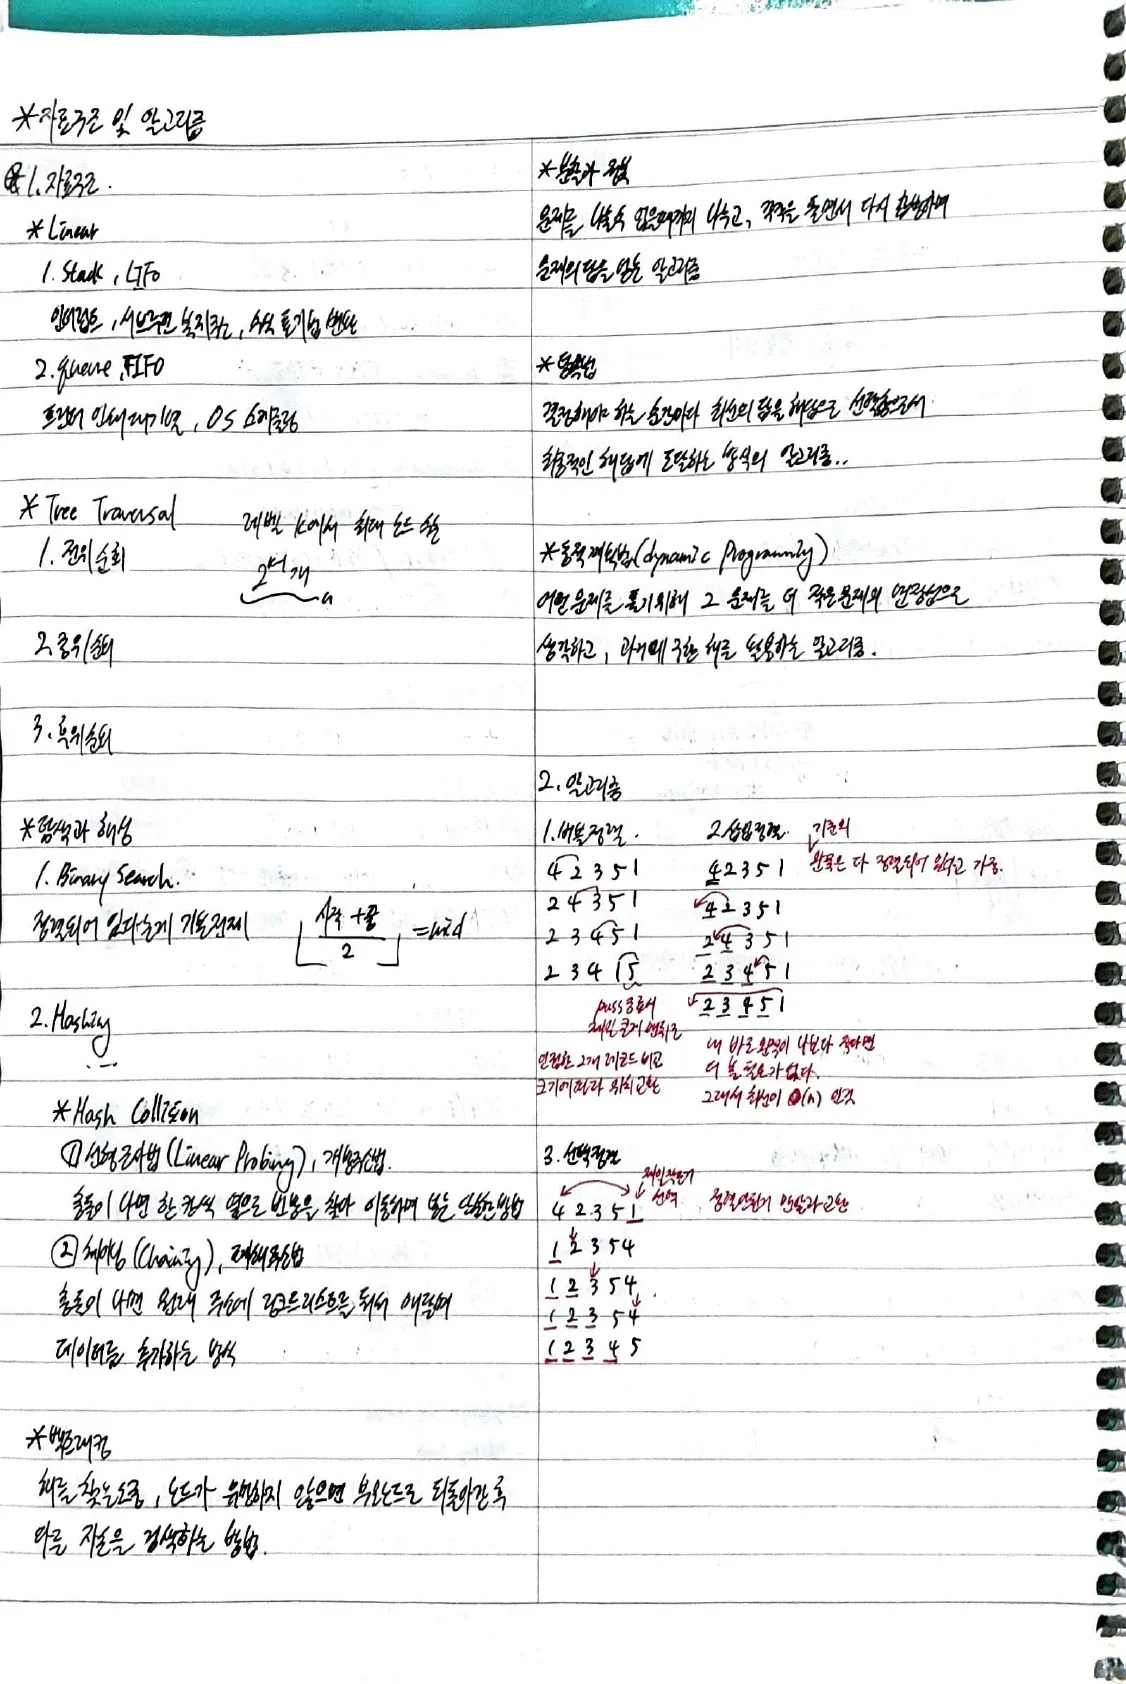
2. 자료구조 및 알고리즘
자료구조
- Linear
- stack, LIFO
- 인터럽트, 서브루틴 복귀주소, 수식 표기법 변환
- queue, FIFO
- 프린터 인쇄 대기열, OS 스케줄링
- stack, LIFO
Tree Traversal
- 전위순회
- 중위순회
- 후위순회
생략
- 트리 레벨 K에서 최대 노드 수는 : 2^(K-1)개
탐색과 해싱
- Binary Search
- 정렬되어 있다는게 기본 전제
- mid = floor((시작+끝)/2)
- Hashing
- Hash Collision 해결
- 선형조사법, Linear Probing, 개방주소법 : 충돌이 나면 한칸씩 옆으로 빈 방을 찾아 이동하며 넣는 단순한 방법
- 체이닝, Chaining, 폐쇄주소법 : 충돌이 나면 원래 주소에 링크드리스트를 둬서 매달며 데이터를 추가하는 방식
- Hash Collision 해결
용어
- 백트래킹 : 해를 찾는 도중, 노드가 유망하지 않으면 부모노드로 되돌아간 후 다른 자손을 검색하는 방법
- 분할과 정복 : 문제를 나눌 수 없을때까지 나누고, 각각을 풀면서 다시 합병하며 문제의 답을 얻는 알고리즘
- 탐욕법 : 결정해야 하는 순간마다 최선의 답을 해답으로 선택하면서 최종적인 해답에 도달하는 방식의 알고리즘
- 동적계획법 : 어떤 문제를 풀기 위해 그 문제를 더 작은 문제의 연장선으로 생각하고, 과거에 구한 해를 활용하는 알고리즘
알고리즘
- 정렬
- 버블정렬
- (4 2) 3 5 1
- 2 (4 3) 5 1
- 2 3 (4 5) 1
- 2 3 4 (1 5)
- PASS 종료시 제일 큰게 맨 뒤로 온다
- 인접한 2개 레코드 비교, 크기에 따라 위치교환
- 삽입정렬
- (4) 2 3 5 1
- (2 4) 3 5 1
- (2 3 4) 5 1
- (2 3 4 5) 1
- (1 2 3 4 5)
- 기준의 왼쪽은 다 정렬되어있다고 가정
- 왼쪽은 하나 정렬, 오른쪽부터 하나씩 보면서 올바른 위치에 삽입, 정렬된 것의 수가 늘어남
- 내 바로 왼쪽이 나보다 작다면 더 볼 필요가 없다, 그래서 최선이 O(n)인것
- 선택정렬
- 4 2 3 5 [1]
- (1) [2] 3 5 4
- (1 2) [3] 5 4
- (1 2 3) 5 [4]
- (1 2 3 4) [5]
- (1 2 3 4 5)
- 제일 작은거 선택, 정렬 안된것의 맨 앞과 교환한다
- 버블정렬
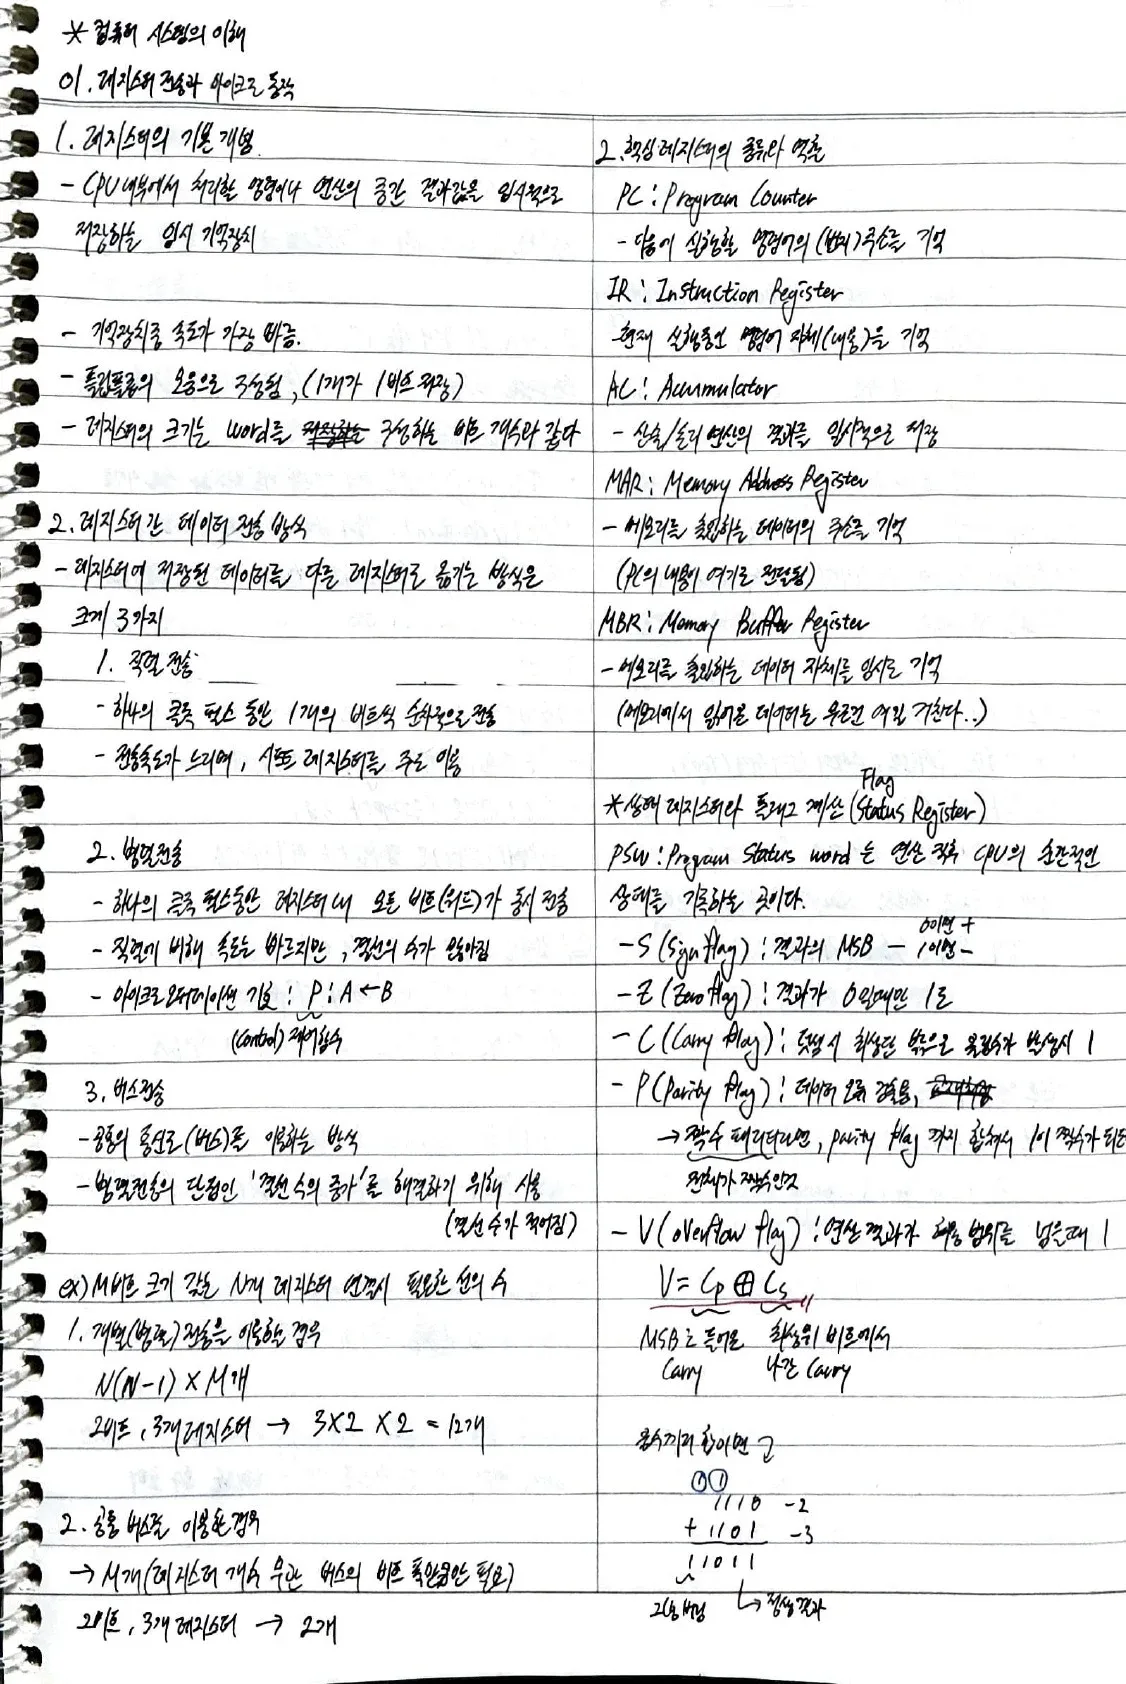
3. 레지스터 전송과 마이크로 동작
레지스터의 기본 개념
- cpu 내부에서 처리할 명령어나 연산의 중간 결과값을 임시적으로 저장하는 임시 기억장치
- 기억장치중 속도가 가장 빠름
- 플립플롭의 모음으로 구성됨 (1개가 1비트 저장)
- 레지스터의 크기는 word를 구성하는 비트 개수와 같다
레지스터간 데이터 전송 방식
- 레지스터에 저장된 데이터를 다른 레지스터로 옮기는 방식은 크게 3가지
- 직렬 전송
- 하나의 클록 펄스 동안 1개의 비트씩 순차적으로 전송
- 전송속도가 느리며, 시프트 레지스터를 주로 이용
- 병렬 전송
- 하나의 클록 펄스 동안 레지스터 내 모든 비트(워드)가 동시 전송
- 직렬에 비해 속도는 빠르지만, 결선의 수가 많아짐
- 마이크로 오퍼레이션 기호 : P:A ←B , P는 Control 제어함수
- 버스 전송
- 공통의 통신로(버스)를 이용하는 방식
- 병렬전송의 단점인 결선 수의 증가 를 해결하기 위해서 사용, 결선 수가 적어진다
- 직렬 전송
- 예시 문제
- M비트 크기 갖는 N개 레지스터 연결시 필요한 선의 수
- 개별(병렬)전송을 이용할 경우 : N(N-1) * M 개
- 2비트, 3개 레지스터라면 : 322 = 12개
- 공통 버스를 이용할 경우 : M개 (레지스터 개수 무관 버스의 비트 폭만큼만 필요)
- 2비트, 3개 레지스터 : 2개 (버스 폭만큼만)
- 개별(병렬)전송을 이용할 경우 : N(N-1) * M 개
- M비트 크기 갖는 N개 레지스터 연결시 필요한 선의 수
핵심 레지스터의 종류와 역할
- PC , Program Counter
- 다음에 실행할 명령어의 번지 주소를 기억
- IR, Instruction Register
- 현재 실행중인 명령어 내용 자체를 기억
- AC, Accumulator
- 산술, 논리 연산의 결과를 일시적으로 저장
- MAR, Memory Address Register
- 메모리를 출입하는 데이터의 주소를 기억
- PC의 내용이 여기로 전달된다
- MBR, Memory Buffer Register
- 메모리를 출입하는 데이터 자체를 임시로 기억
- 메모리에서 읽어온 데이터는 무조건 여길 거친다
- 상태 레지스터와 플래그 계산, Flag Register, Status Register
- PSW : Program Status Word 는 연산 직후 CPU의 순간적인 상태를 기록하는 곳이다
- S, Sign Flag : 결과의 MSB (1이면 음수)
- Z, Zero Flag : 결과가 0이면 1
- C, Carry Flag : 덧셈시 최상단 밖으로 올림수 발생시 1
- P, Parity Flag : 데이터 오류 검출용
- 짝수 패리티라면 패리티 플래그까지 합쳐서 1이 짝수가 되도록, 그러니까 짝수 패리티면 합쳐서 짝수를 만드는거임
- V, oVerflow Flag : 연산 결과가 허용범위를 넘을때 1
- V = C_p xor C_s
- MSB로 들어온 carry, 최상위 비트에서 나간 carry의 xor 값이 다르면 오버플로우다
- -2와 -3 더해보면
- 1110 + 1101 (2의 보수, MSB는 부호비트)
- MSB 자리에 carry 들어오고, 최상위 비트에서 carry가 또 나간다.
- 근데 결과는 최상위 비트에서 나간거 그냥 버리면 문제가 없다.
- 아무튼 최상위 비트 나간거, 최상위 비트 들어온거 carry가 1 1 이거나 0 0 이면 문제가 없음. 두개가 다르면 오버플로우다
- PSW : Program Status Word 는 연산 직후 CPU의 순간적인 상태를 기록하는 곳이다
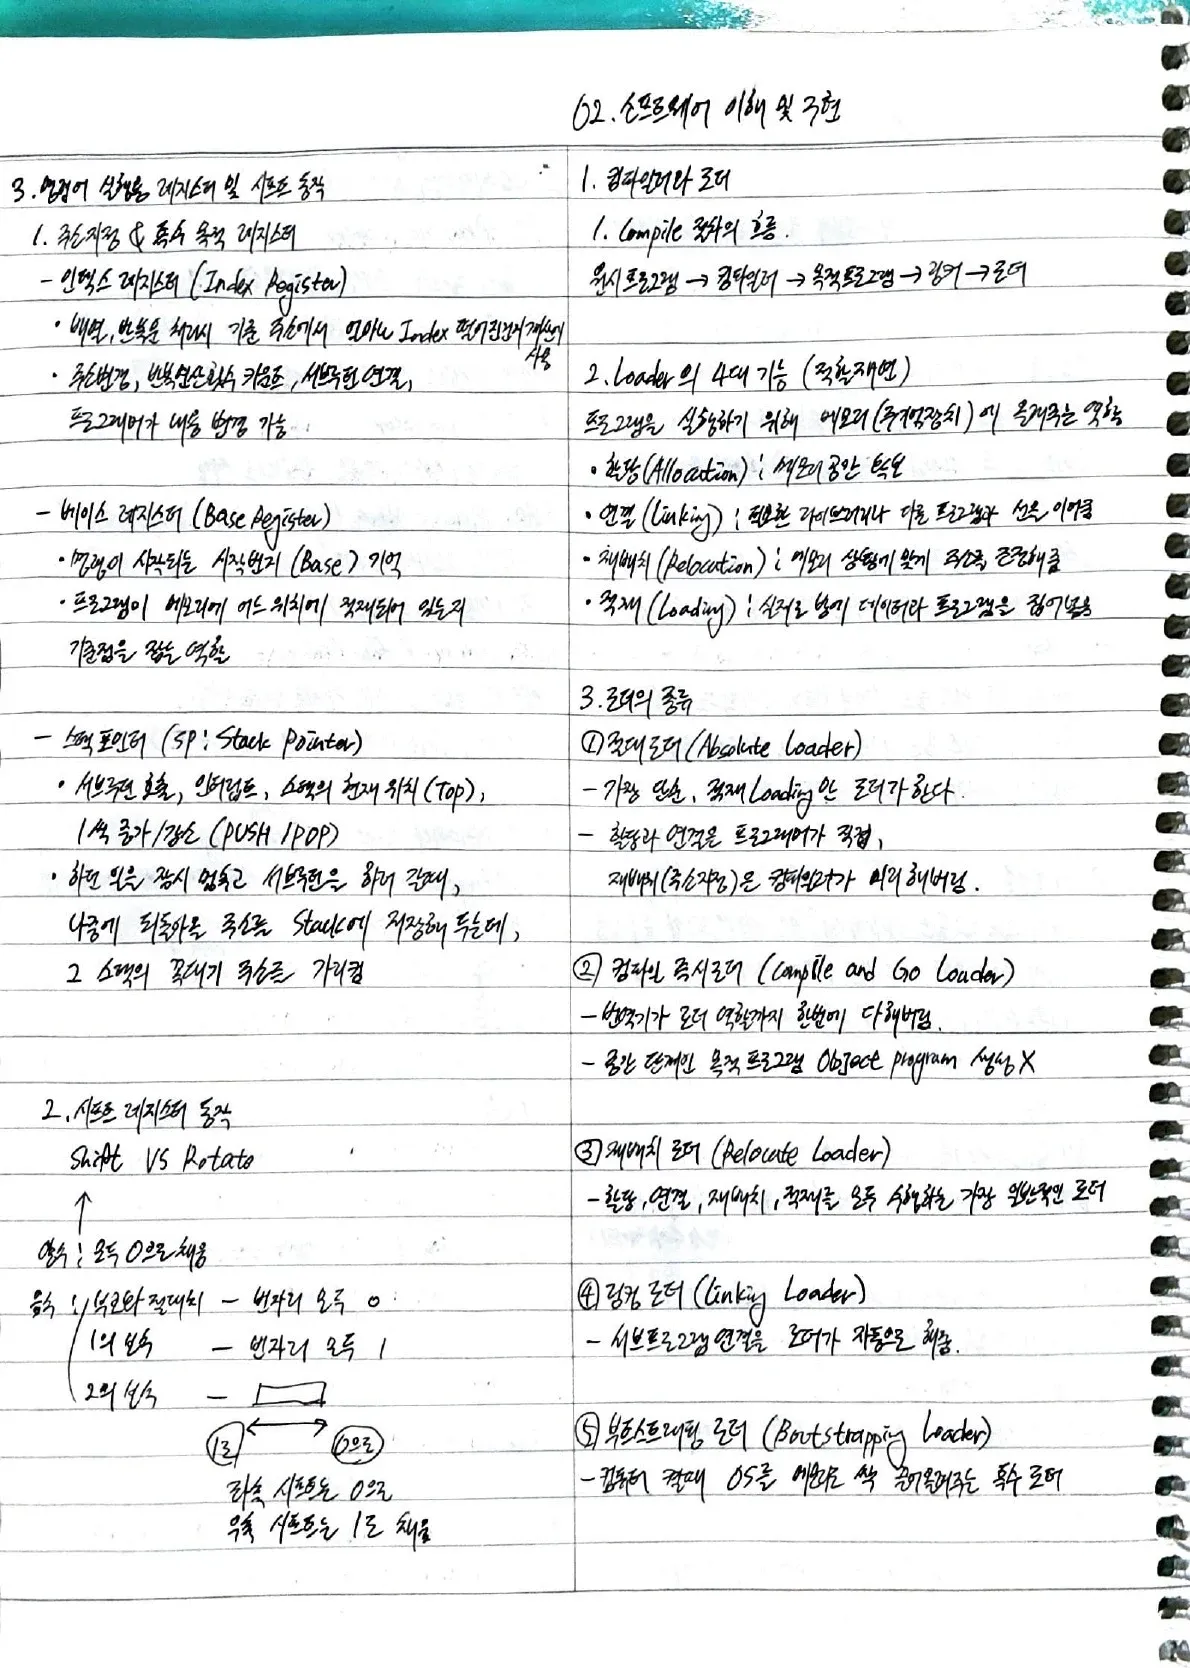
명령어 실행용 레지스터 및 시프트 동작
- 주소지정 & 특수 목적 레지스터
- 인덱스 레지스터, Index Register
- 배열, 반복문 처리시 기준 주소에서 얼마나 인덱스 떨어진건지 계산에 사용
- 주소변경, 반복연산횟수 카운트, 서브루틴연결, 프로그래머가 내용 변경 가능
- 베이스 레지스터, Base Register
- 명령이 시작되는 시작번지 Base 기억
- 프로그램이 메모리에 어느 위치에 적재되어 있는지 기준점을 잡는 역할
- 스택 포인터 SP, Stack Pointer
- 서브루틴 호출, 인터럽트, 스택의 현재 위치(Top), 1씩 증가/감소 (PUSH/POP)
- 하던 일을 잠시 멈추고 서브루틴을 하러 갈때, 나중에 되돌아올 주소를 스택에 저장해두는데, 그 스택의 꼭대기 주소를 가리킴
- 인덱스 레지스터, Index Register
- 시프트 레지스터 동작
- shift vs rotate
- 양수면 시프트는 모두 0으로 채우면 된다
- 음수
- 부호화 절대치 - 빈자리 모두 0
- 1의 보수 - 빈자리 모두 1
- 2의 보수 - 왼쪽시프트 1로, 오른쪽시프트 0으로
- shift vs rotate
4. 소프트웨어 이해 및 구현
컴파일러와 로더
- 컴파일 절차의 흐름
- 원시프로그램 - 컴파일러 - 목적프로그램 - 링커 - 로더
- 로더의 4대 기능 - 적할재연
- 프로그램을 실행하기 위해 메모리(주기억장치) 에 올려주는 역할
- 할당 Allocation : 메모리 공간 확보
- 연결 Linking : 필요한 라이브러리나 다른 프로그램과 선을 이어줌
- 재배치 Relocation : 메모리 상황에 맞게 주소를 조정해줌
- 적재 Loading : 실제로 방에 데이터와 프로그램을 집어넣음
- 프로그램을 실행하기 위해 메모리(주기억장치) 에 올려주는 역할
- 로더의 종류
- 절대로더 Absolute Loader
- 가장 단순, 적재 Loading만 로더가 한다
- 할당과 연결은 프로그래머가 직접, 재배치(주소지정)은 컴파일러가 미리 해버림
- 컴파일 즉시 로더 Compile and Go Loader
- 번역기가 로더 역할까지 한번에 다해버림
- 중간 단계인 목적프로그램 Object Program 생성 안함
- 재배치 로더 Relocate Loader
- 할당, 연결, 재배치, 적재를 모두 수행하는 가장 일반적인 로더
- 링킹 로더 Linking Loader
- 서브프로그램 연결을 로더가 자동으로 해줌
- 부트스트래핑 로더 Bootstrapping Loader
- 컴퓨터 켤때 OS를 메모리로 싹 끌어올려주는 특수 로더
- 절대로더 Absolute Loader
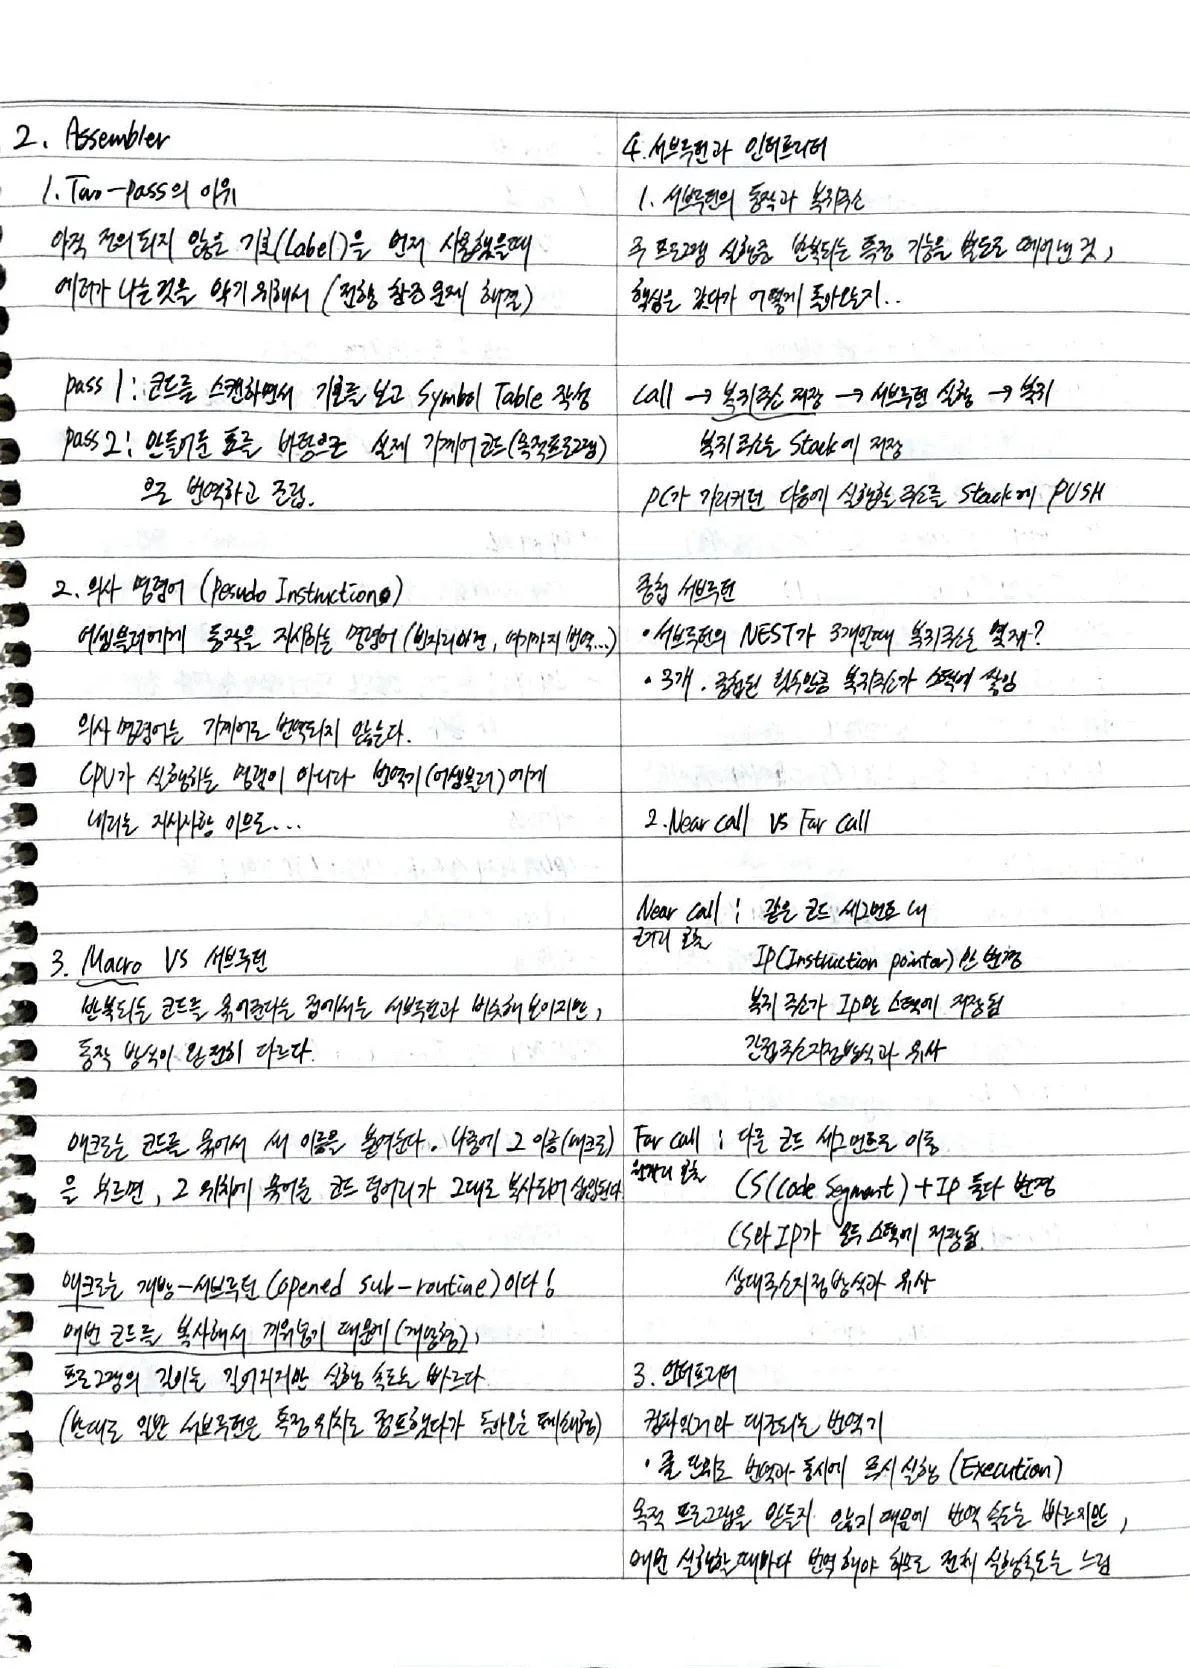
Assembler
- Two-Pass의 이유
- 아직 정의되지 않은 기호(Label)을 먼저 사용했을때 에러가 나는것을 막기 위해서(전향 참조문제 해결)
- Pass 1 : 코드를 스캔하면서 기호를 보고 Symbol Table 작성
- Pass 2 : 만들어둔 표를 바탕으로 실제 기계어 코드(목적프로그램) 으로 번역하고 조립
- 의사 명령어 Pesudo Instruction
- 어셈블러에게 동작을 지시하는 명령어 (빈자리 마련해라, 여기까지 번역해라..)
- 의사명령어는 기계어로 번역되지 않는다
- CPU가 실행하는 명령이 아니라 번역기(어셈블러) 에게 내리는 지시사항 이므로
Macro VS 서브루틴
- 반복되는 코드를 묶어준다는 점에서는 서브루틴과 비슷해 보이지만, 동작 방식이 완전히 다르다
- 매크로는 코드를 묶어서 새 이름을 붙여둔다. 나중에 그 이름(매크로) 를 부르면, 그 위치에 묶어둔 코드 덩어리가 그대로 복사되어 삽입된다
- 매크로는 개방 서브루틴(Opened sub-routine) 이다.
- 매번 코드를 복사해서 끼워넣기 때문에(개방형) 프로그램의 길이는 길어지지만 실행 속도는 빠르다
- (반대로 일반 서브루틴은 특정 위치로 점프했다가 돌아오는 폐쇄형)
서브루틴과 인터프리터
- 서브루틴의 동작과 복귀주소
- 주 프로그램 실행중 반복되는 특정 기능을 별도로 떼어낸 것, 핵심은 갔다가 어떻게 돌아오는지…
- call - 복귀주소 저장 (스택에) - 서브루틴 실행 - 복귀
- PC가 가리키던 다음에 실행할 주소를 stack 에 PUSH
- 중첩 서브루틴
- 서브루틴의 NEST가 3개일때 복귀주소는 몇개?
- 3개이다. 중첩된 횟수만큼 복귀주소가 스택에 쌓임
- Near call VS Far Call
- Near Call, 근거리 호출
- 같은 코드 세그먼트 내
- IP(instruction pointer) 만 변경
- 복귀 주소가 IP만 스택에 저장됨
- 간접주소지정방식과 유사
- Far Call, 원거리 호출
- 다른 코드 세그먼트로 이동
- CS(Code Segment) + IP둘다 변경
- CS와 IP가 모두 스택에 저장됨
- 상대주소지정방식과 유사
- Near Call, 근거리 호출
- 인터프리터
- 컴파일러와 대조되는 번역기
- 줄 단위로 번역과 동시에 즉시실행
- 목적 프로그램을 만들지 않기 때문에 번역 속도는 빠르지만, 매번 실행할때마다 번역해야 하므로 전체 실행속도는 느림
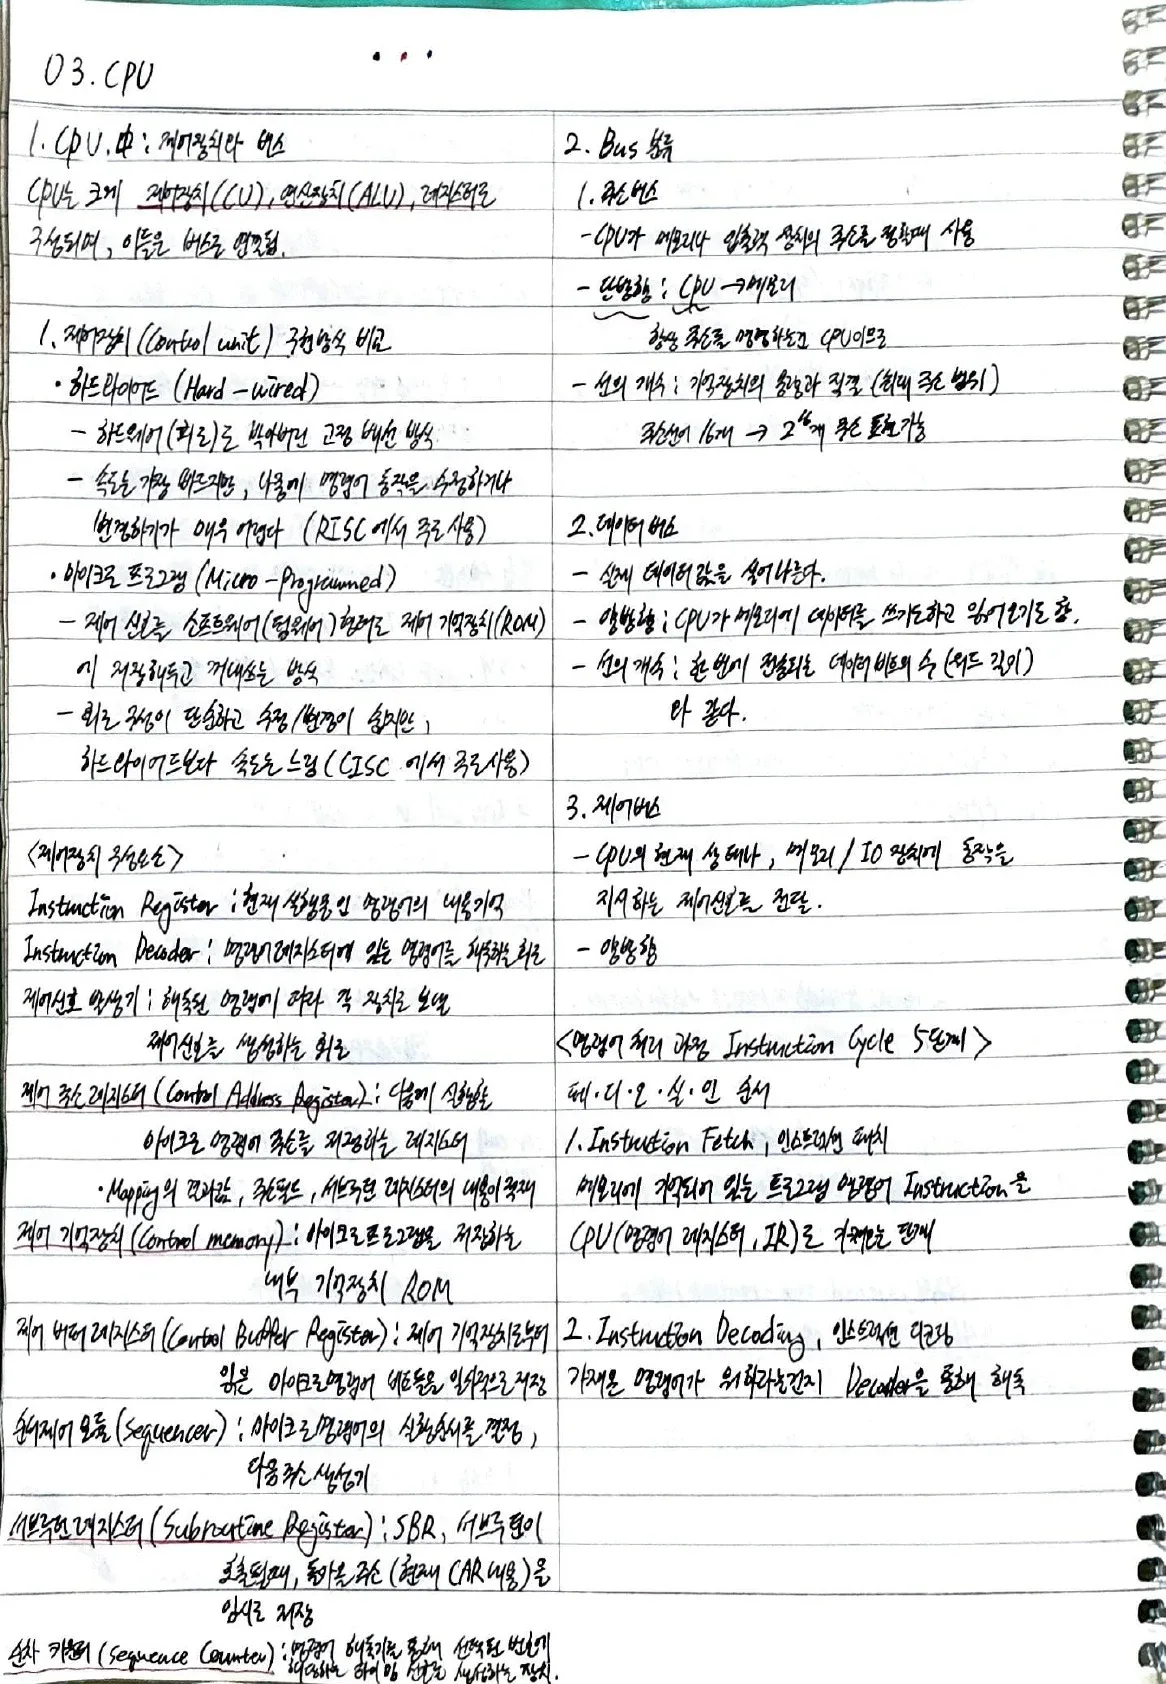
5. CPU
제어장치와 버스
- CPU는 크게 제어장치 CU, 연산장치 ALU, 레지스터로 구성되며, 이들은 버스로 연결됨
- 제어장치 Control Unit 구현방식 비교
- 하드와이어드 Hard-Wired
- 하드웨어 회로로 박아버린 고정 배선 방식
- 속도는 가장 빠르지만, 나중에 명령어 동작을 수정하거나 변경하기가 매우 어렵다
- RISC 에서 주로 사용
- 마이크로프로그램 Micro-Programmed
- 제어신호를 소프트웨어(펌웨어) 형태로 제어기억장치(ROM) 에 저장해두고 꺼내쓰는 방식
- 회로 구성이 단순하고 수정/변경이 쉽지만, 하드와이어드보다 속도는 느림
- CISC 에서 주로 사용
- 하드와이어드 Hard-Wired
- 제어장치 구성요소
- Instruction Register
- 현재 실행중인 명령어의 내용 기억
- Instruction Decoder
- 명령어 레지스터에 있는 명령어를 해독하는 회로
- 제어신호 발생기
- 해독된 명령에 따라 각 장치로 보낼 제어신호를 생성하는 회로
- 제어 주소 레지스터, Control Address Register
- 다음에 실행할 마이크로명령어 주소를 지정하는 레지스터
- Mapping의 결과값, 주소필드, 서브루틴 레지스터의 내용이 적재
- 제어 기억장치, Control memory
- 마이크로프로그램을 저장하는 내부 기억장치 ROM
- 제어 버퍼 레지스터, Control Buffer Register
- 제어 기억장치로부터 읽은 마이크로명령어 비트들을 일시적으로 저장
- 순서제어모듈, Sequencer
- 마이크로명령어의 실행순서를 결정, 다음주소 생성기
- 서브루틴레지스터, Subroutine Register
- SBR, 서브루틴이 호출될때, 돌아올 주소(현재 CAR내용)을 임시로 저장
- 순차 카운터, Sequence Counter
- 명령어 해독기를 통해 선택된 번호에 해당하는 타이밍 신호를 생성하는장치
- Instruction Register
Bus 분류
- 주소버스
- cpu가 메모리나 입출력장치의 주소를 정할때 사용
- 단방향 : cpu → 메모리 (항상 주소를 명령하는건 cpu이므로!)
- 선의 개수 : 기억장치의 용량과 직결 (최대 주소 범위)
- 주소선이 16개 → 2^16개 주소 표현 가능
- 데이터 버스
- 실제 데이터값을 증가시킨다
- 양방향 : cpu가 메모리에 데이터를 쓰기도 하고 읽어오기도 함
- 선의 개수 : 한번에 전송되는 데이터비트의 수 (워드 길이) 와 같다
- 제어버스
- cpu의 현재 상태나, 메모리, 입출력장치에 동작을 지시하는 제어신호를 전달
- 양방향
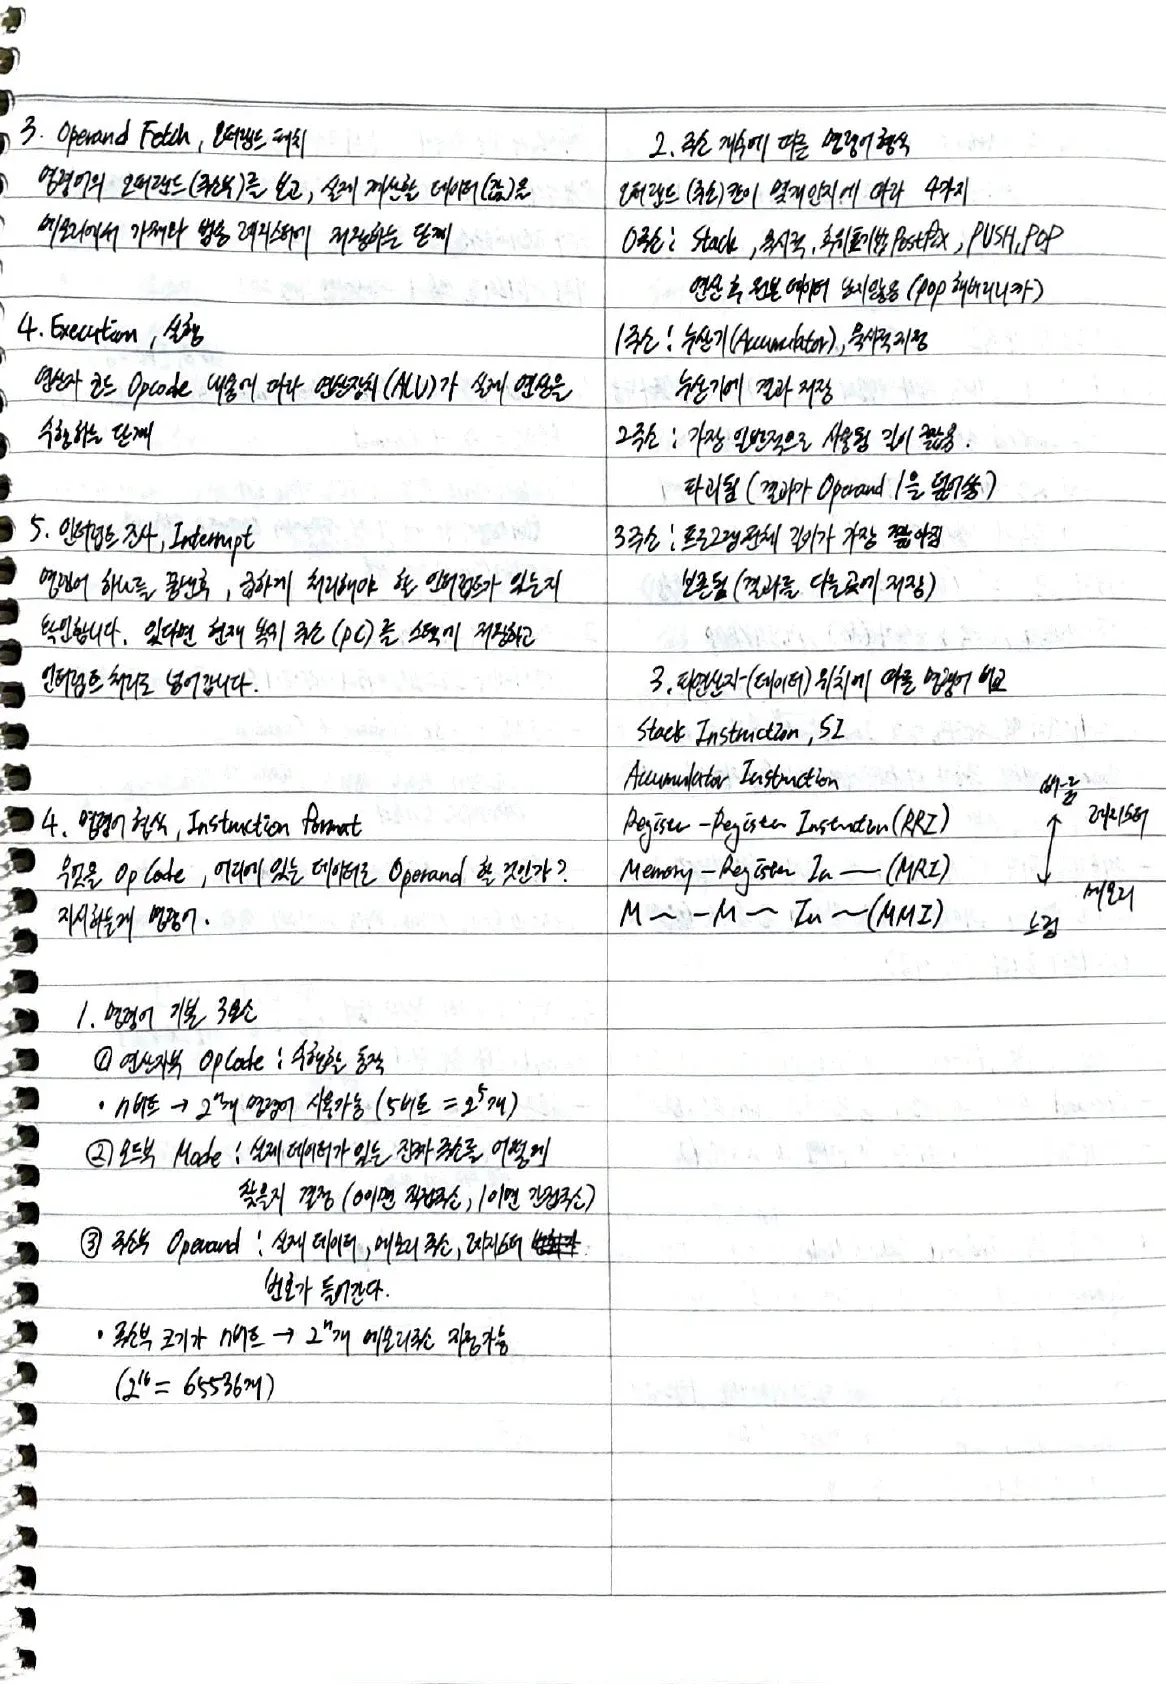
명령어 처리 과정 Instruction Cycle 5단계 - 페디오실인
- Instruction Fetch, 인스트럭션 패치
- 메모리에 기억되어 있는 프로그램 명령어 Instruction을 cpu(명령어 레지스터,IR)로 가져오는 단계
- Instruction Decoding, 인스트럭션 디코딩
- 가져온 명령어가 뭐하라는건지 Decoder 을 통해 해독
- Operand Fetch, 오퍼랜드 패치
- 명령어의 오퍼랜드(주소부)를 보고, 실제 계산할 데이터(값)을 메모리에서 가져와 범용 레지스터에 저장하는 단계
- Execution, 실행
- 연산자 코드 Opcode 내용에 따라 연산장치(ALU) 가 실제 연산을 수행하는 단계
- Interrupt, 인터럽트 조사
- 명령어 하나를 끝낸 후, 급하게 처리해야 할 인터럽트가 있는지 확인합니다. 있다면 현재 복귀 주소(PC)를 스택에 저장하고 인터럽트 처리로 넘어갑니다
명령어 형식, Instruction Format
- 무엇을 Opcode, 어디에 있는 데이터로 Operand 할 것인가? 지시하는 명령어
- 명령어 기본 3요소
- 연산자부, Opcode
- 수행할 동작
- n비트 → 2^n개 명령어 사용가능
- 모드부, Mode
- 실제 데이터가 있는 진짜 주소를 어떻게 찾을지 결정 (0이면 직접주소, 1이면 간접주소)
- 주소부, Operand
- 실제 데이터, 메모리 주소, 레지스터 번호가 들어간다
- 주소부 크기가 n비트 → 2^n개 메모리 주소 지정가능 (2^16 = 65536)
- 연산자부, Opcode
- 주소 개수에 따른 명령어 형식
- 오퍼랜드(주소) 칸이 몇개인지에 따라 4가지
- 0주소
- Stack, 묵시적, 후위표기법 Postfix, PUSH, POP
- 연산후 원본 데이터 남지 않음 (POP 해버리니까)
- 1주소
- 누산기 (Accumulator), 묵시적 지정
- 누산기에 결과 저장
- 2주소
- 가장 일반적으로 사용됨, 길이 짧음
- 원본 파괴됨, 결과가 operand 1을 덮어 쓴다
- 3주소
- 프로그램 전체 길이가 가장 짧아짐
- 원본 보존됨, 결과를 다른곳에 저장
- 피연산자(데이터) 위치에 따른 명령어 비교
- Stack Instruction, SI
- Accumulator Instruction
- Register-Register Instruction (RRI)
- Memory-Register Instruction (MRI)
- Memory-Memory Instruction (MMI)
- 위로 갈수록 빠름(레지스터), 아래로 갈수록 느림(메모리)
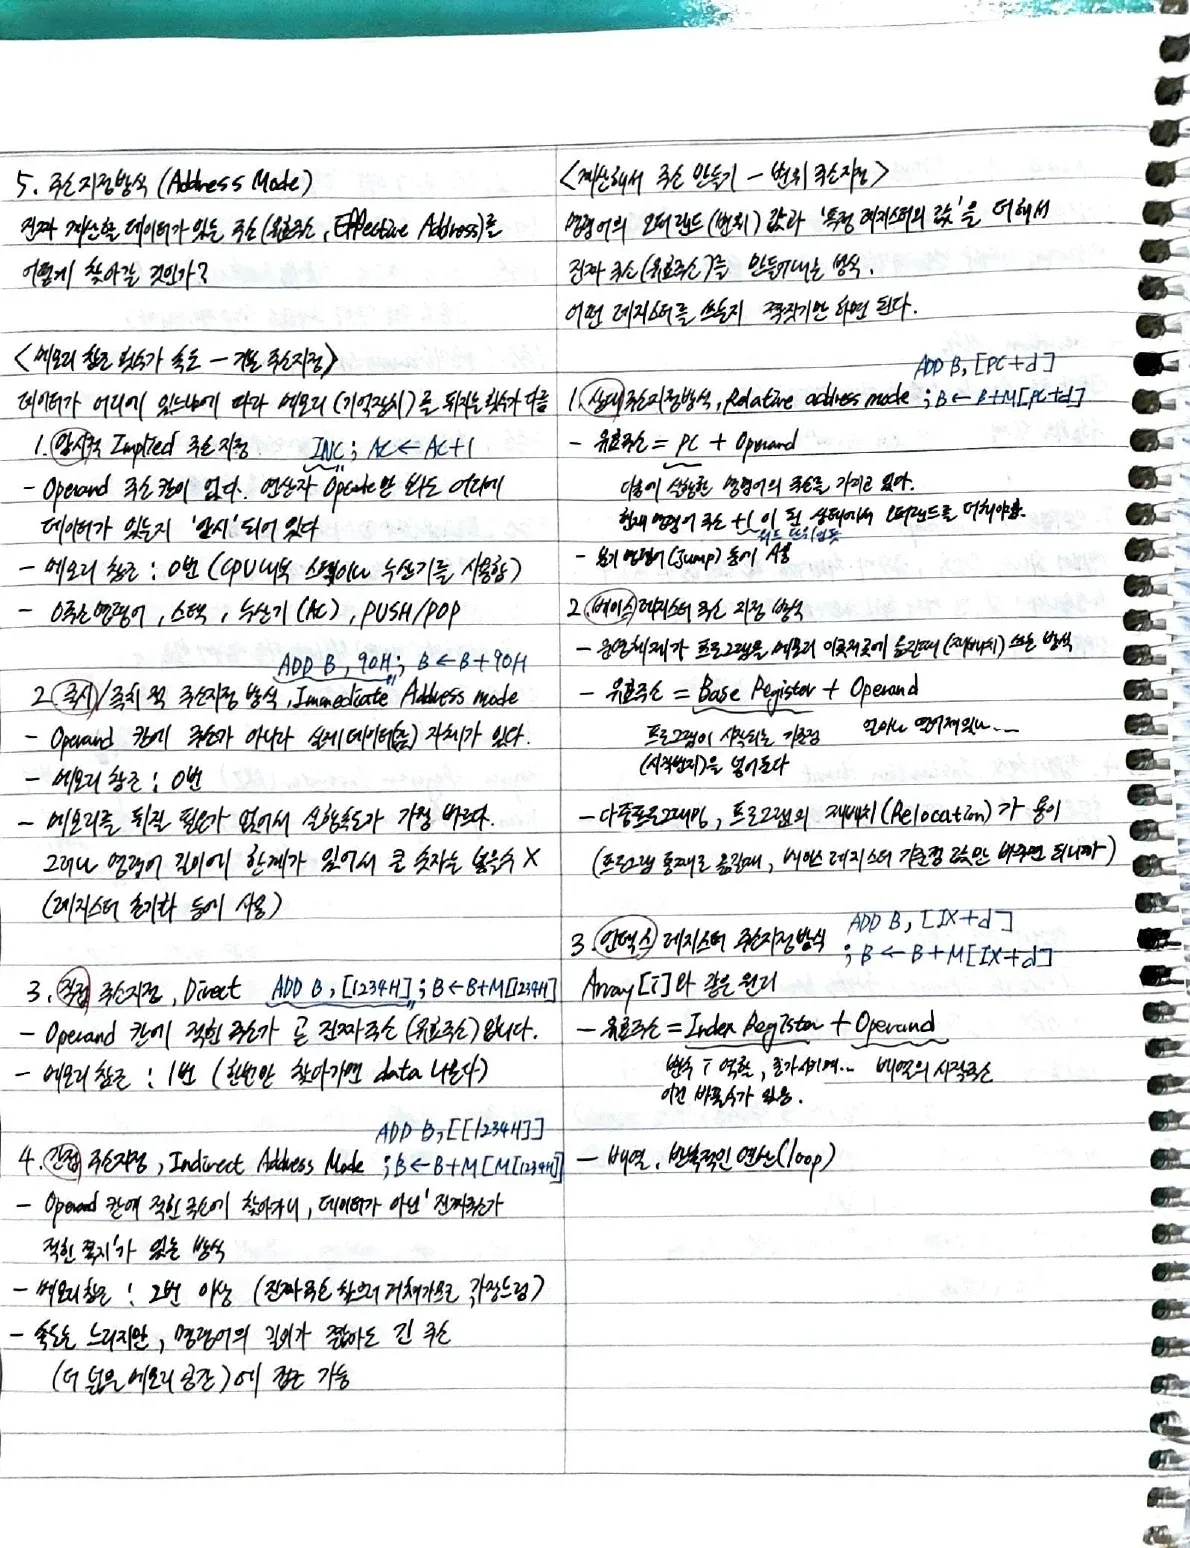
주소지정방식, Address mode
진짜 계산할 데이터가 있는 주소 (유효주소, Effective Address)을 어떻게 찾아갈 것인가?
암시, 즉시, 직접, 간접 주소지정 방식
-
메모리 참조 횟수가 속도 - 기본 주소지정
데이터가 어디에 있느냐에 따라 메모리(기억장치)를 뒤지는 횟수가 다름)
- 암시적 Implied 주소 지정
- INC; AC←AC+1
- Operand 주소 칸이 없다. 연산자 Opcode만 봐도 어디에 데이터가 있는지 암시 되어 있다.
- 메모리 참조 : 0번 (CPU 내부 스택이나 누산기를 사용함)
- 0주소 명령어, 스택, 누산기(AC), PUSH/POP
- 즉시/즉치적 주소 지정 방식, Immediate Address Mode
- ADD B, 90H; B←B+90H
- Operand 칸에 주소가 아니라 실제 데이터(값) 자체가 있다.
- 메모리 참조 : 0번
- 메모리를 뒤질 필요가 없어서 실행속도가 가장 빠르다
- 그러나 명령어 길이에 한계가 있어서 큰 숫자는 넣을수 없다 (레지스터 초기화등에 사용)
- 직접 주소지정, Direct
- ADD B, [1234H]; B←B+M[1234H]
- Operand 칸에 적힌 주소가 곧 진짜주소(유효주소)다
- 메모리 참조 : 1번 (한번만 찾아가면 데이터 나온다)
- 간접 주소지정, Indirect Address Mode
- ADD B,[[1234H]]; B←B+M[M[1234H]]
- Operand칸에 적힌 주소에 찾아가니, 데이터가 아닌 진짜주소가 적힌 쪽지가 있는 방식
- 메모리 참조 : 2번 이상 (진짜주소 찾으러 거쳐가므로, 가장 느림)
- 속도는 느리지만, 명령어의 길이가 짧아도 긴 주소(더 넓은 메모리 공간) 에 접근 가능
- 암시적 Implied 주소 지정
-
계산해서 주소 만들기 - 변위 주소지정
상대(PC), 베이스 레지스터, 인덱스 레지스터 주소 지정 방식
- 명령어의 오퍼랜드(변위)값과 특정 레지스터의 값을 더해서 진짜주소(유효주소)를 만들어내는 방식
- 어떤 레지스터를 쓸지 짝짓기만 하면 된다
- 상대 주소 지정 방식, Relative Address Mode
- ADD B,[PC+d]; B←B+M[PC+d]
- 유효주소 = PC + Operand
- PC는 다음에 실행할 명령어의 주소를 가지고 있다
- 현재 명령어주소 +1(워드 단위인듯) 이 된 상태에서 오퍼랜드를 더해야함
- 분기명령어 JUMP 등에 사용
- 베이스 레지스터 주소 지정 방식
- 운영체제가 프로그램을 메모리 이곳저곳에 옮길때(재배치) 쓰는 방식
- 유효주소 = Base Register + Operand
- Base Register는 프로그램이 시작되는 기준점(시작번지)를 넣어준다, 그리고 거기서 얼마나 떨어져있나
- 다중 프로그래밍, 프로그램의 재배치(Relocation)가 용이
- 프로그램 통쨰로 옮길때, 베이스 레지스터 기준점 값만 바꾸면 되니까
- 인덱스 레지스터 주소 지정 방식
- ADD B, [IX + d]; B← B+M[IX+d]
- Array[i]와 같은 원리
- 유효주소 = Index Register + Operand
- Index Register 는 변수 i 역할, 증가시키며… 이건 바꿀수가 있음, Operand에는 배열의 시작주소
- 배열, 반복적인 연산 (loop)
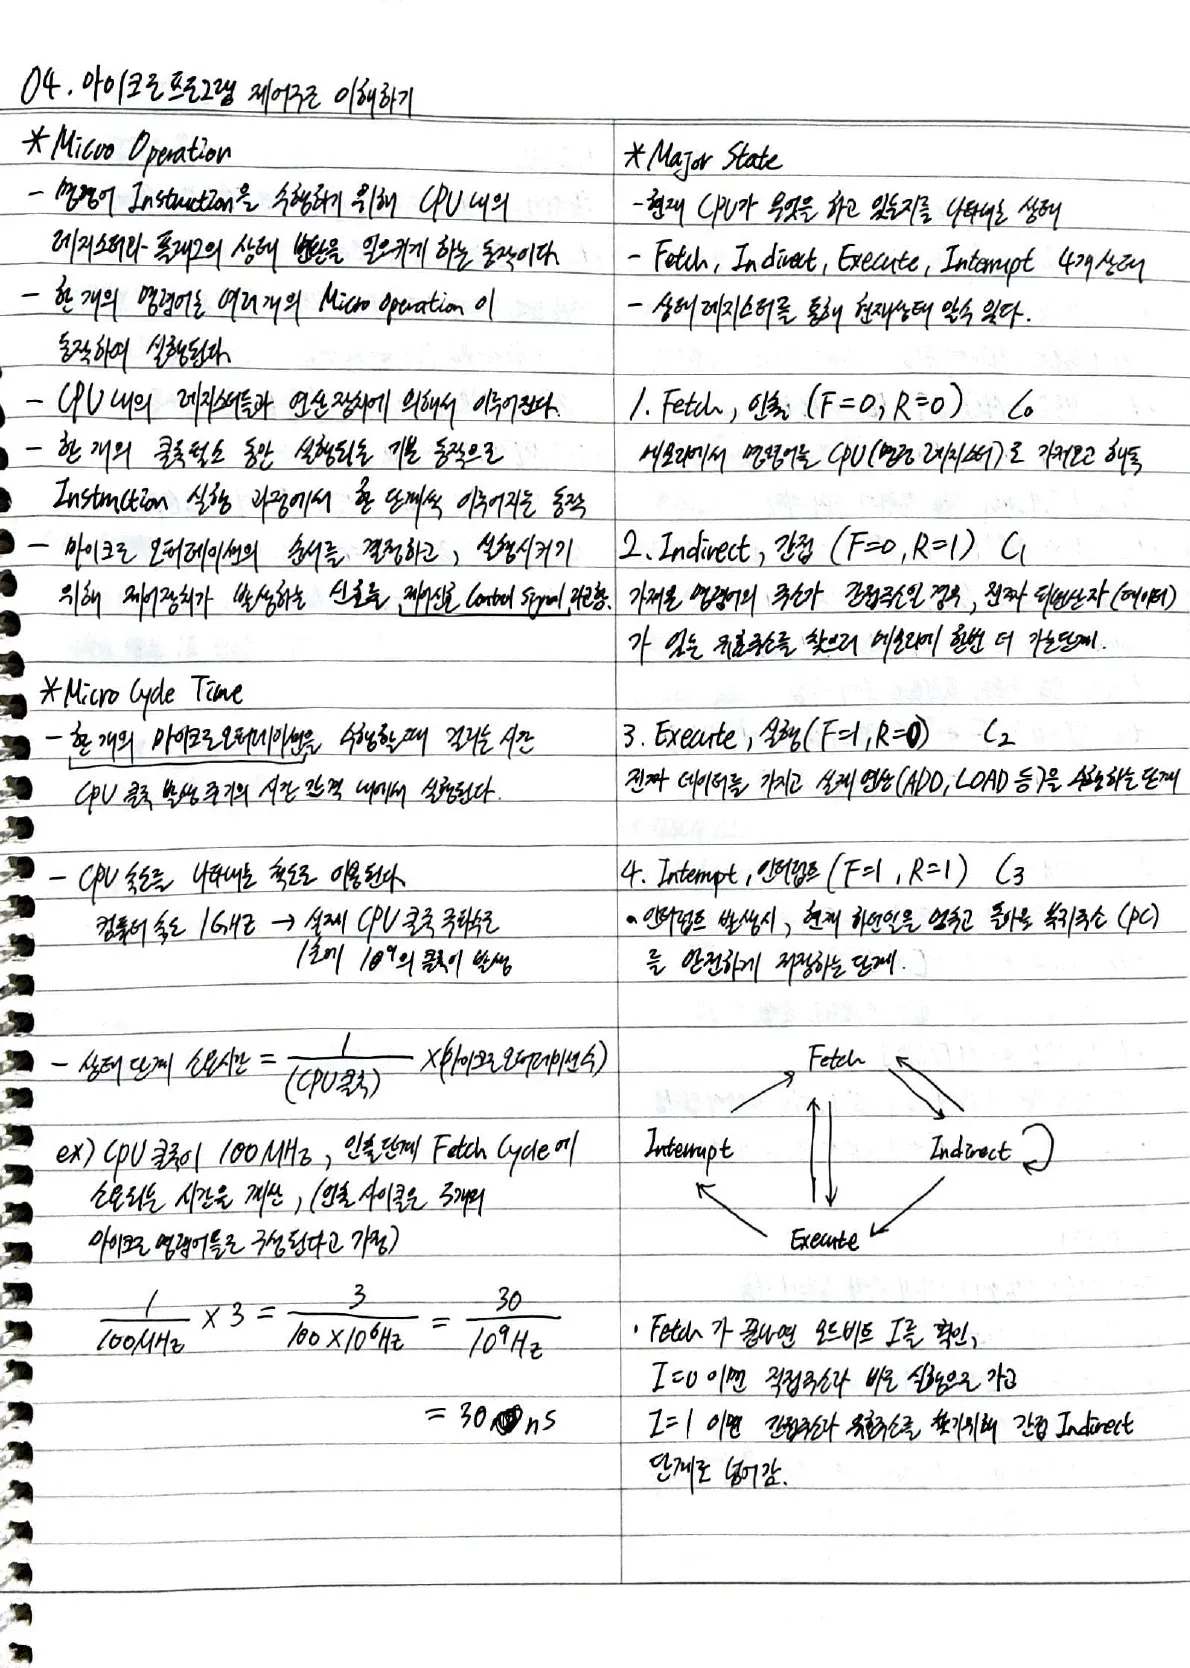
6. 마이크로프로그램 제어구조 이해하기
Micro Operation
- 명령어 Instruction을 수행하기 위해 CPU 내의 레지스터나 플래그의 상태 전환을 일으키게 하는 동작이다
- 한 개의 명령어는 여러 개의 Micro Operation 이 동작하여 실행된다
- CPU 내의 레지스터들과 연산 장치에 의해서 이루어진다
- 한 개의 클록펄스 동안 실행되는 기본 동작으로 Instruction 실행 과정에서 한 단계씩 이루어지는 동작
- 마이크로오퍼레이션의 순서를 결정하고, 실행시키기 위해 제어장치가 발생하는 신호를 제어신호 Control Signal 라고 함
Micro Cycle Time
- 한 개의 마이크로오퍼레이션(CPU 클록 발생주기의 시간 간격 내에서 실행된다) 을 수행할 때 걸리는 시간
- CPU 속도를 나타내는 척도로 이용된다. 컴퓨터 속도가 1GHz면 실제 CPU 클록 주파수로 1초에 10^9의 클록이 발생
- 상태 단계 소요시간 = (1/(CPU클록)) * (마이크로오퍼레이션수)
- 예시 문제
- CPU 클록이 100MHz, 인출 단계 Fetch Cycle 에 소요되는 시간을 계산 (인출 사이클은 3개의 마이크로명령어들로 구성된다고 가정)
- 3 / (100MHz) = 3 / (100 * 10^6) Hz = 30 / 10^9 Hz = 30 ns
Major State
- 현재 CPU가 무엇을 하고 있는지를 나타내는 상태
- Fetch, Indirect, Execute, Interrupt 4개 상태
- 상태 레지스터를 통해 현재 상태 알 수 있다
-
Fetch, 인출 (F=0,R=0) C_0
메모리에서 명령을 CPU(명령 레지스터)로 가져오고 해독
-
Indirect, 간접 (F=0,R=1) C_1
가져온 명령어의 주소가 간접주소일 경우, 진짜 피연산자 (데이터) 가 있는 유효주소를 찾으러 메모리에 한번 더 가는 단계
-
Execute, 실행 (F=1,R=0) C_2
진짜 데이터를 가지고 실제연산 (ADD,LOAD 등)을 수행하는 단계
-
Interrupt, 인터럽트 (F=1,R=1) C_3
인터럽트 발생시, 현재 하던일을 멈추고 돌아올 복귀주소 (PC) 를 안전하게 저장하는 단계
- Fetch 가 끝나면 모드비트 I를 확인, I=0 이면 직접주소라 바로 실행으로 가고, I=1 이면 간접주소라 유효주소를 찾기 위해 간접 Indirect 단계로 넘어감
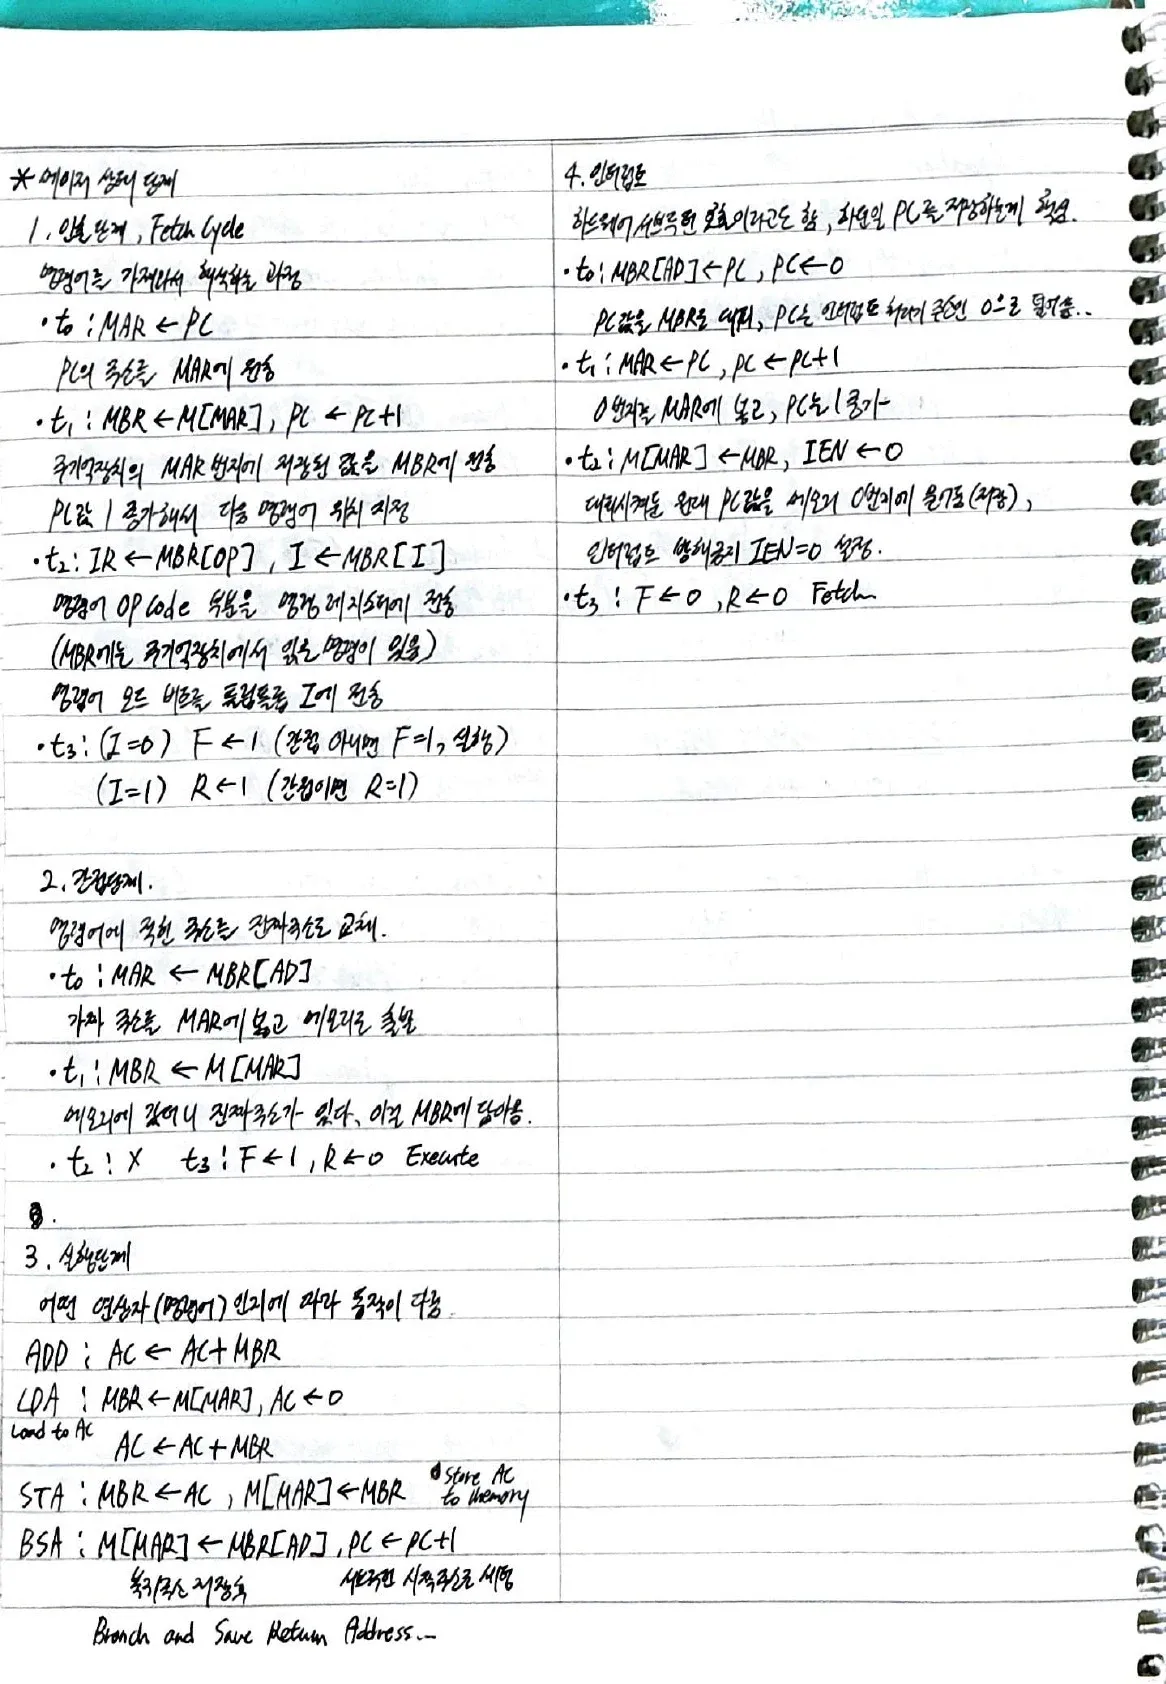
메이저 상태 단계
- 인출단계, Fetch Cycle - 명령어를 가져와서 해석하는 과정
- t_0 : MAR ← PC
- PC의 주소를 MAR에 전송
- t_1 : MBR ← M[MAR], PC← PC+1
- 주기억장치의 MAR 번지에 저장된 값을 MBR에 전송
- PC값 1 증가시켜서 다음 명령어 위치 지정
- t_2 : IR ← MBR[OP], I←MBR[I]
- 명령어 Opcode 부분을 명령 레지스터에 전송 (MBR에는 주기억장치에서 읽은 명령이 있음)
- 명령어 모드 비트를 플립플롭 I 에 전송
- t_3
- (I=0) F←1 (간접 아니면 F=1, 실행)
- (I=1) R←1 (간접이면 R=1)
- t_0 : MAR ← PC
- 간접단계 - 명령어에 적힌 주소를 진짜주소로 교체
- t_0 : MAR ← MBR[AD]
- 가짜주소를 MAR에 넣고 메모리로 출발
- t_1 : MBR ← M[MAR]
- 메모리에 갔더니 진짜주소가 있다, 이걸 MBR에 담아옴
- t_2 : x
- t_3 : F←1 , R←0
- Execute
- t_0 : MAR ← MBR[AD]
- 실행단계 - 어떤 연산자(명령어) 인지에 따라 동작이 다름
- ADD : AC ← AC + MBR
- LDA (Load to AC) : MBR ← M[MAR], AC ← 0, AC ← AC + MBR
- STA (Store AC to memory) : MBR ← AC , M[MAR] ← MBR
- BSA (Branch and Store Return Address) : M[MAR] ← MBR[AD] , PC← PC + 1 (복귀주소 저장후 서브루틴 시작주소로 세팅)
- 인터럽트 - 하드웨어 서브루틴 호출이라고도 함, 하던일 PC를 저장하는게 핵심
- t_0 : MBR[AD] ← PC, PC ← 0
- PC 값을 MBR로 대피, PC는 인터럽트 처리기 주소인 0으로 덮어씀
- t_1 : MAR ← PC, PC ← PC + 1
- 0번지를 MAR에 넣고, PC는 1 증가
- t_2 : M[MAR] ← MBR, IEN ← 0
- 대피시켜둔 원래 PC값을 메모리 0번지에 묻어둠(저장)
- 인터럽트 방해금지 IEN =0 설정
- t_3 : F ← 0, R← 0
- Fetch
- t_0 : MBR[AD] ← PC, PC ← 0
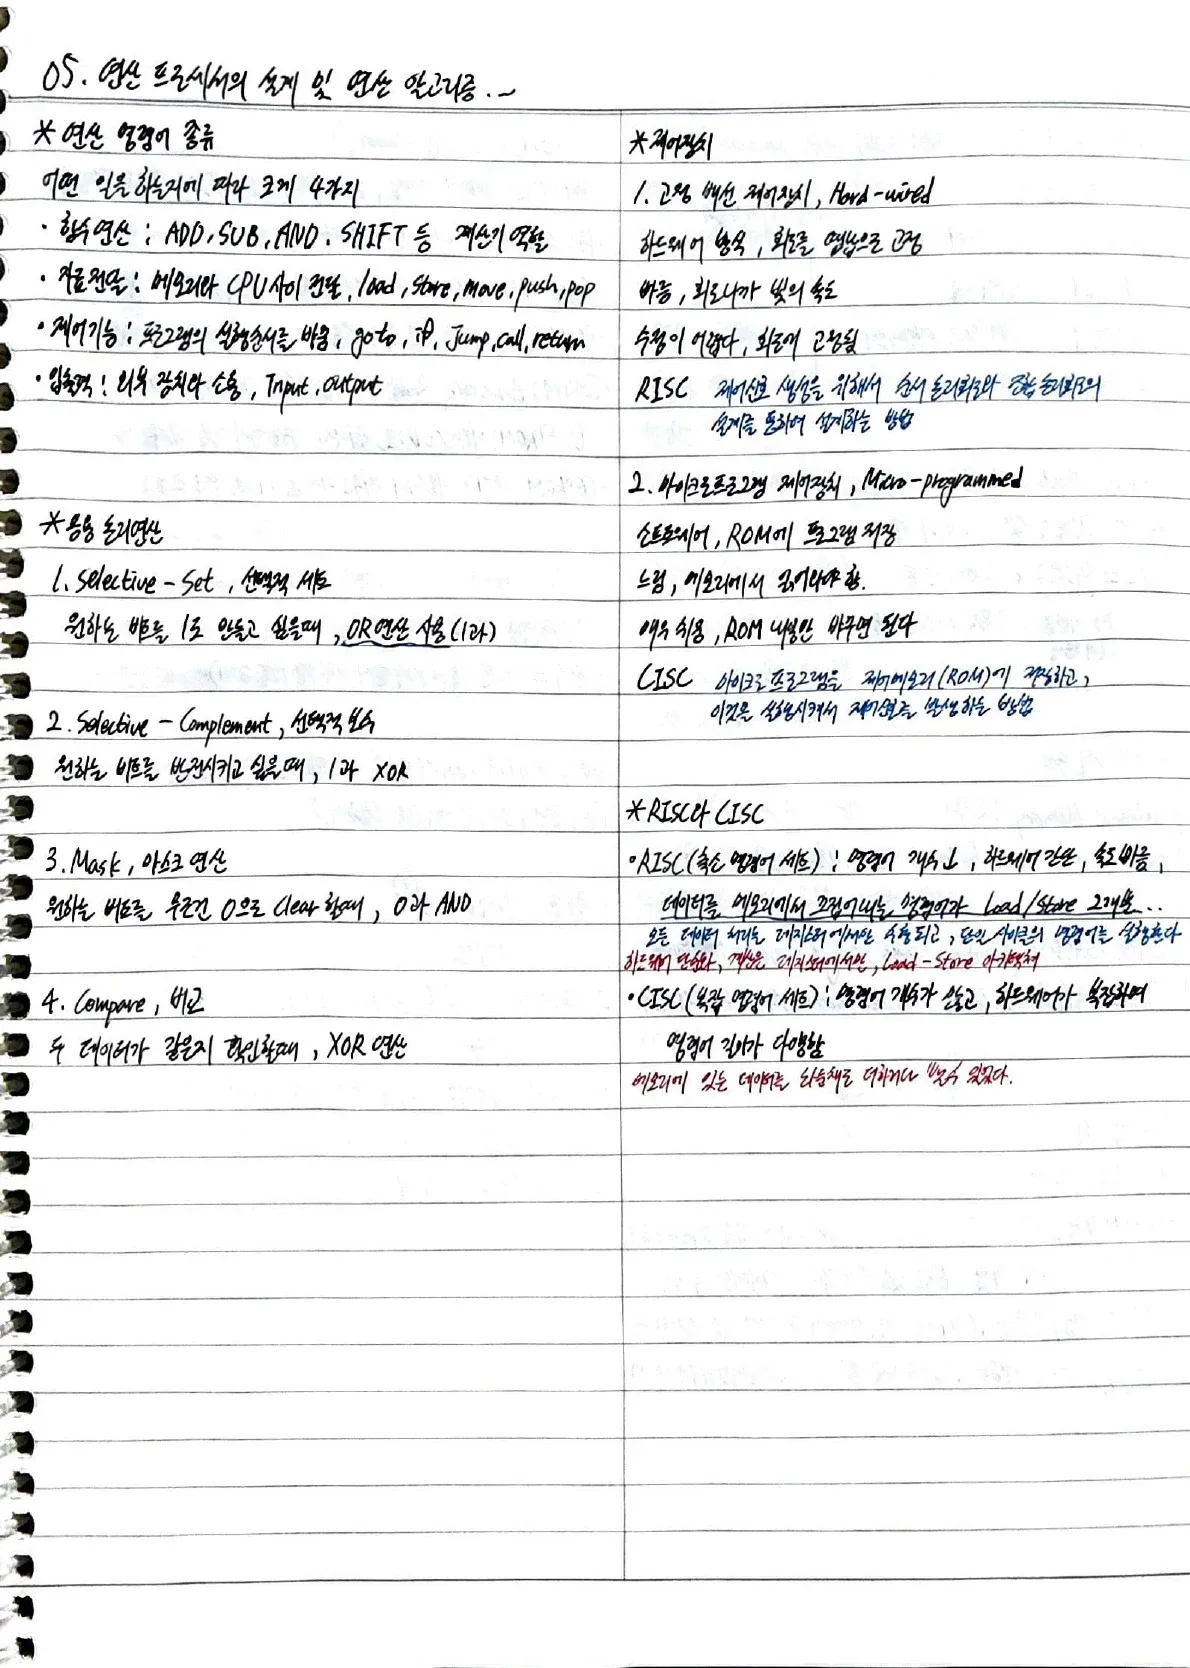
7. 연산 프로세서의 설계 및 연산 알고리즘
연선 명령어 종류
- 어떤 일을 하는지에 따라 크게 4가지
- 함수연산 : ADD ,SUB, AND ,SHIFT 등 계산기 역할
- 자료전달 : 메모리와 CPU사이 전달, load, store, move, push, pop
- 제어기능 : 프로그램의 실행순서를 바꿈, goto, if, jump, call, return
- 입출력 : 외부장치와 소통, input, output
응용 논리연산
- Selective-set, 선택적 세트
- 원하는 비트를 1로 만들고 싶을 때, OR연산 사용(1과)
- Selective-Complement, 선택적 보수
- 원하는 비트를 반전시키고 싶을 때, 1과 XOR
- MASK, 마스크 연산
- 원하는 비트를 무조건 0으로 Clear 할때, 0과 AND
- Complare, 비교
- 두 데이터가 같은지 확인할때, XOR 연산
제어장치
- 고정 배선 제어장치, hard-wired
- 하드웨어 방식, 회로를 땜납으로 고정
- 빠름
- 수정이 어렵다, 회로에 고정됨
- RISC
- 제어신호 생성을 위해서 순서 논리회로와 조합 논리회로의 설계를 통하여 설계하는 방법
- 마이크로프로그램 제어장치, Micro-Programmed
- 소프트웨어, ROM에 프로그램 저장
- 느림, 메모리에서 읽어와야 함
- 매우 쉬움, ROM 내용만 바꾸면 된다
- CISC
- 마이크로프로그램을 제어메모리(ROM)에 저장하고, 이것을 실행시켜서 제어신호를 발생하는 방법
RISC와 CISC
- RISC(축소 명령어 세트) - 하드웨어 단순화, 계산은 레지스터에서만, Load-Store 아키텍쳐
- 명령어 개수 적고
- 하드웨어 간단
- 속도 빠름
- 데이터를 메모리에서 끄집어내는 명령어가 Load/Store 2개뿐
- 모든 데이터 처리는 레지스터에서만 수행되고, 단일 사이클의 명령어를 실행한다
- CISC(복잡 명령어 세트) - 메모리에 있는 데이터를 놔둔채로 더하거나 뺄 수 있었다
- 명령어 개수 많고
- 하드웨어 복잡
- 명령어 길이가 다양
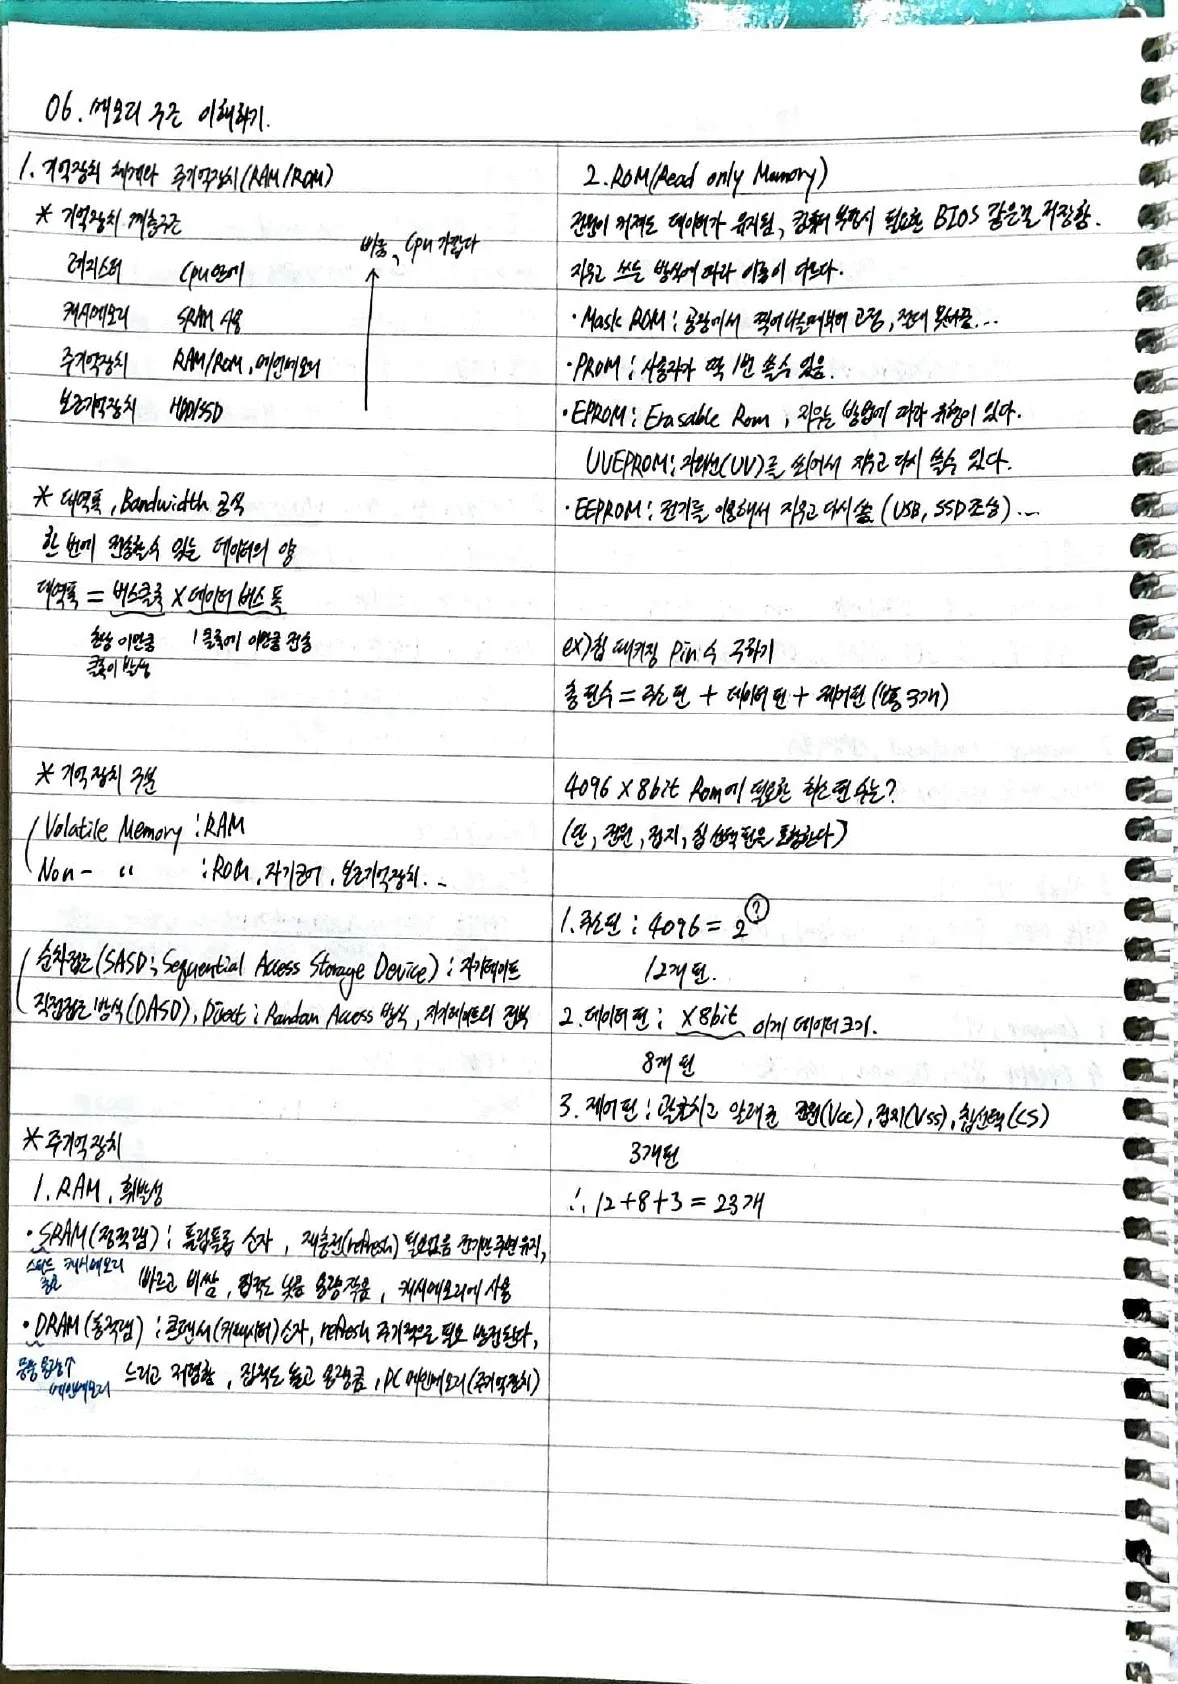
8. 메모리 구조 이해하기
기억장치 체계와 주기억장치(RAM/ROM)
- 기억장치 계층구조 - 위로갈수록 빠름,CPU 에 가깝다
- 레지스터 - CPU 안에
- 캐시메모리 - SRAM 사용
- 주기억장치 - RAM/ROM, 메인메모리
- 보조기억장치 - HDD/SSD
- 대역폭, Bandwidth 공식
- 한 번에 전송할수 있는 데이터의 양
- 대역폭 = 버스 클록(초당 이만큼 클록이 발생 ) * 데이터 버스 폭 (1 클록에 이만큼 전송)
- 기억장치 구분
- Volatile/Non-Volatile
- 휘발성 메모리 - RAM
- 비휘발성 메모리 - ROM, 자기코어, 보조기억장치
- 순차/직접
- 순차접근, SASD;Sequential Access Storage Device - 자기테이프
- 직접접근방식, DASD;Direct - Random Access 방식, 자기테이프 외 전부
- Volatile/Non-Volatile
- 주기억장치
- RAM, 휘발성
- SRAM (정적 램) - 스피드 중요 캐시메모리
- 플립플롭 소자
- 재충전 refresh 필요없음 전기만 주면 유지
- 빠르고 비쌈
- 집적도 낮음 용량 작음
- 캐시메모리에 사용
- DRAM (동적 램) - 뚱뚱 용량 큼 메인메모리
- 콘덴서(캐패시터) 소자
- refresh 주기적으로 필요함 방전된다
- 느리고 저렴함
- 집적도 높고 용량큼
- PC 메인메모리(주기억장치)
- SRAM (정적 램) - 스피드 중요 캐시메모리
- ROM, Read only Memory
- 전원이 꺼져도 데이터가 유지됨, 컴퓨터 부팅시 필요한 BIOS 같은걸 저장함.
- 지우고 쓰는 방식에 따라 이름이 다르다
- 종류
- Mask ROM : 공장에서 찍어 나올때부터 고정, 절대 못바꿈
- PROM : 사용자가 딱 한번 쓸 수 있음, Programable
- EPROM : Erasable Rom, 지우는 방법에 따라 유형이 있다
- UVEPROM : 자외선(UV)를 쐬어서 지우고 다시 쓸 수 있다
- EEPROM : 전기를 이용해서 지우고 다시 씀(USB, SSD 조상)
- 예시 문제 - 칩 패키징 Pin 수 구하기
- 총 핀수 = 주소 핀 + 데이터 핀 + 제어 핀 (보통 3개)
- 4096 x 8bit Rom 에 필요한 최소 핀 수는? (단 전원, 접지, 칩 선택 핀을 포함한다)
- 주소 핀 : 4096 = 2^12, 12개 핀
- 데이터 핀 : 8bit가 데이터 크기, 8개 핀
- 제어핀 : 괄호치고 알려준 3개 핀
- 그러므로 합치면 23개
- RAM, 휘발성
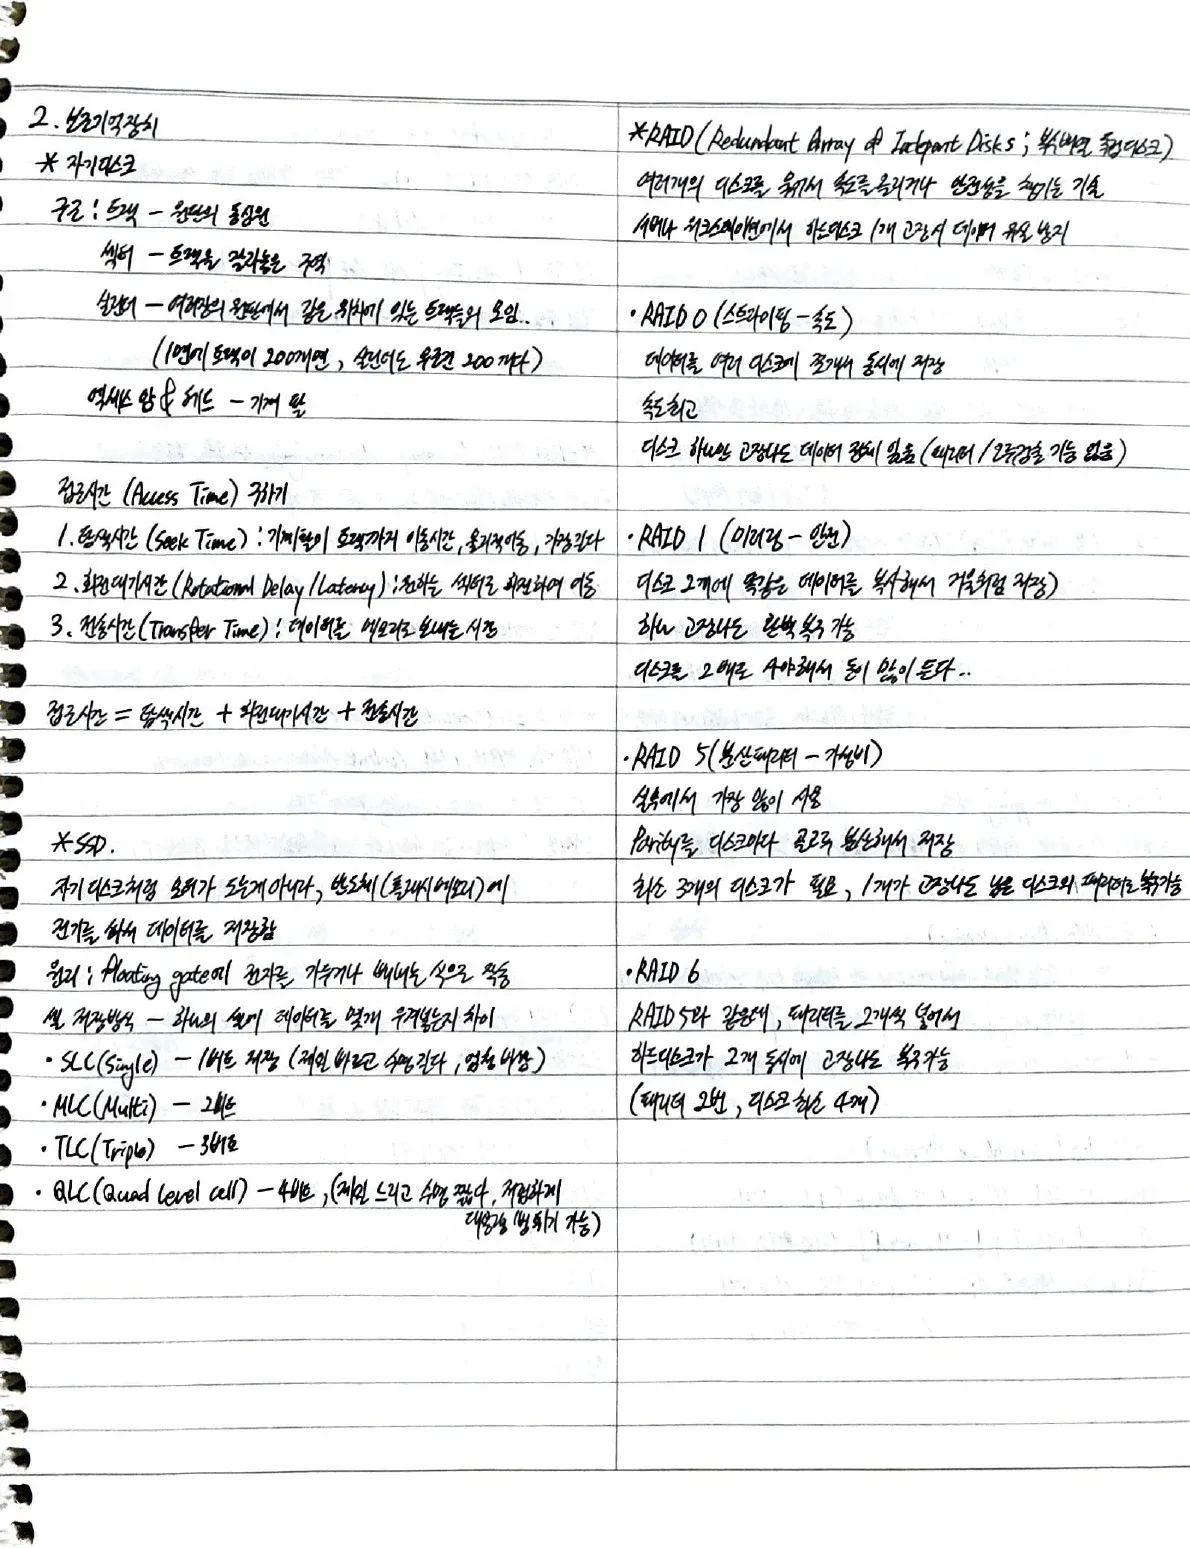
보조기억장치
- 자기디스크
- 구조
- 트랙 - 원판 동심원
- 섹터 - 트랙을 잘라놓은 구역
- 실린더 - 여러개의 원판에서 같은 위치에 있는 트랙들의 모임 (1면에 트랙이 200개면, 실린더도 무조건 200개다)
- 엑세스암 & 헤드 - 기계 팔
- 접근시간 Access Time 구하기
- 탐색시간 Seek Time : 기계 팔이 트랙까지 이동시간, 물리적이동, 가장 길다
- 회전대기시간 Rotational Delay/Latency : 원하는 섹터로 회전하여 이동
- 전송시간 Transfer Time : 데이터를 메모리로 보내는 시간
- 접근시간 = 탐색시간 + 회전대기시간 + 전송시간
- 구조
- SSD
- 자기디스크처럼
타이핑 치다가 시험보러감…
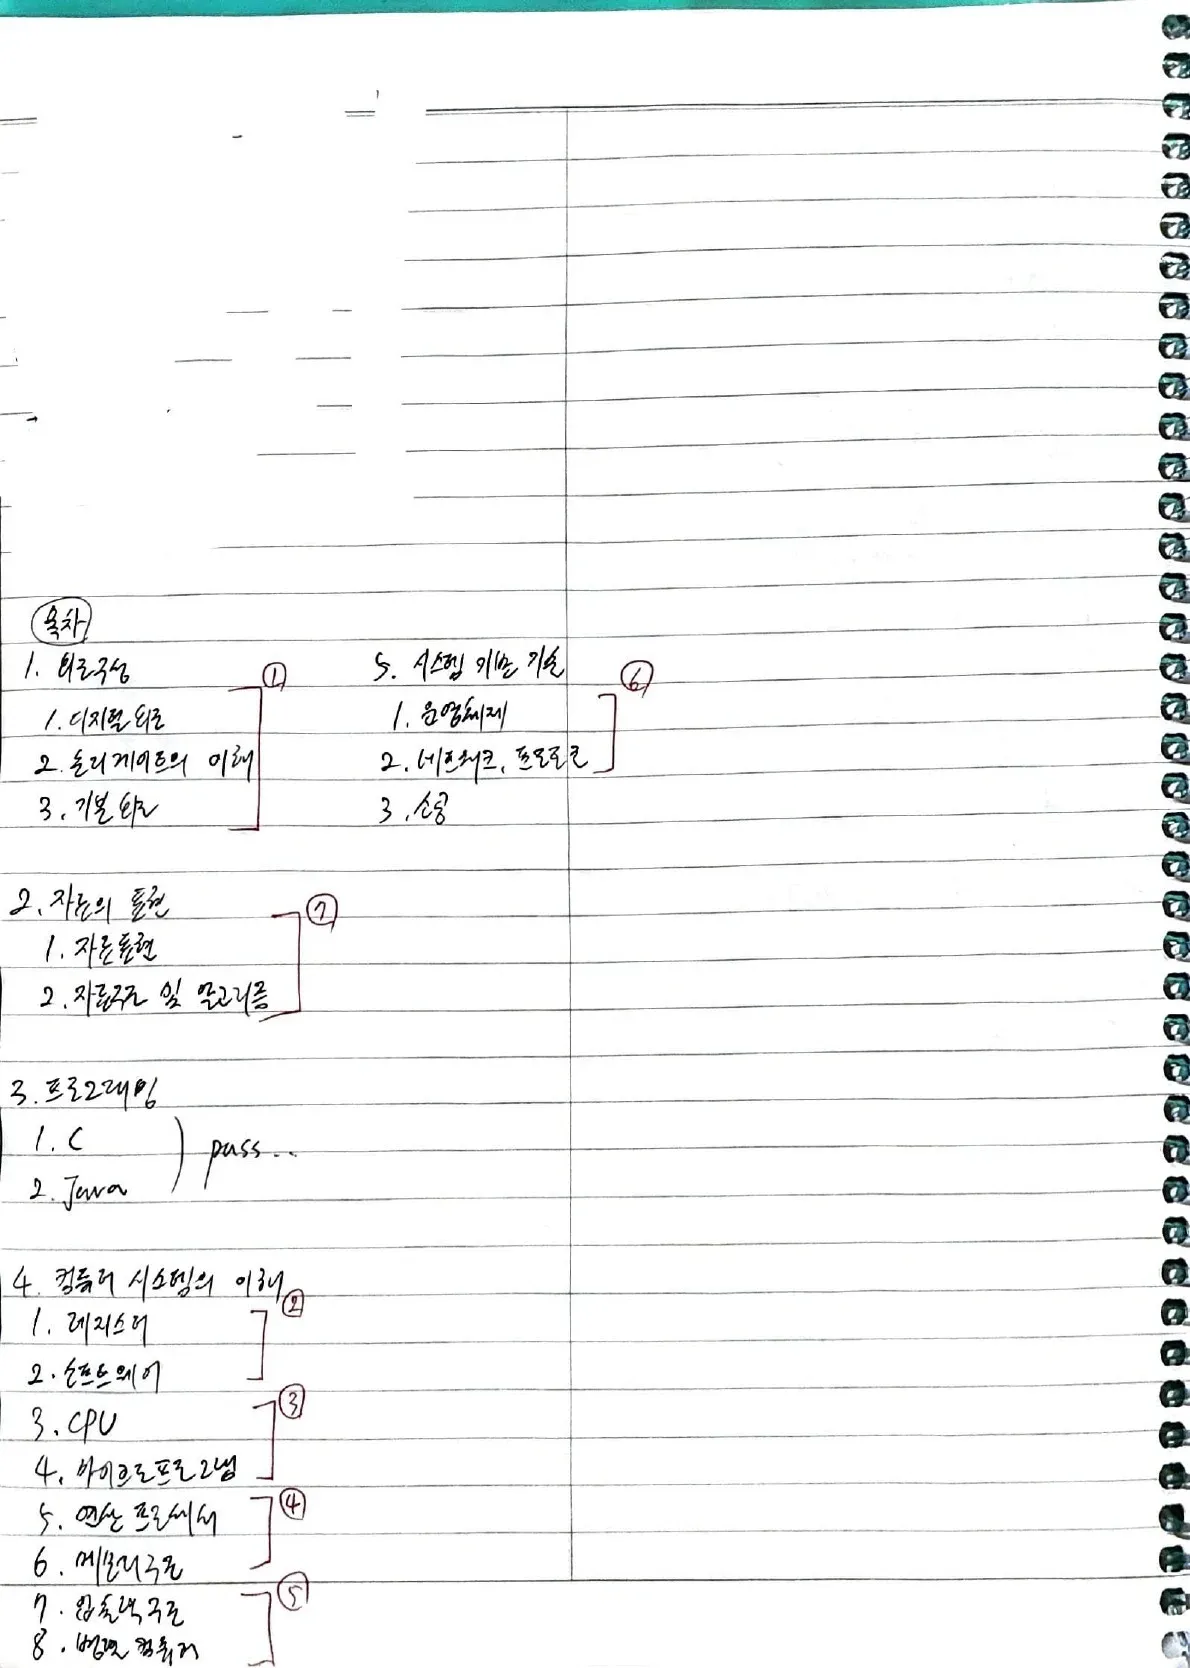
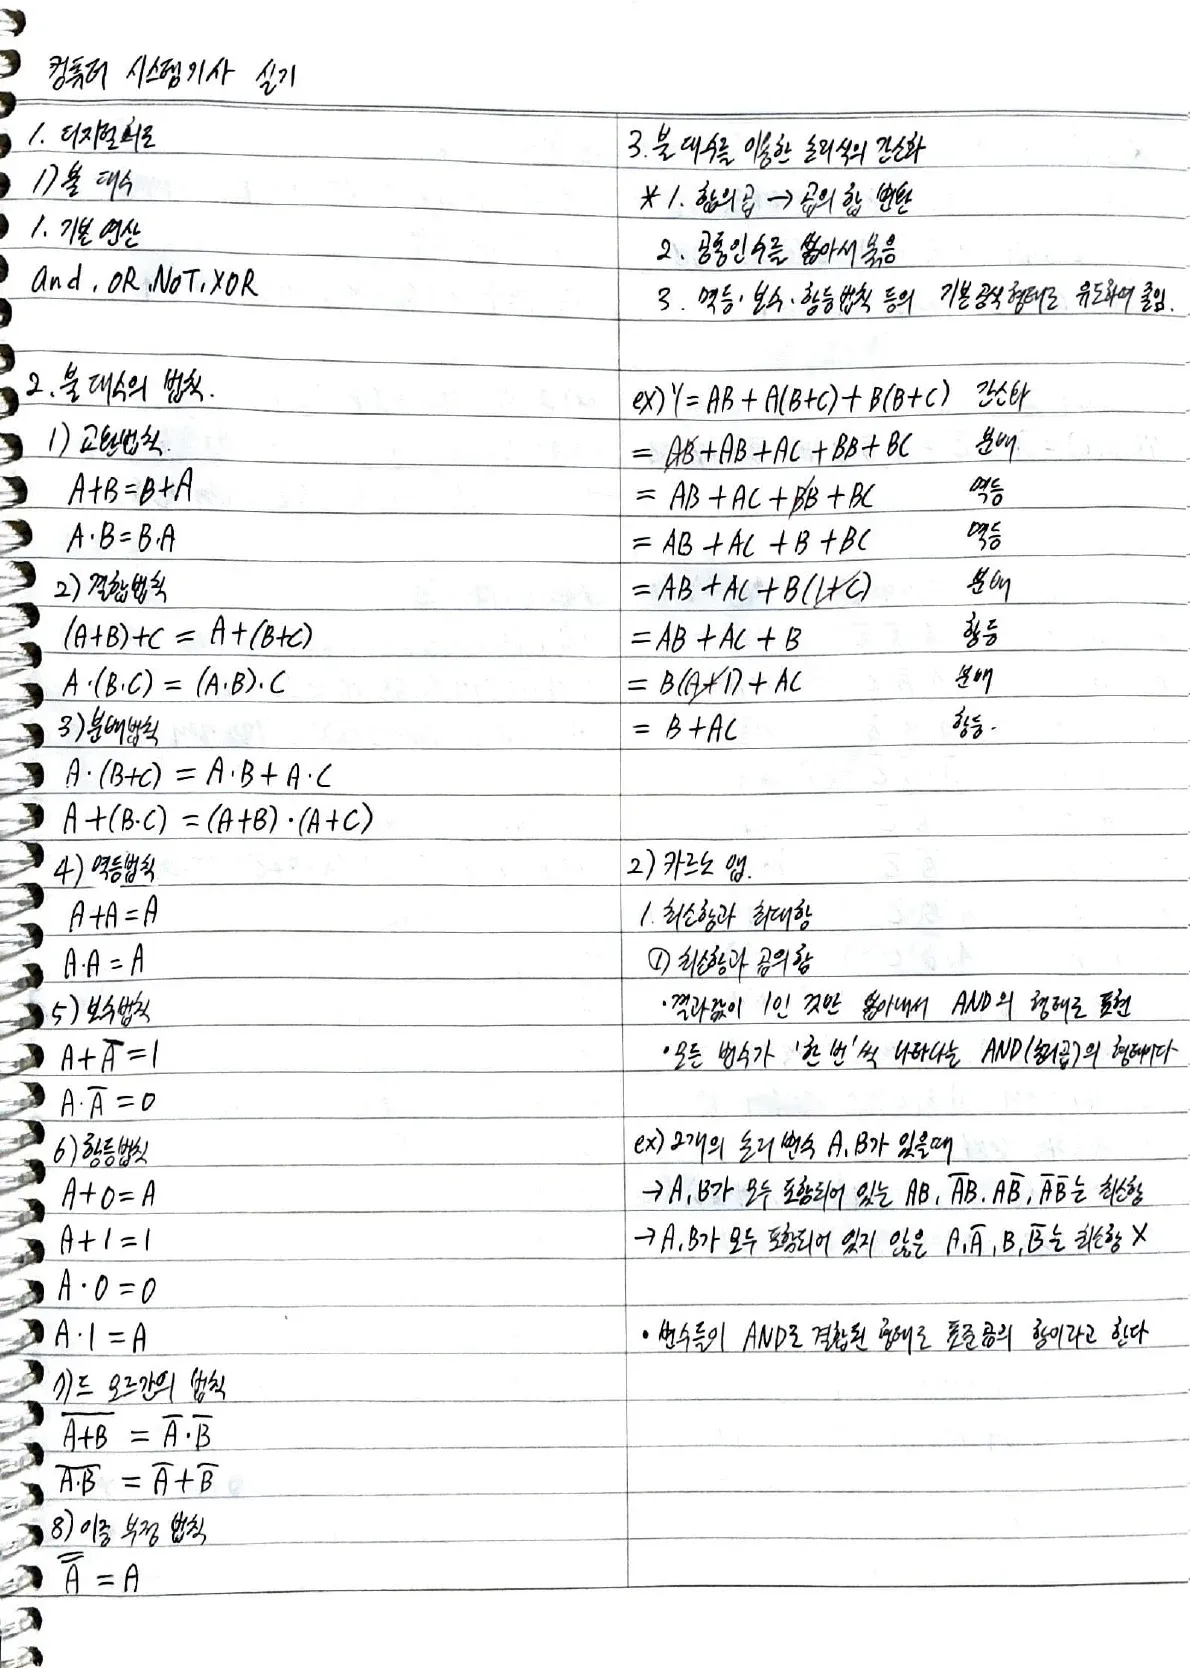
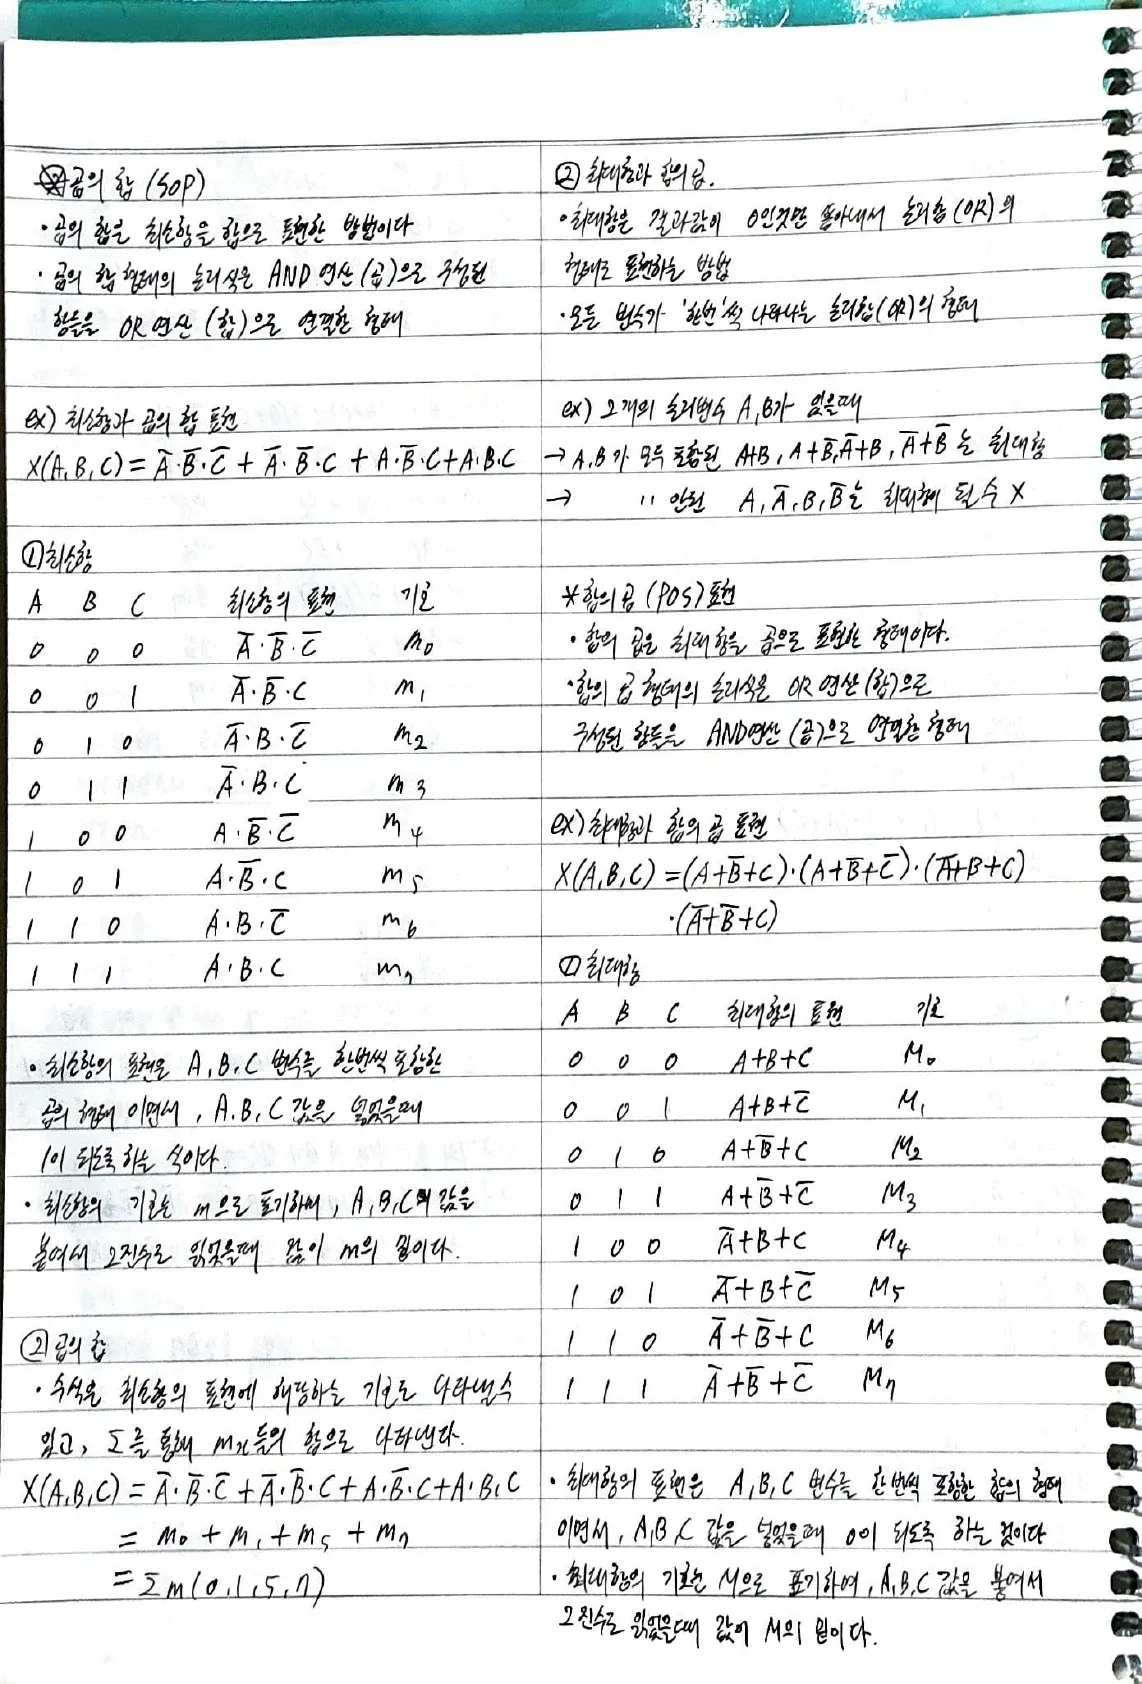
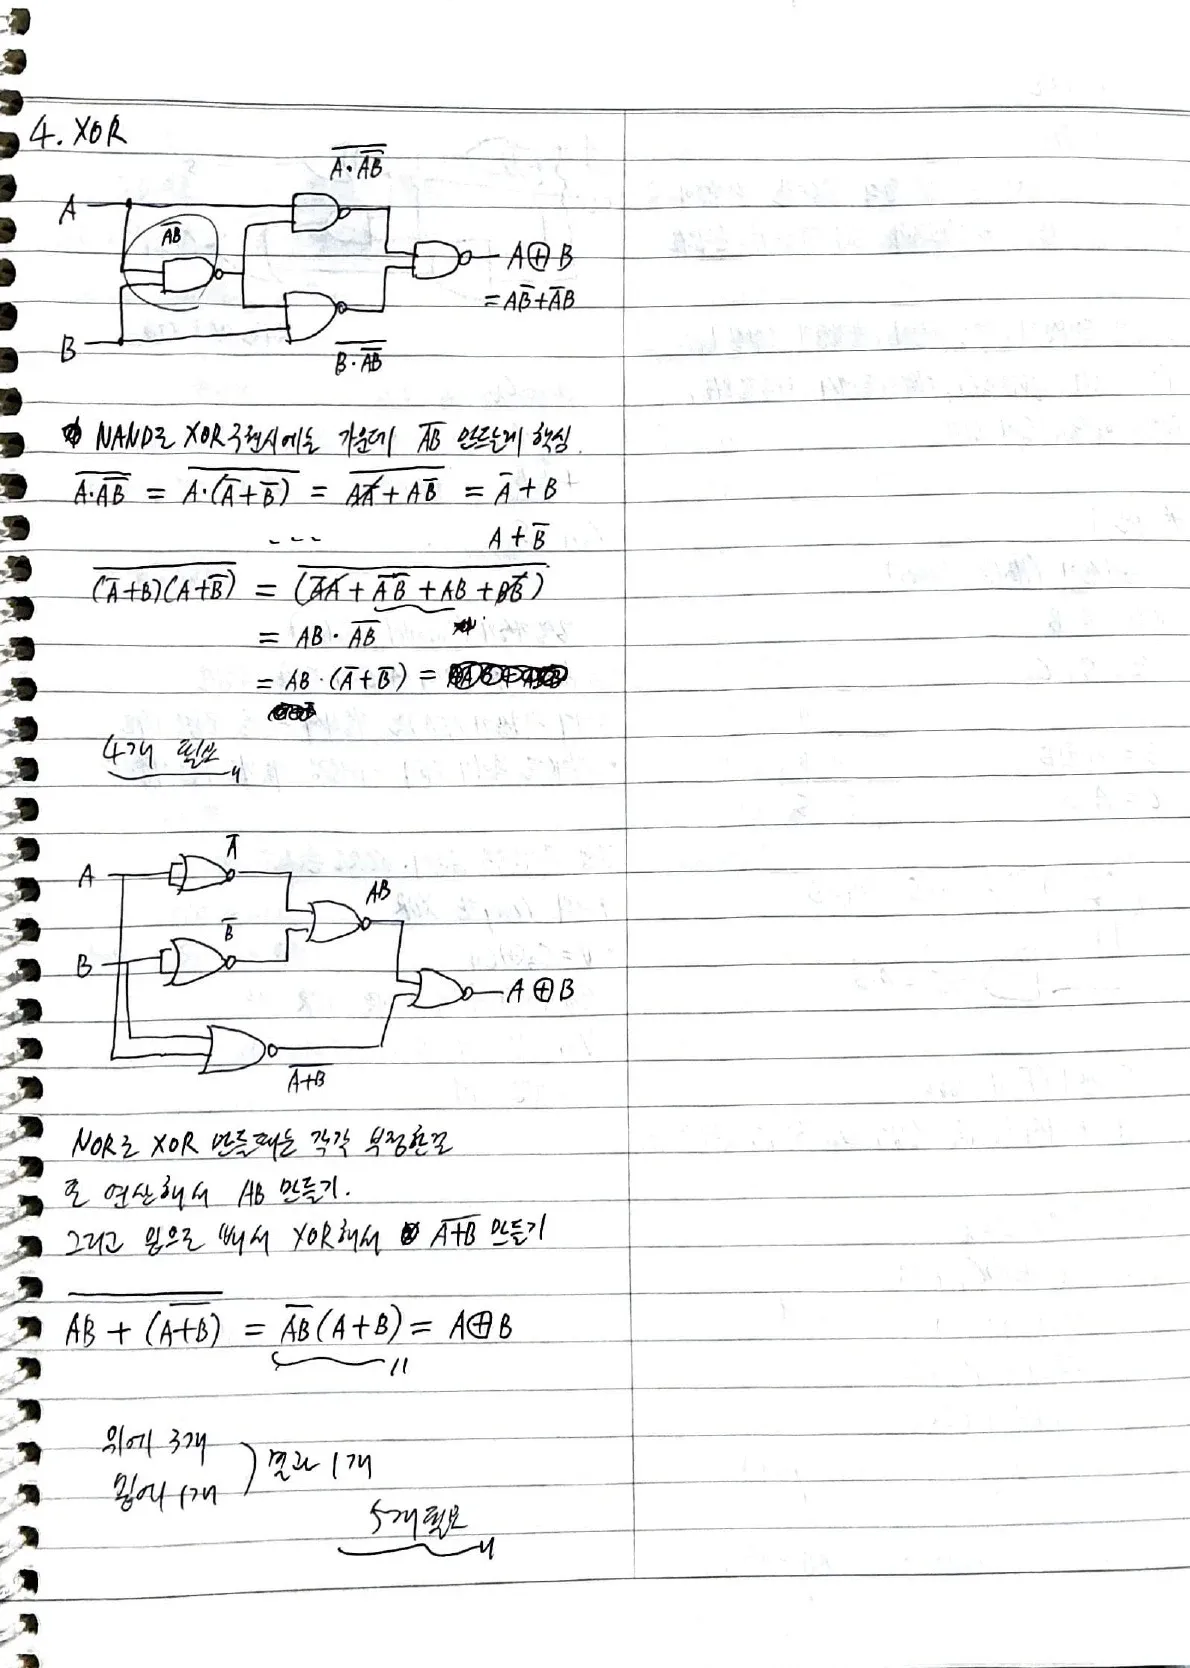
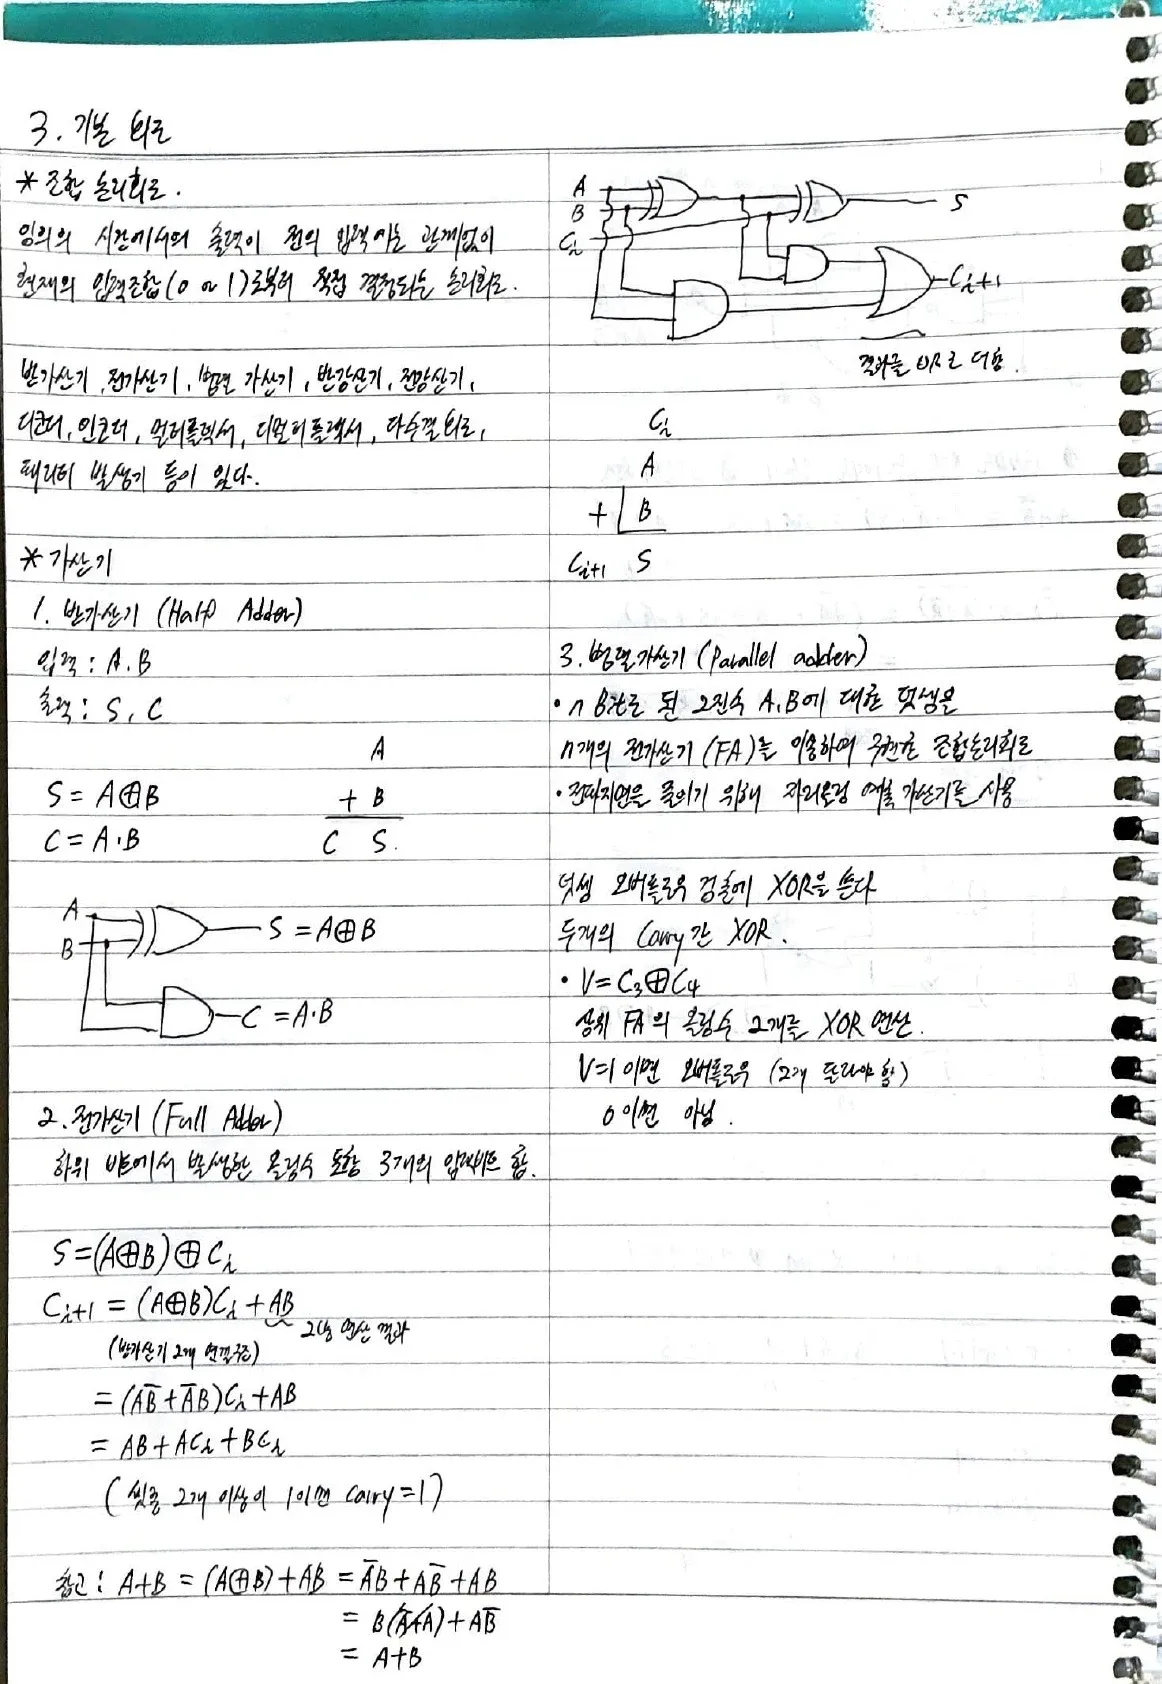
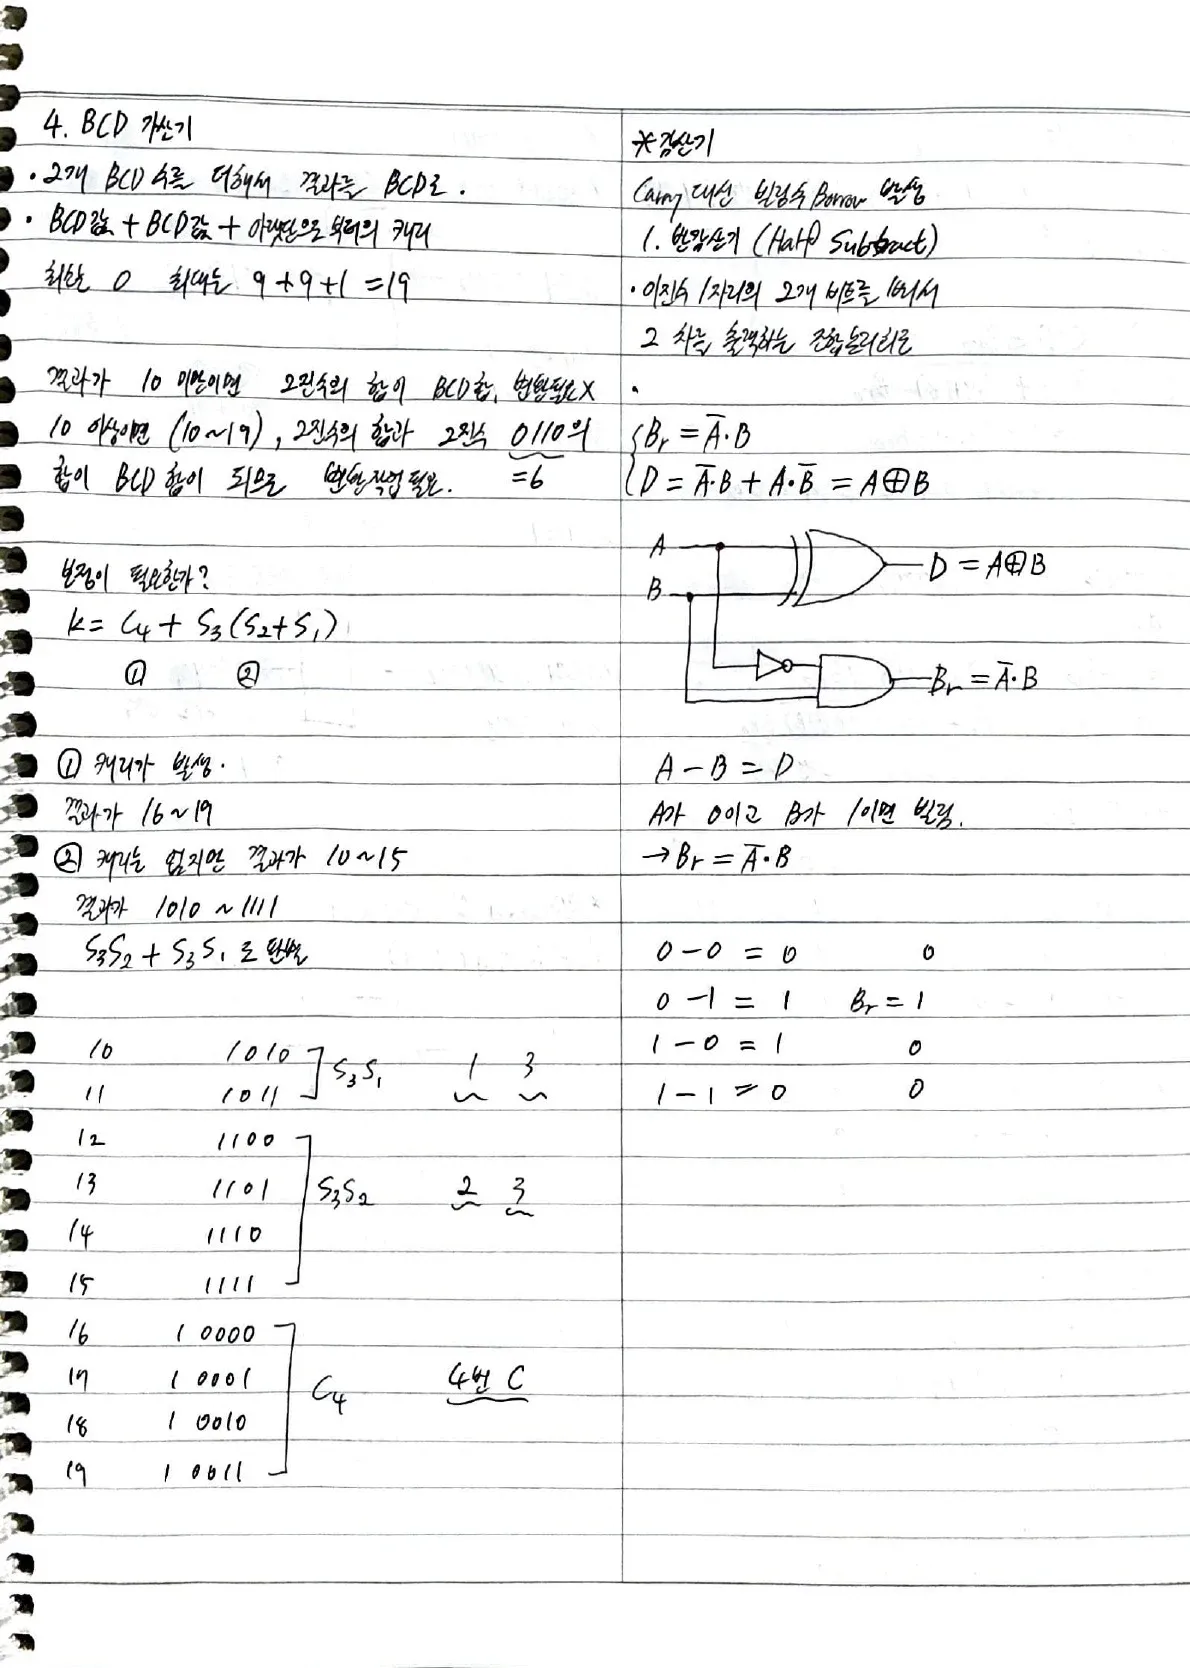
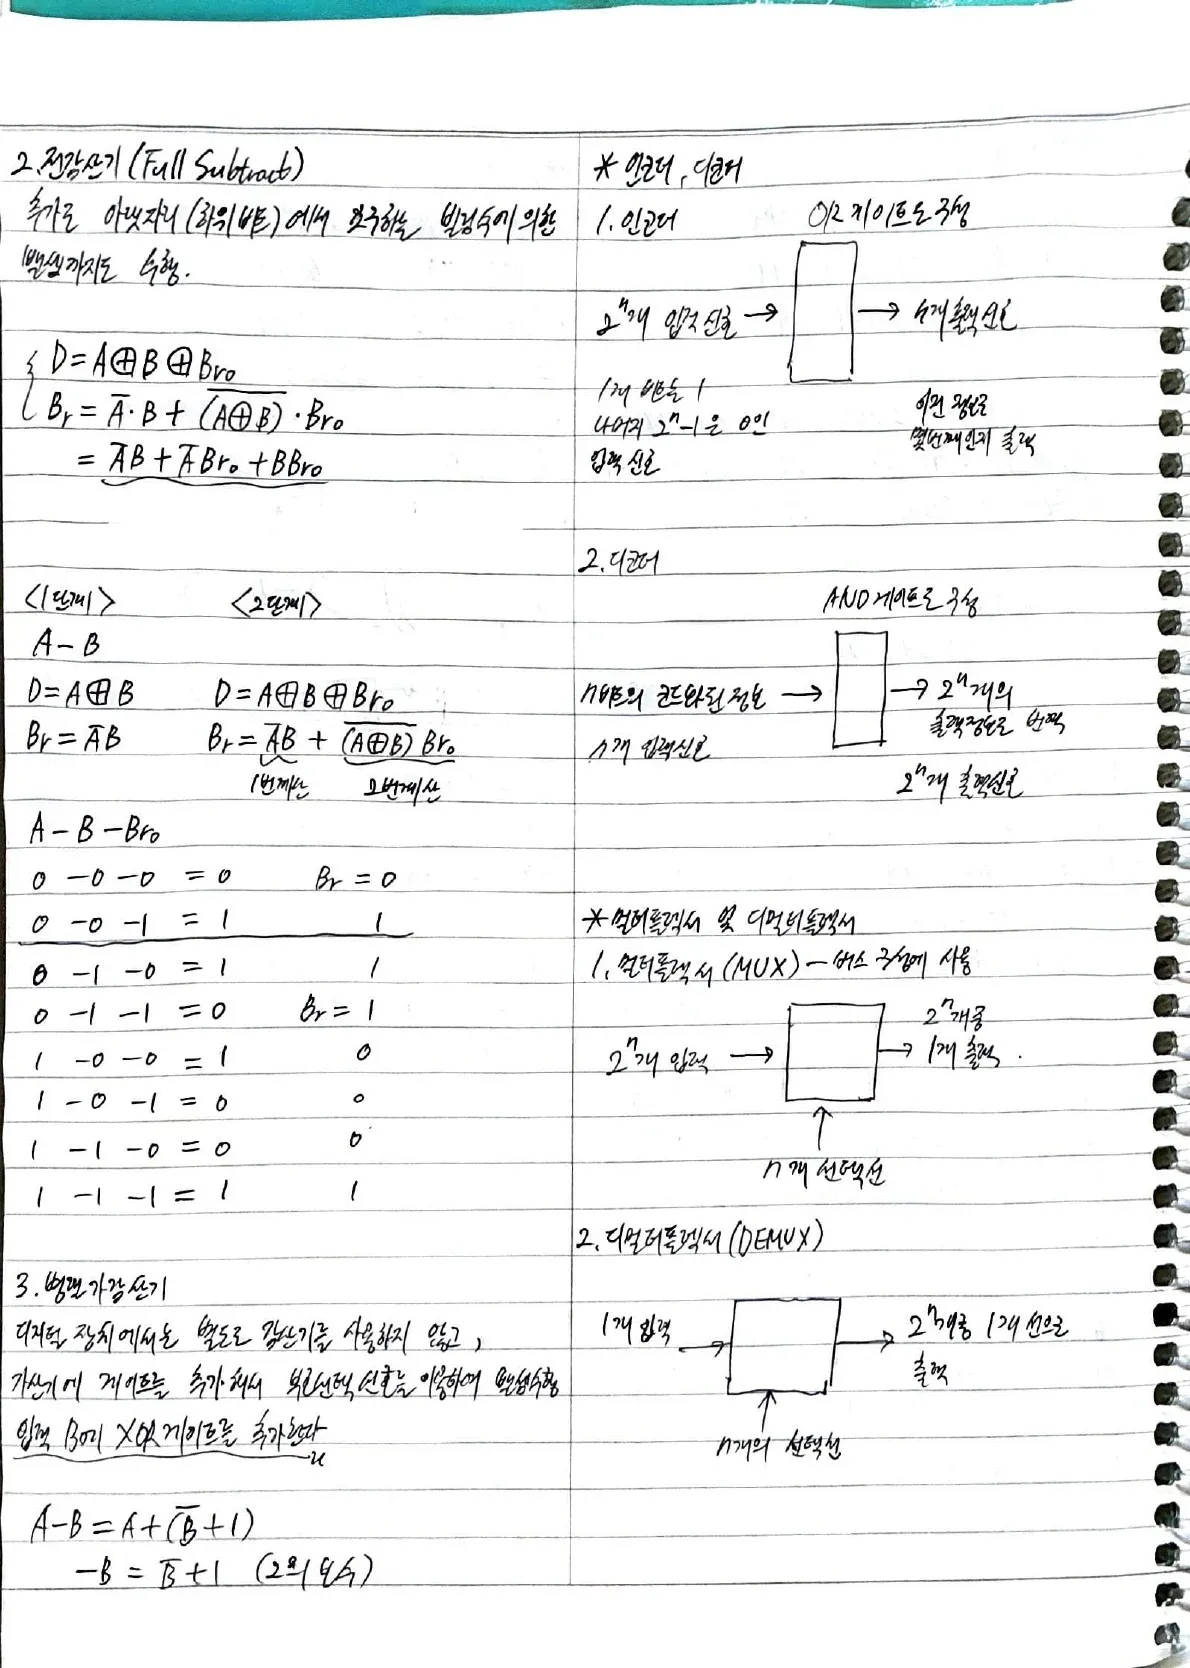
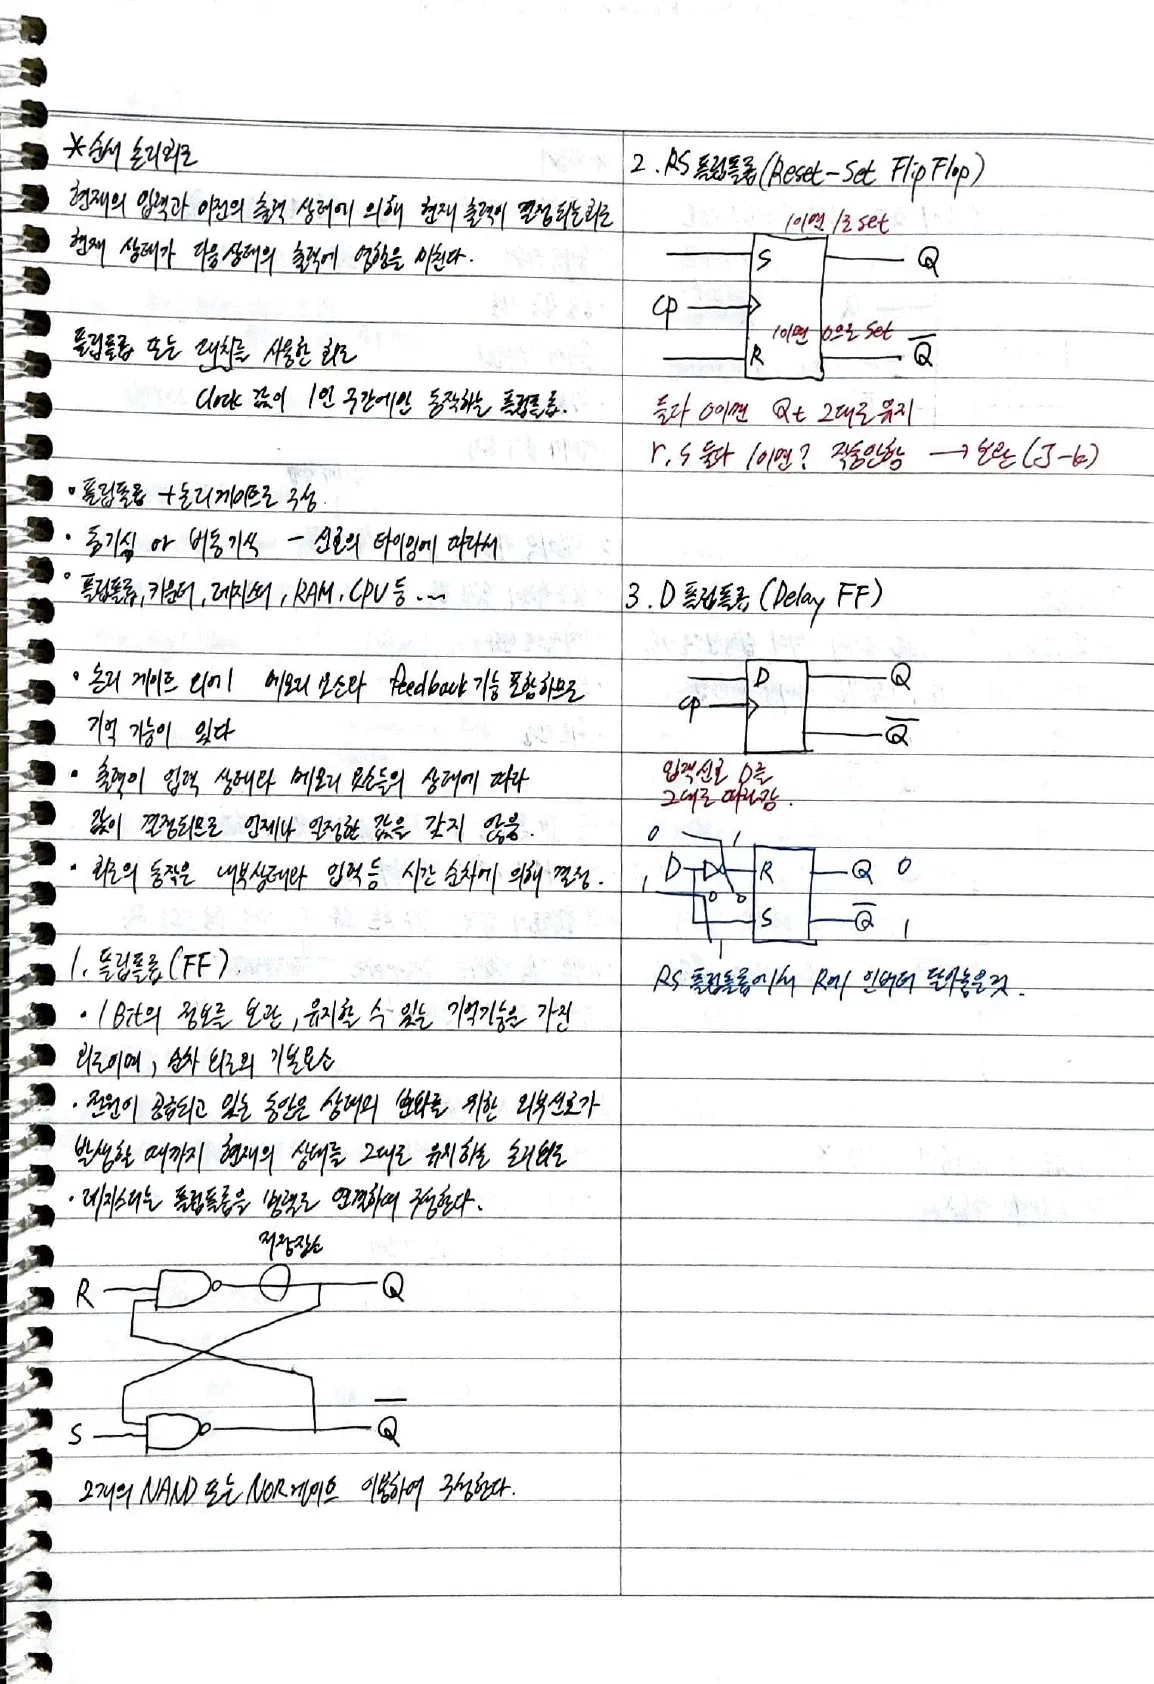
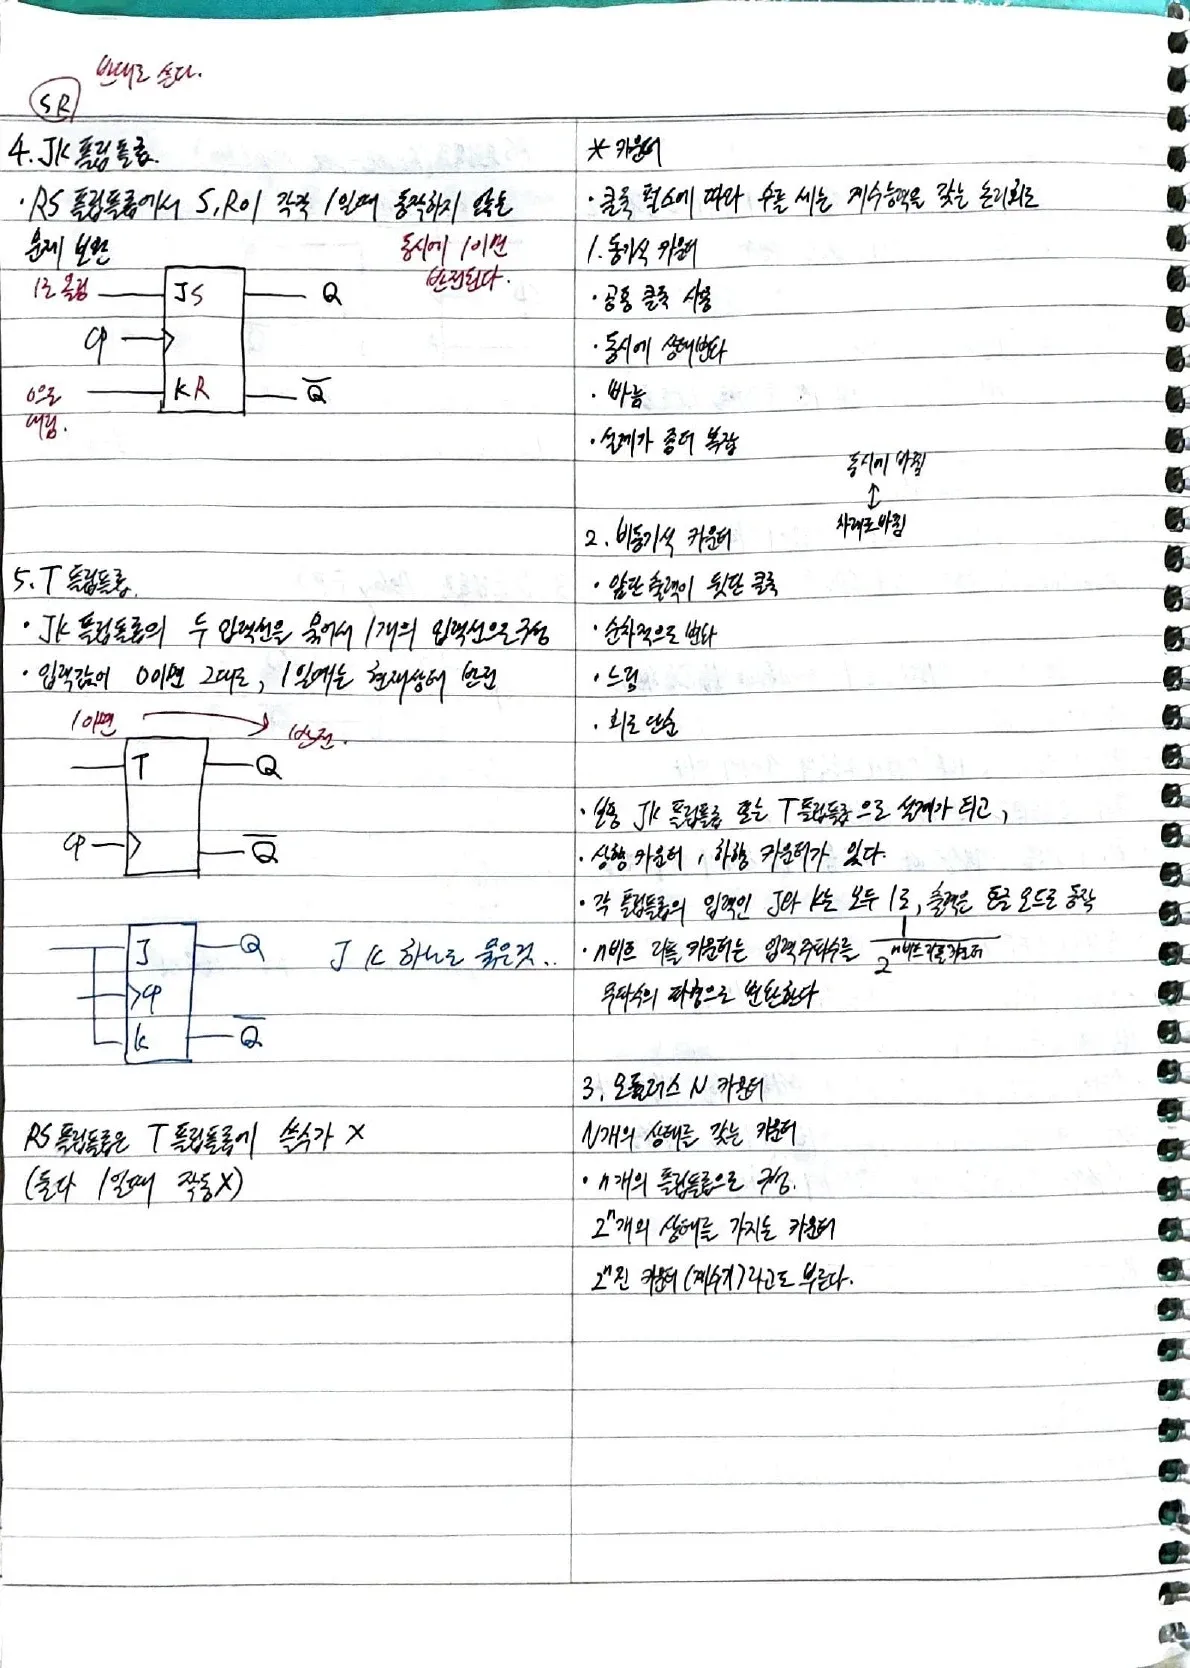
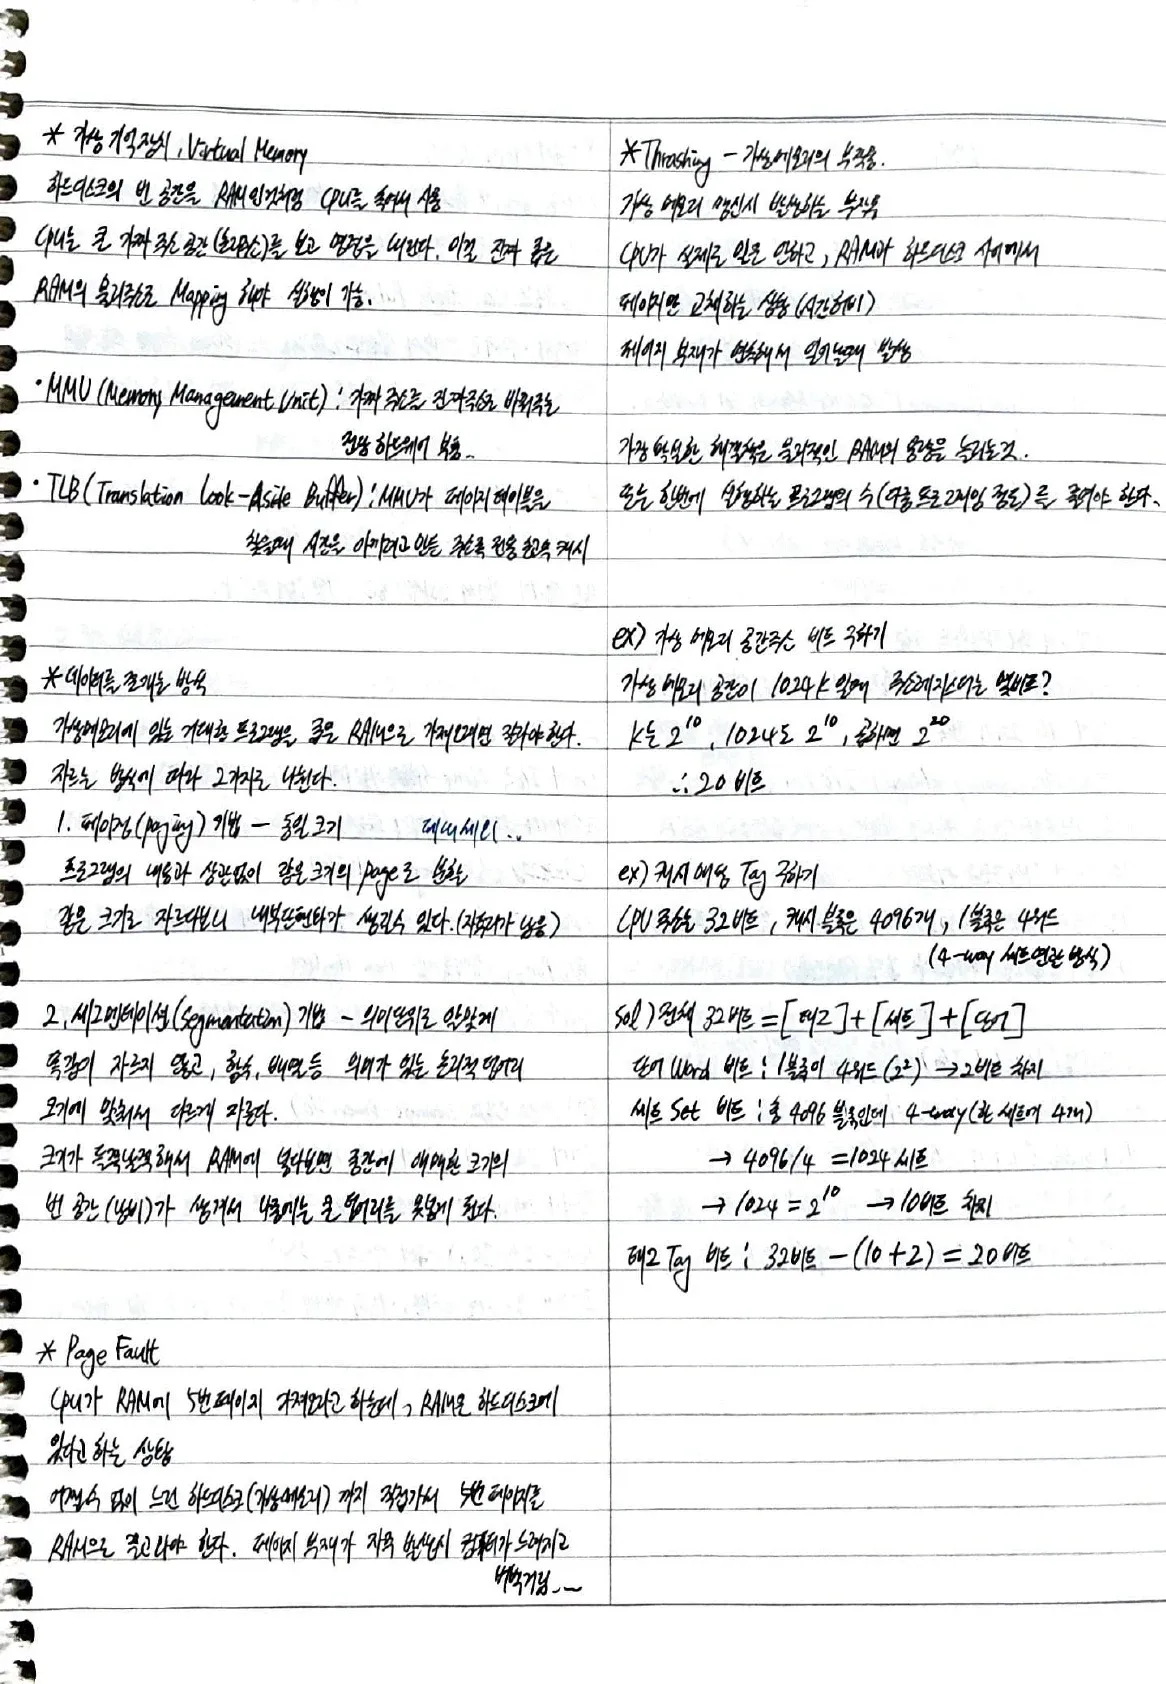
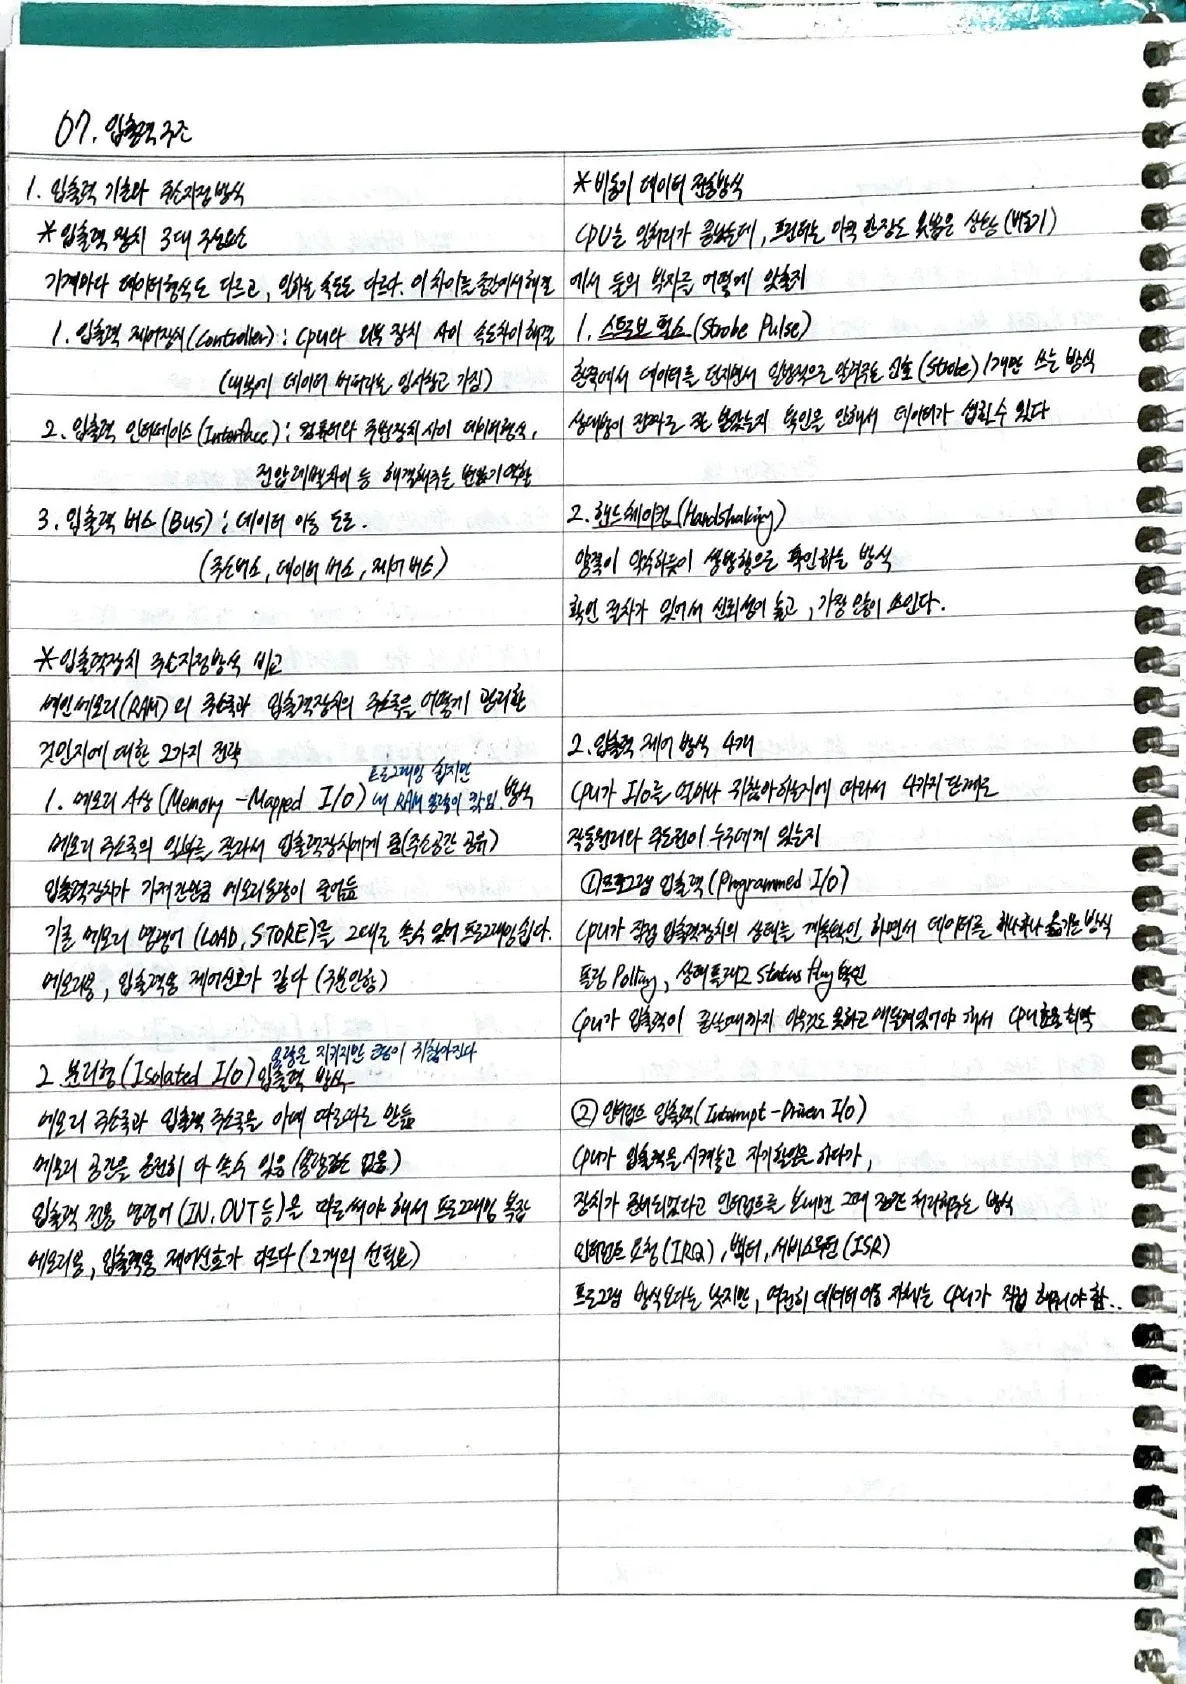
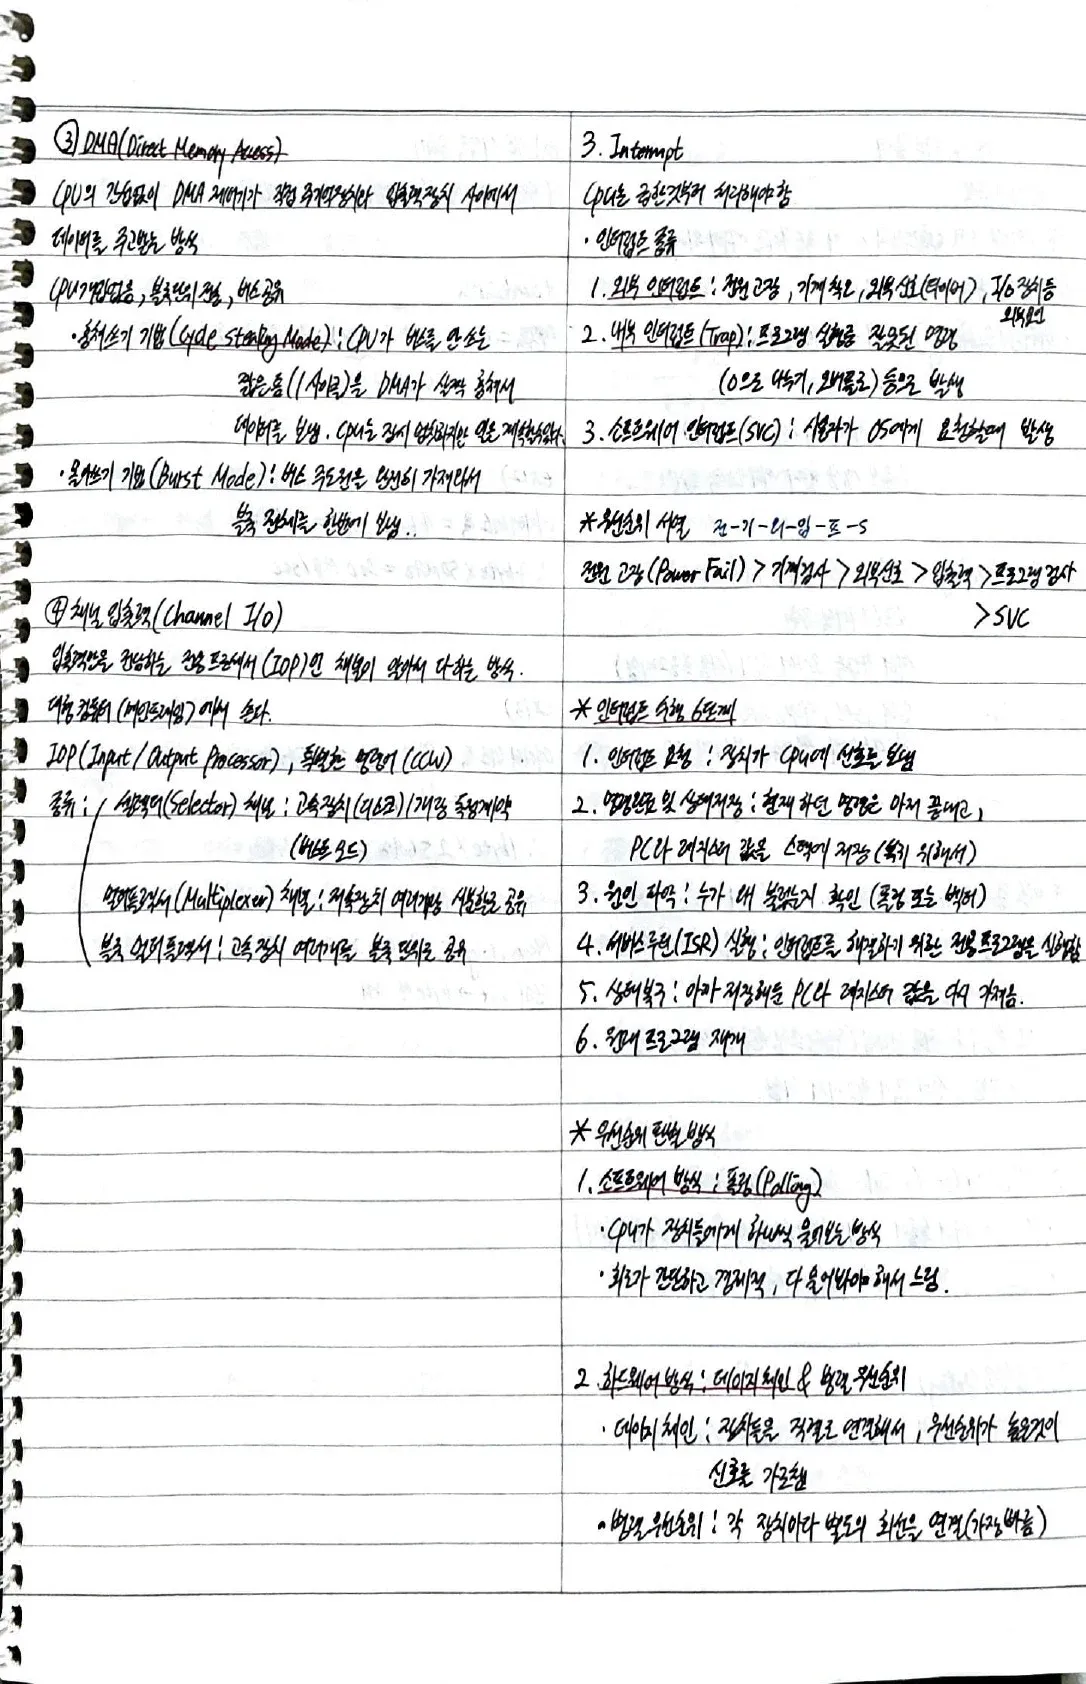
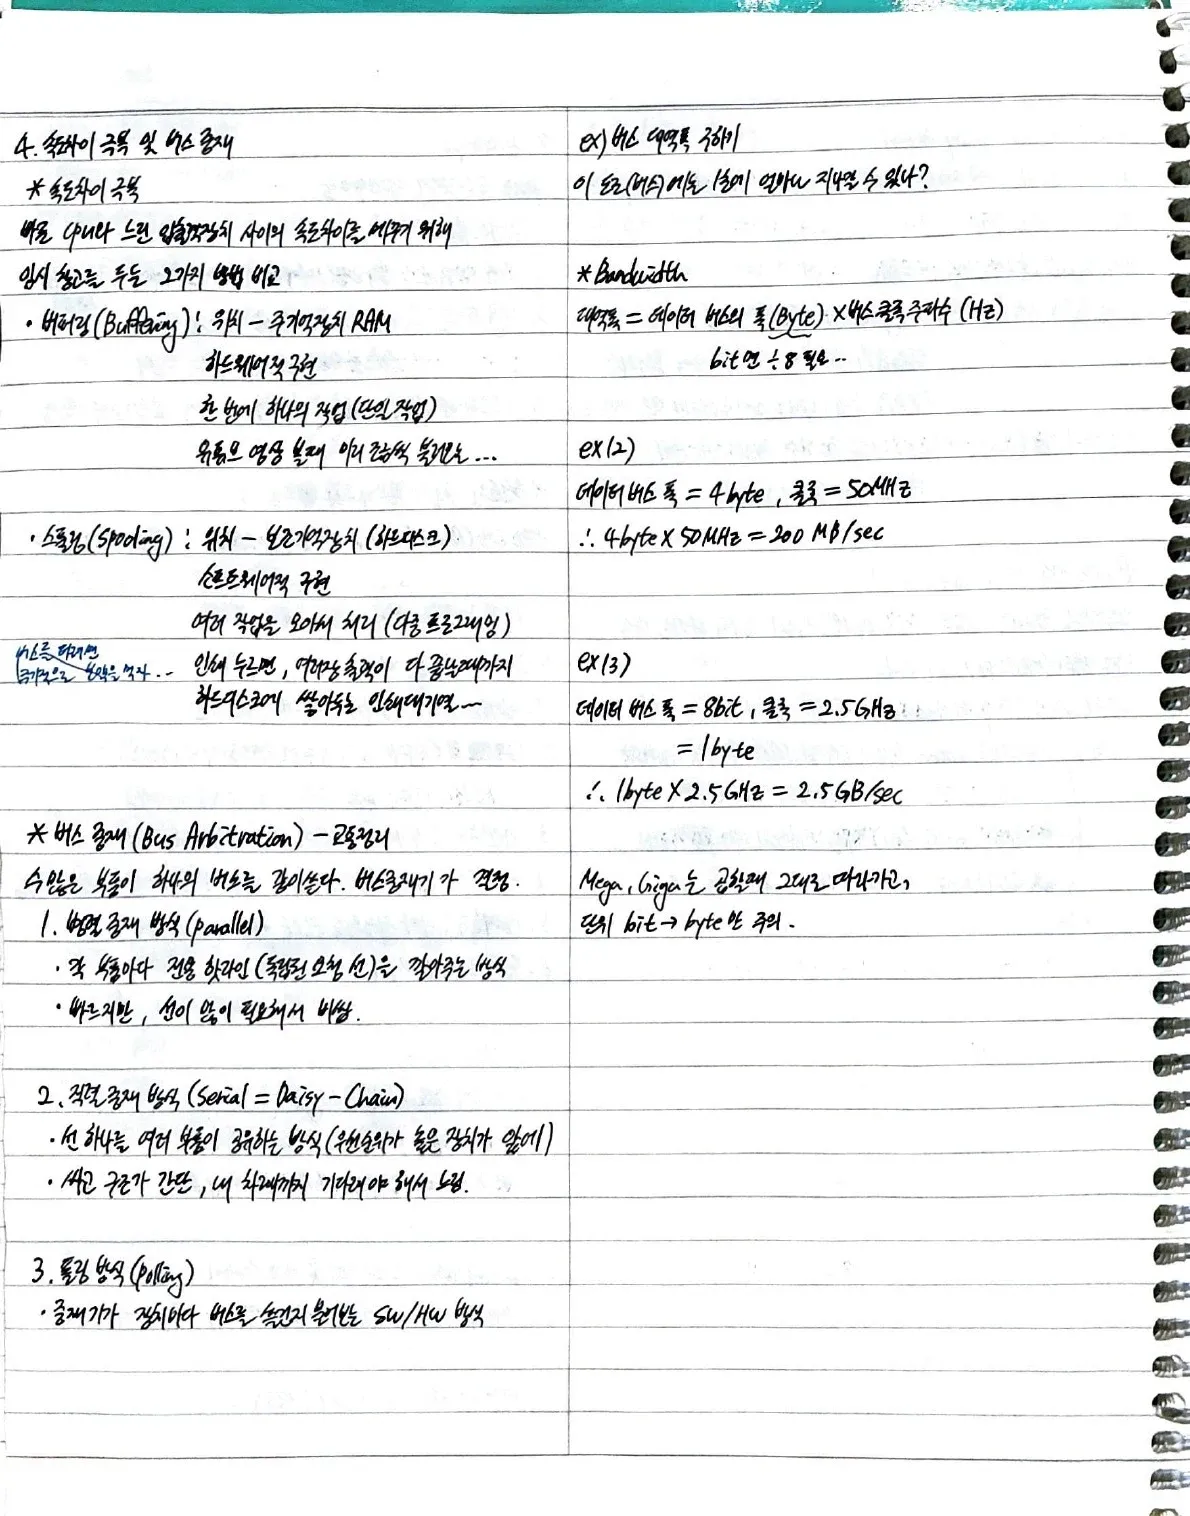
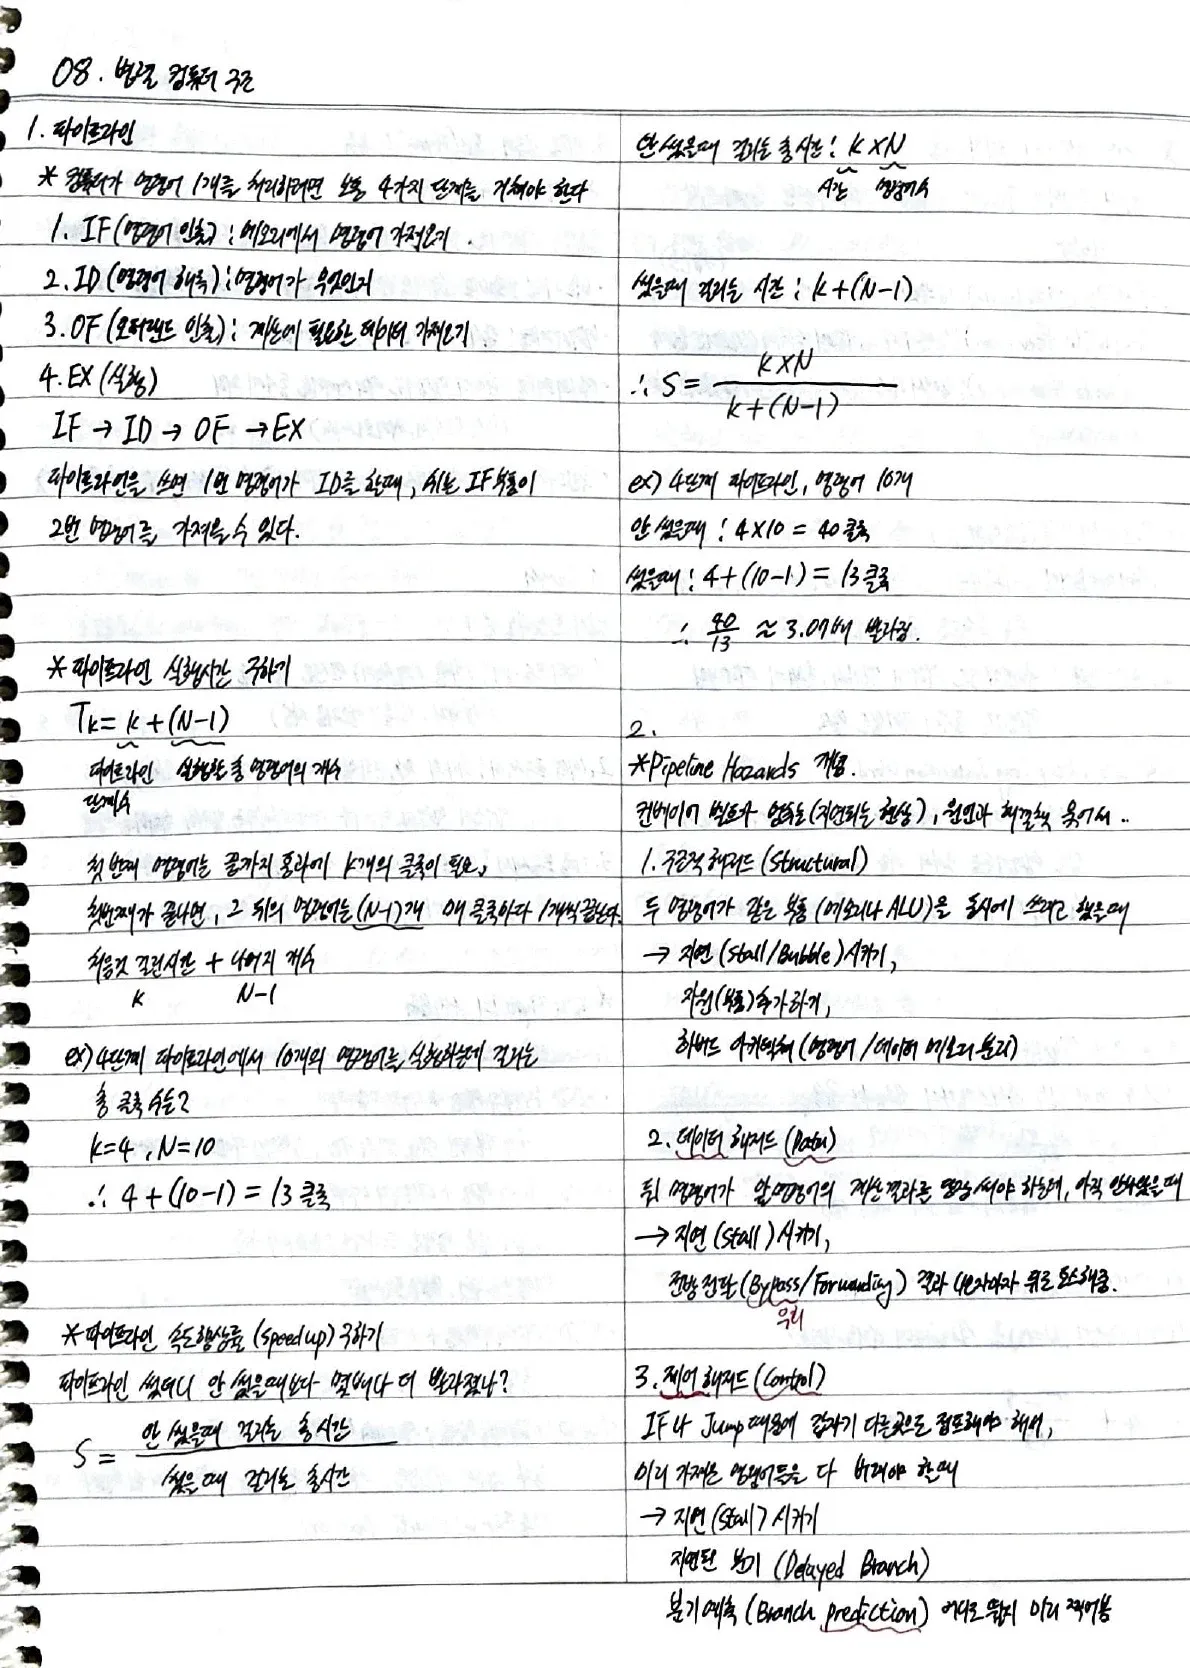
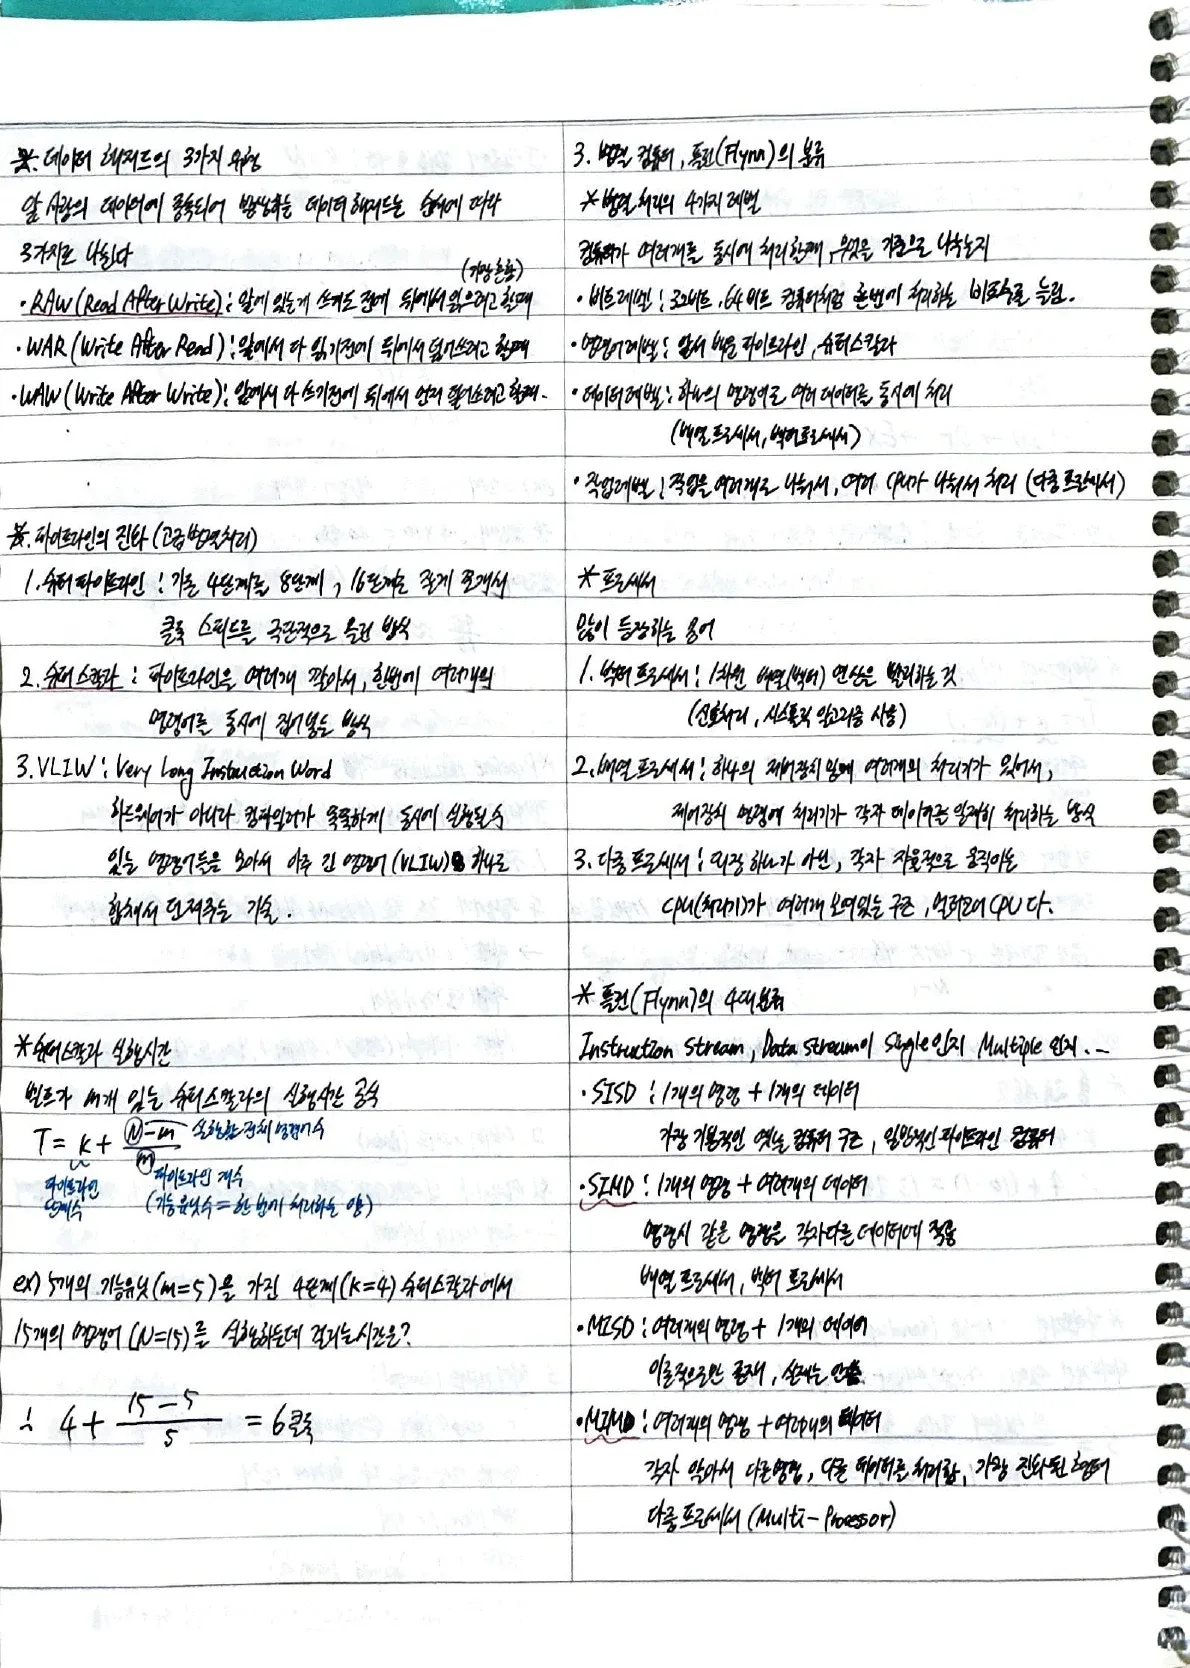
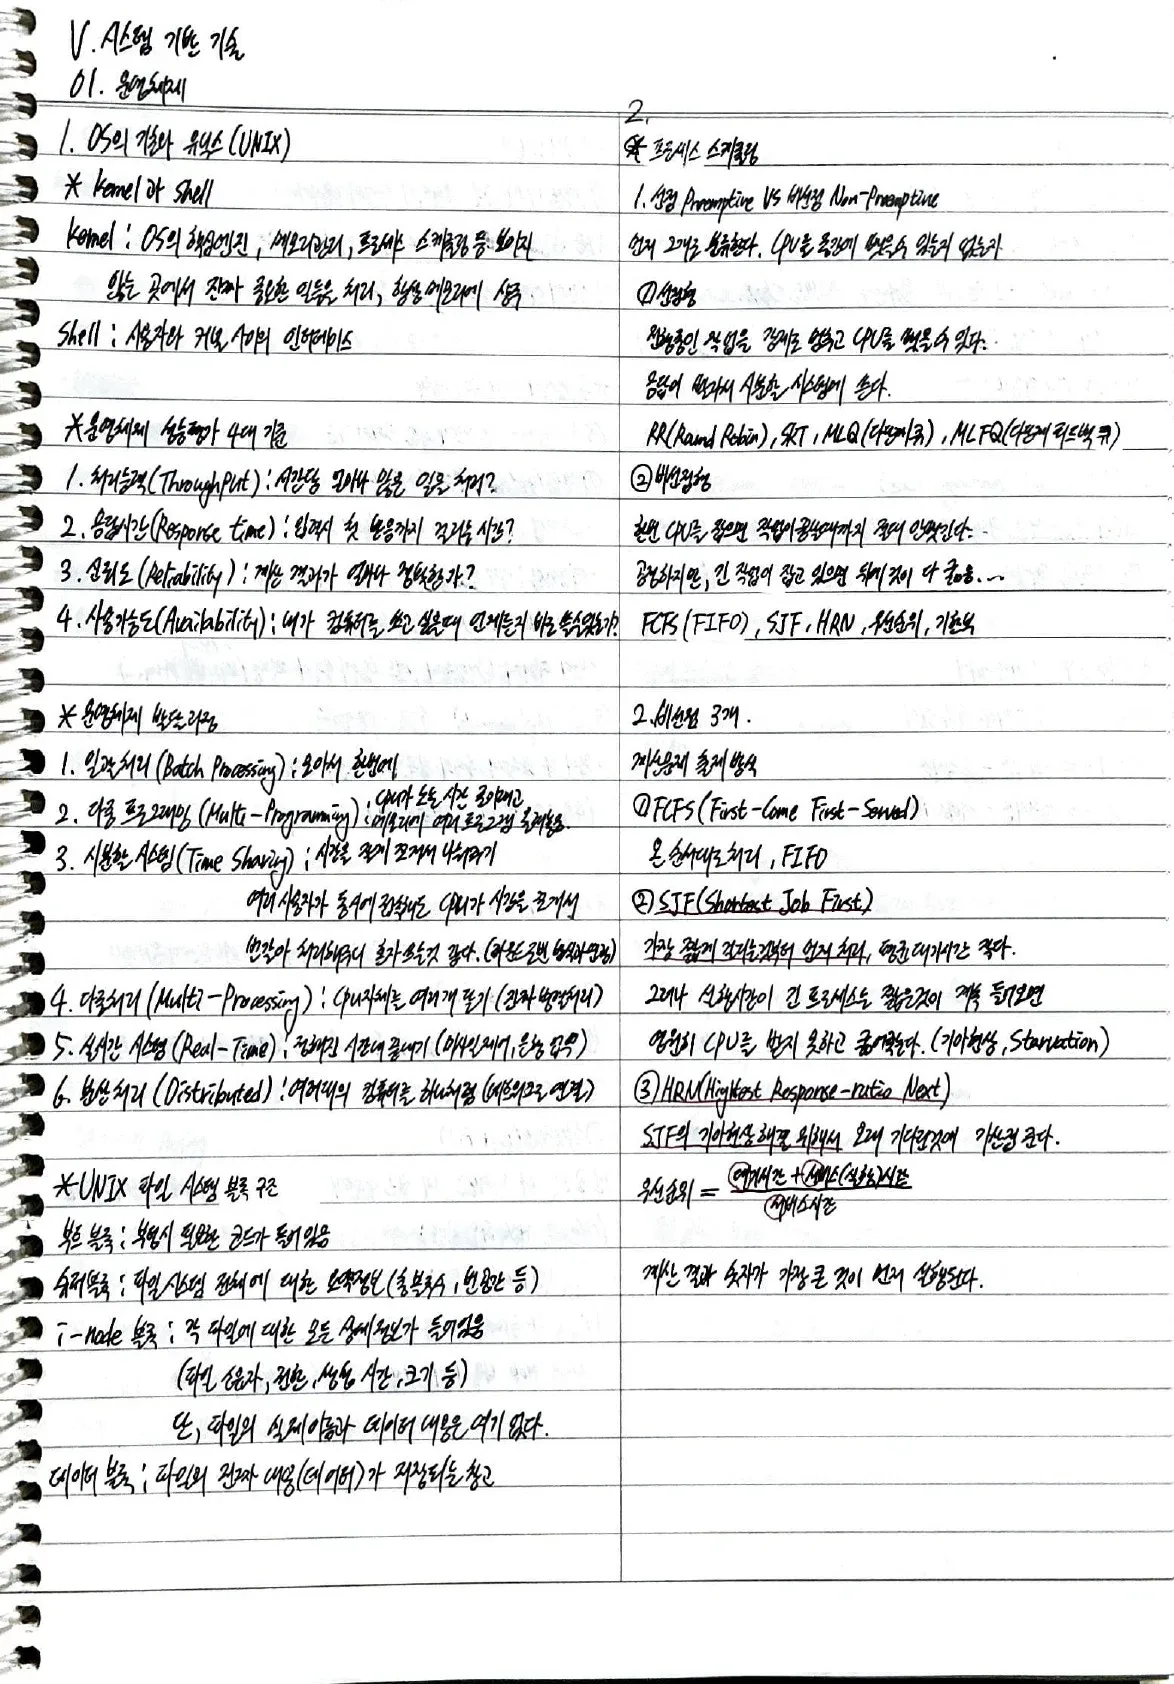
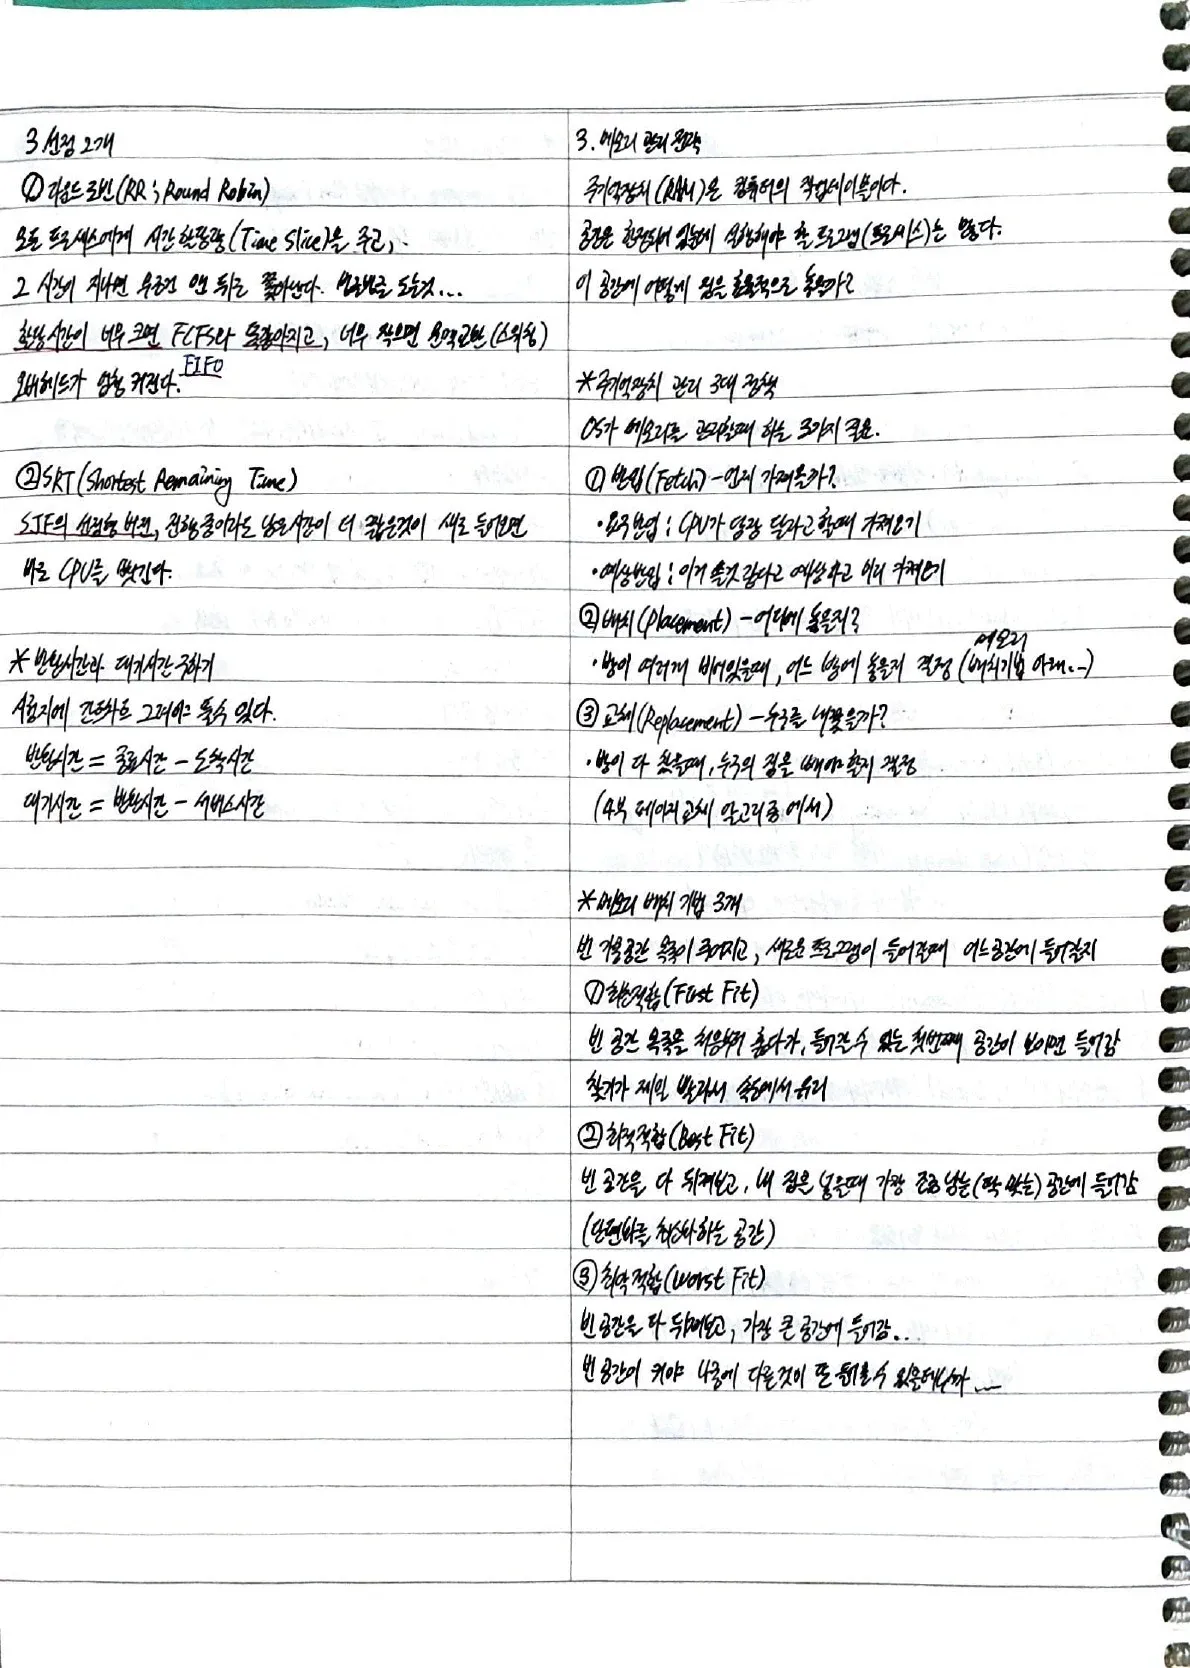
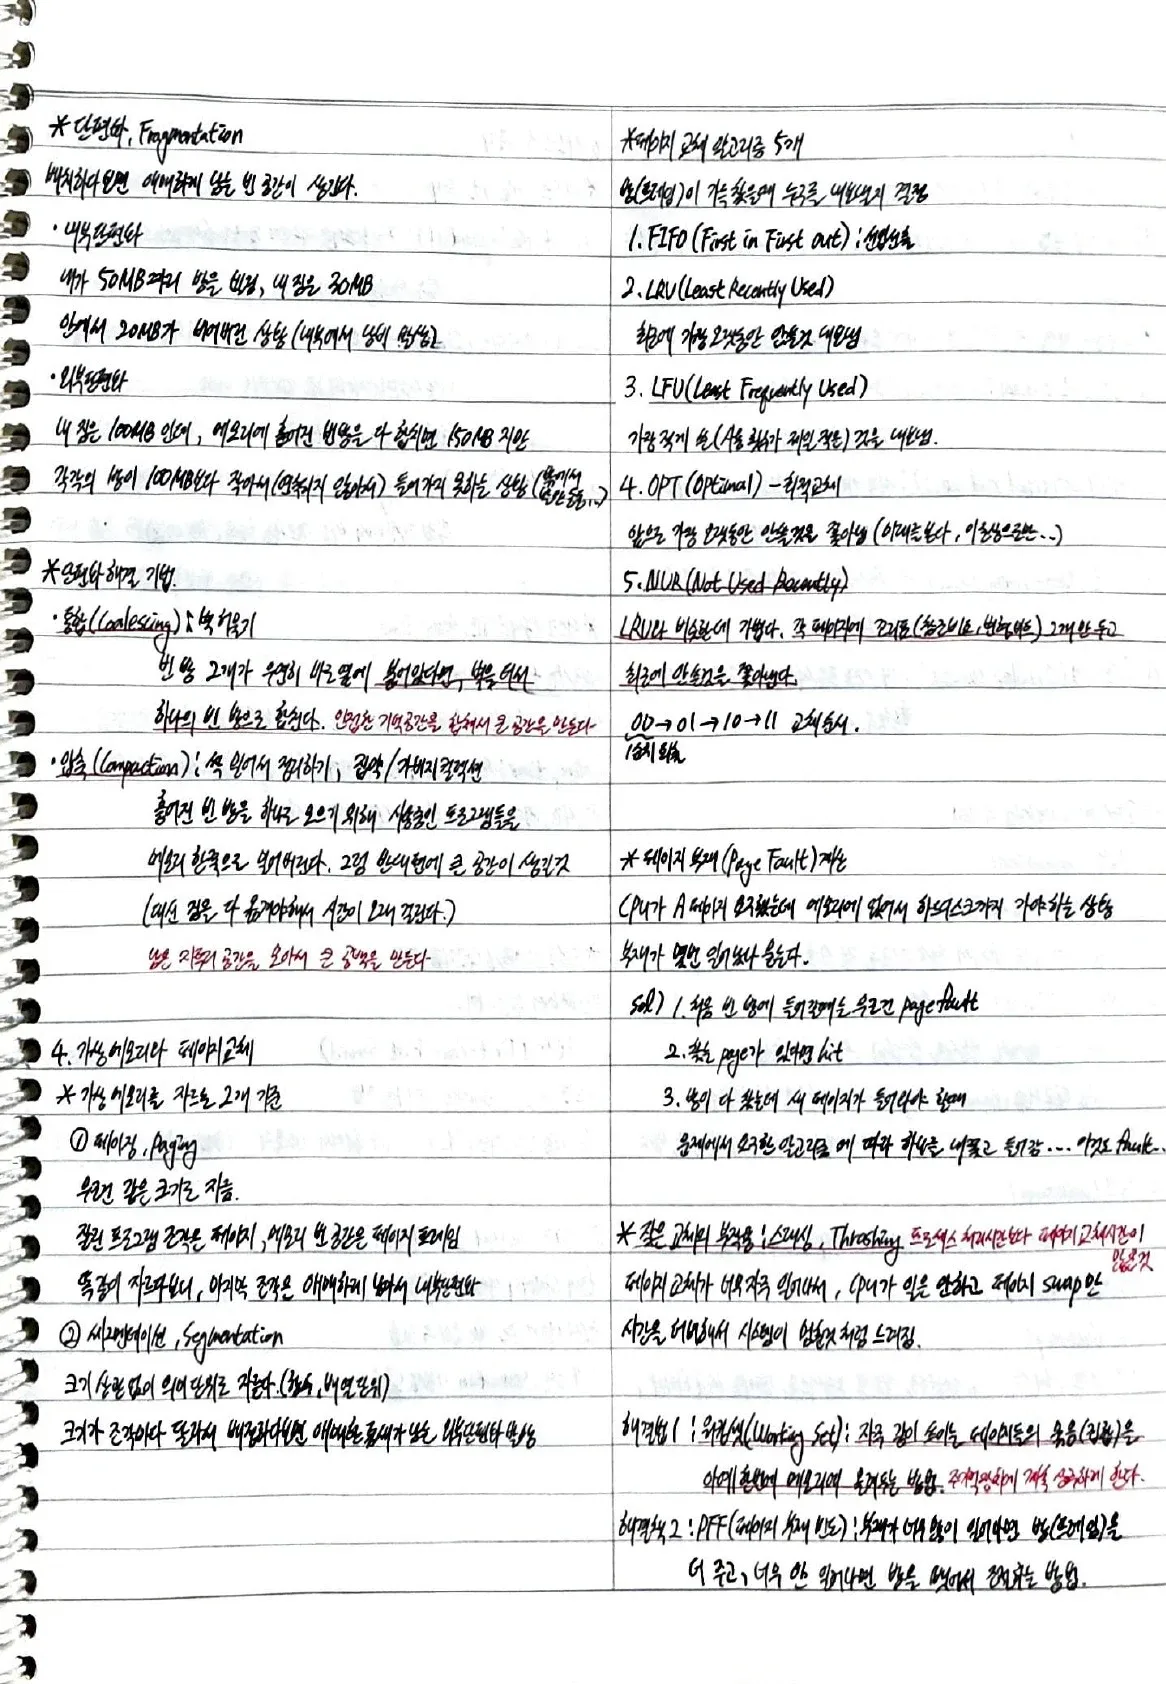
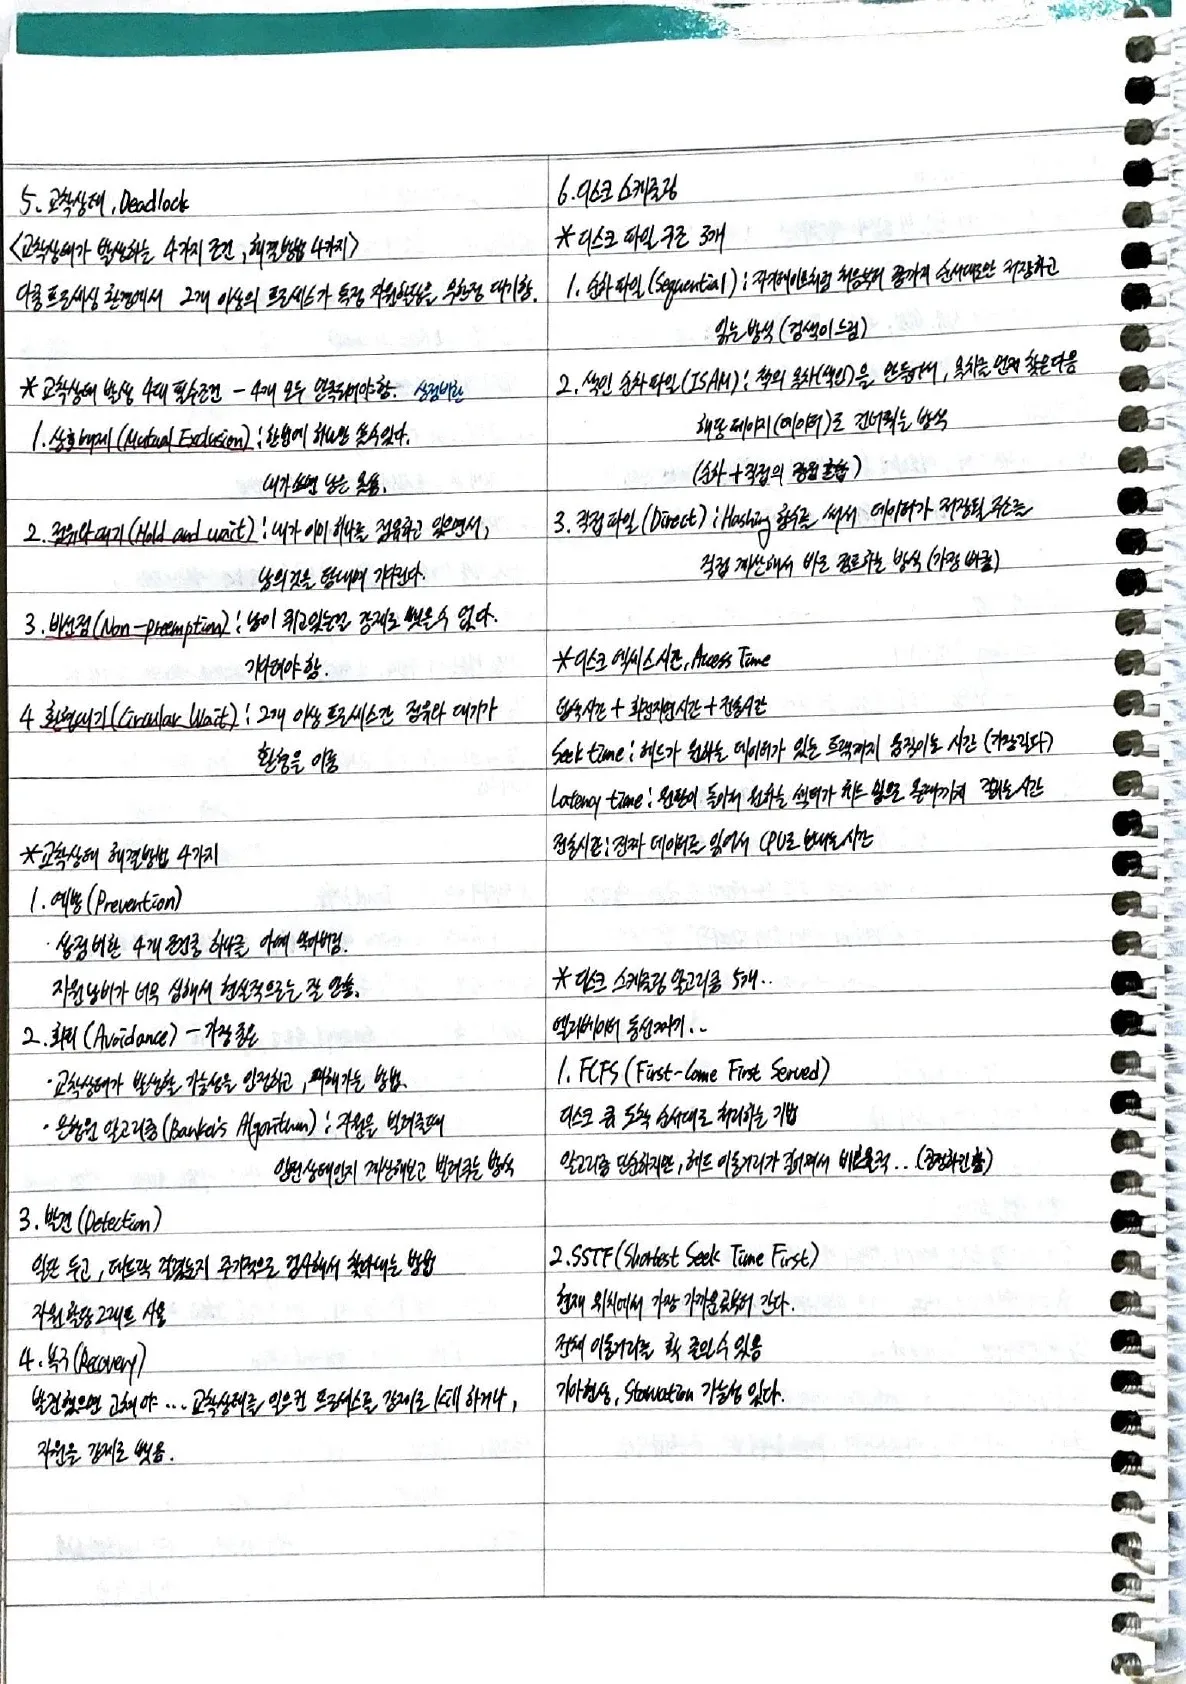
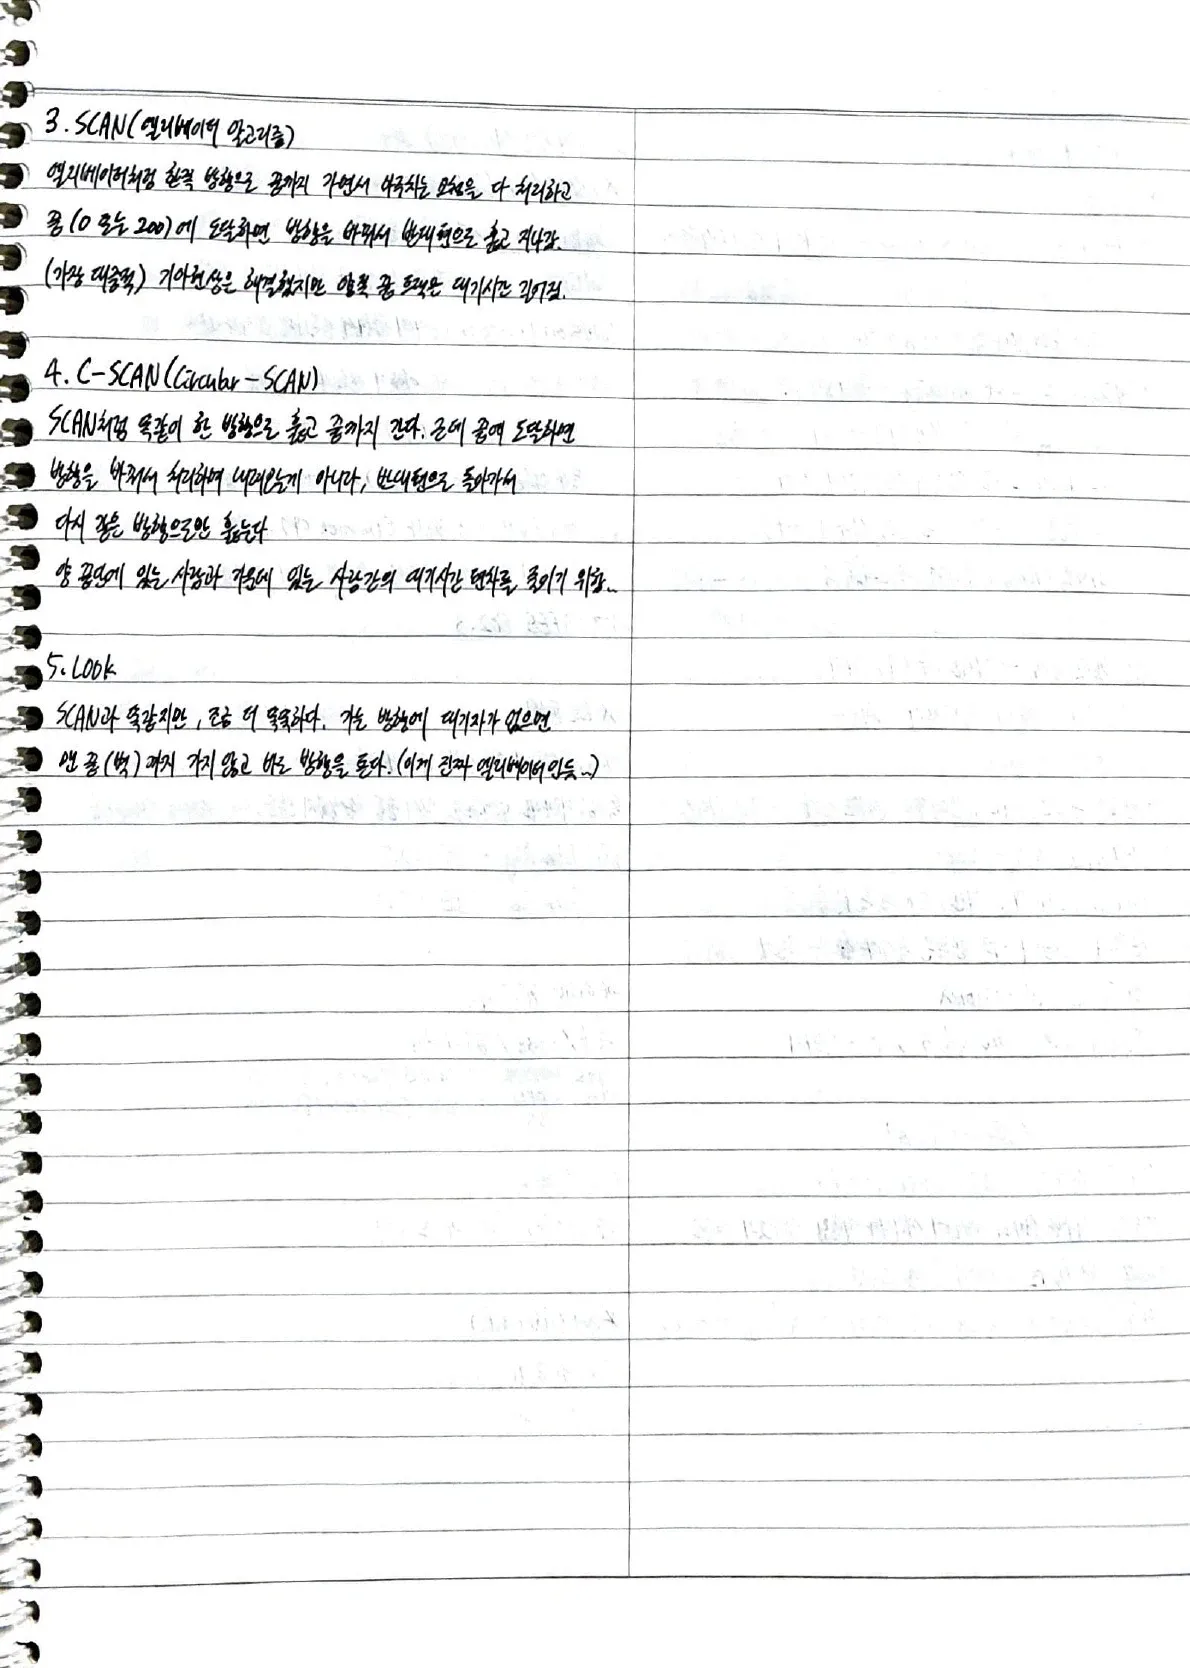
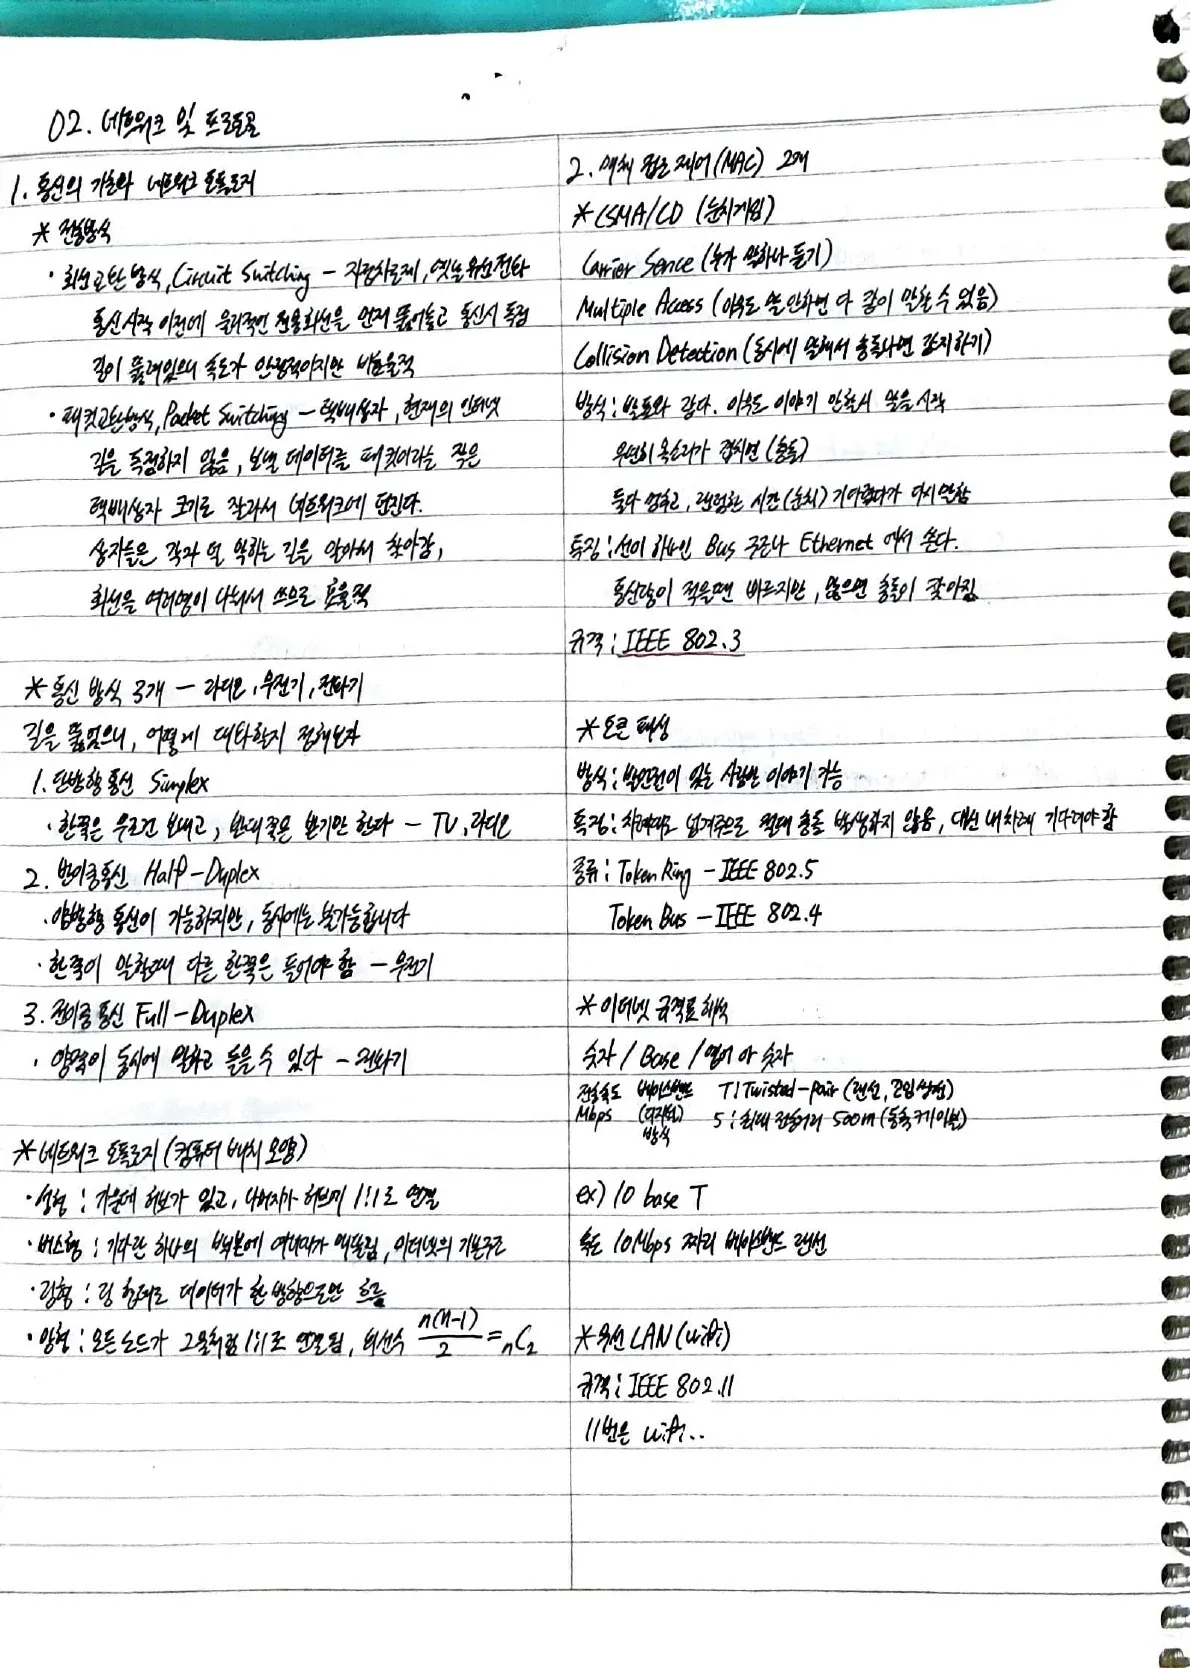
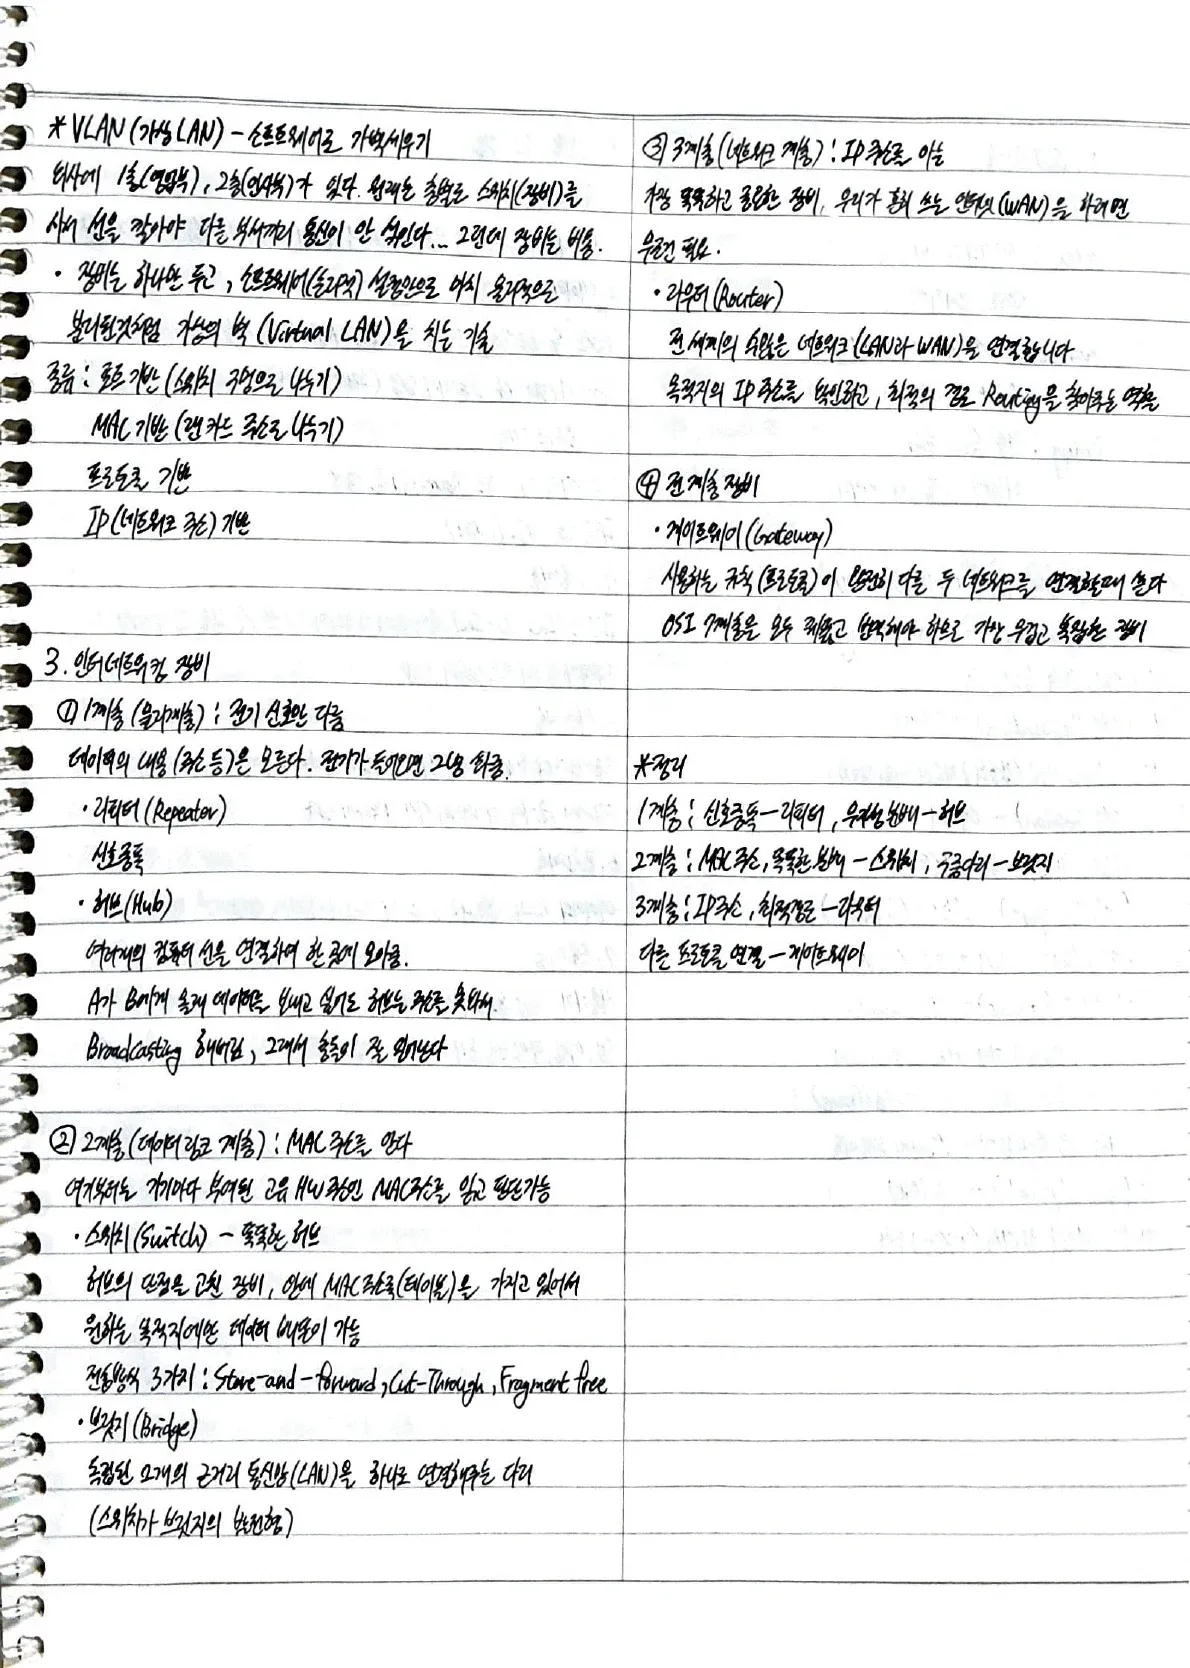
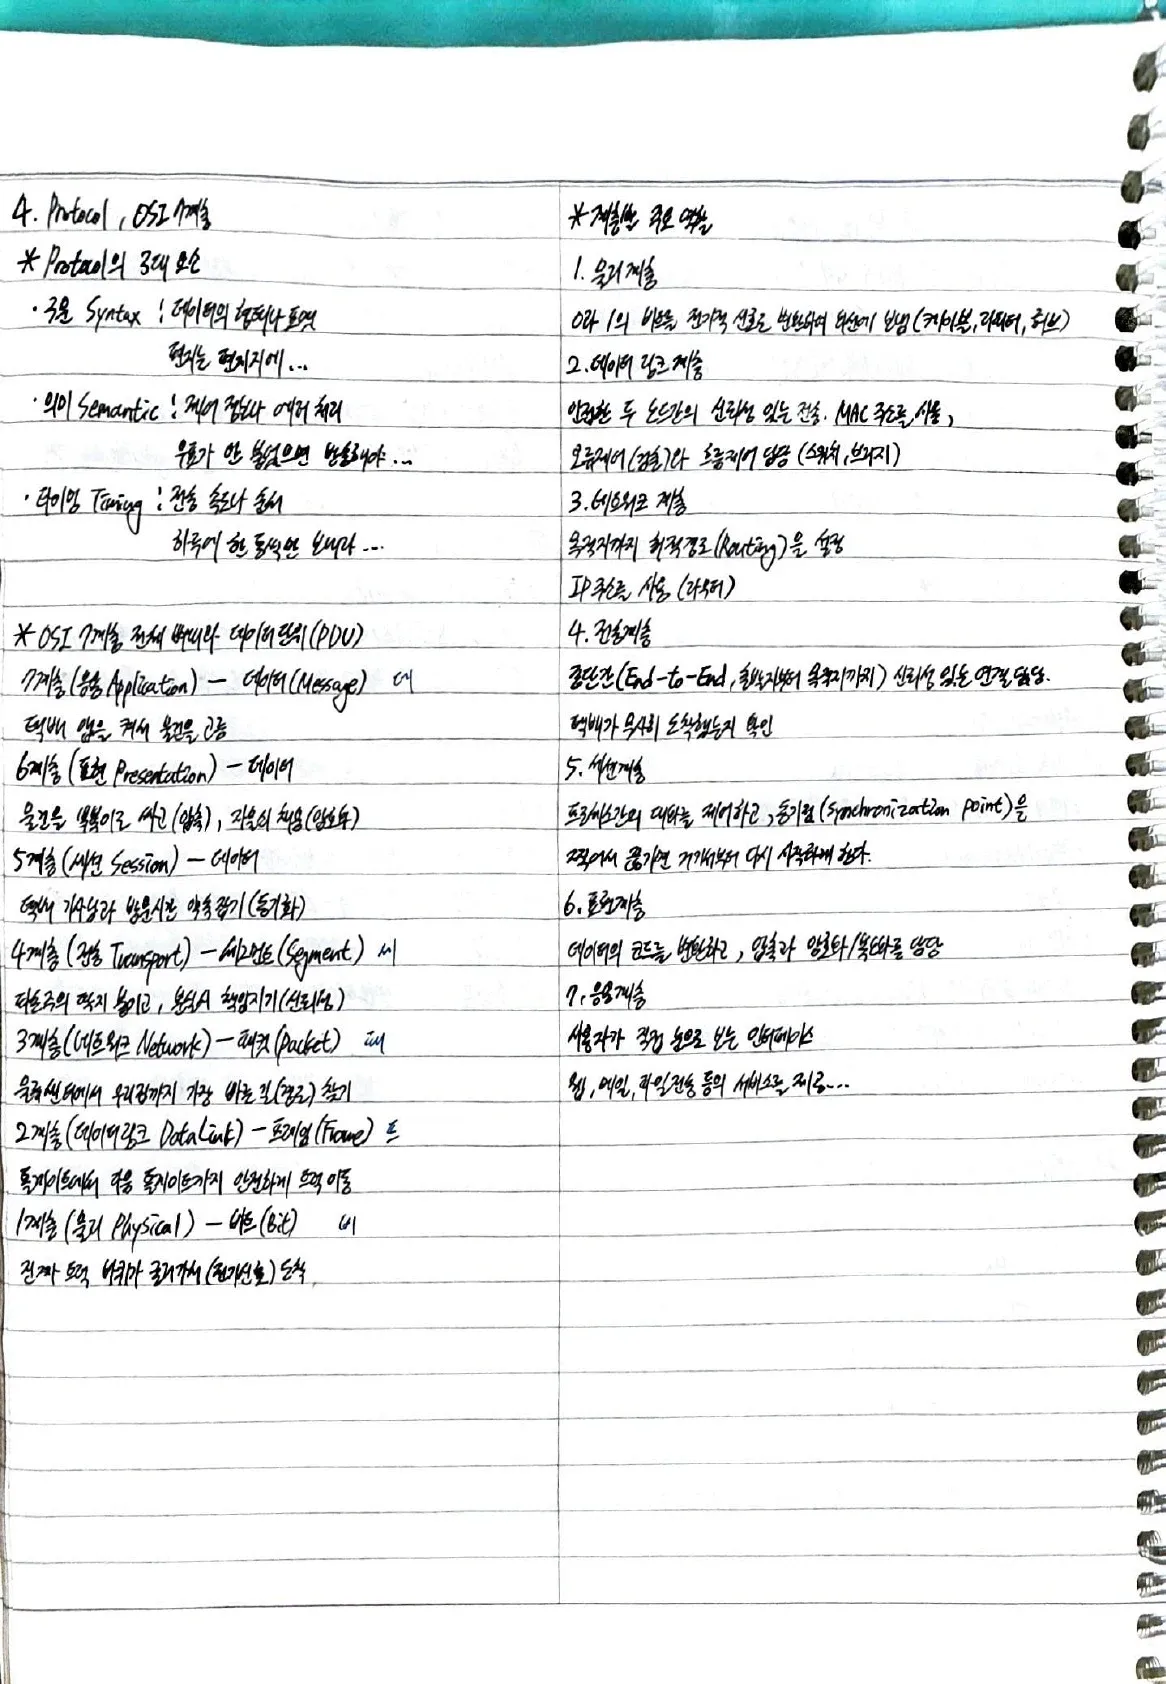
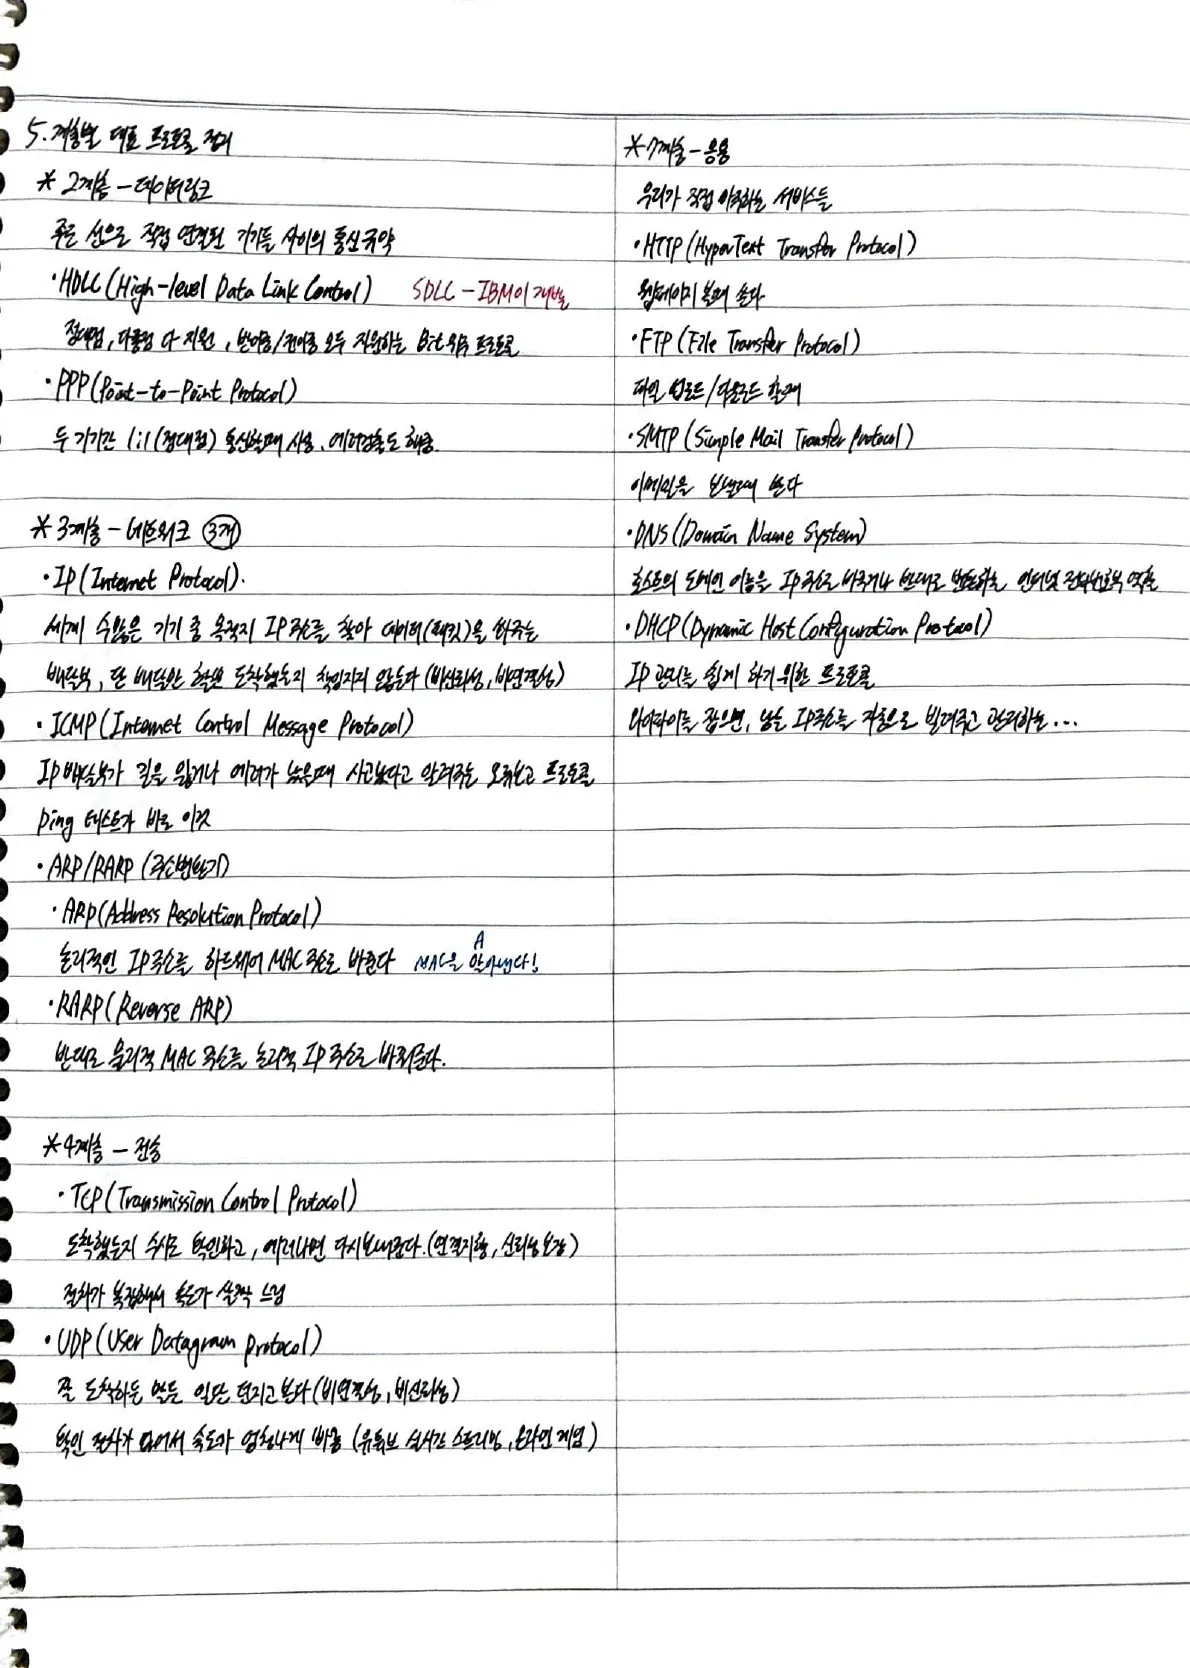
PDF 원본 스캔
타이핑하지 못한 내용을 포함한 원본 필기 42페이지
Comments