큰 계산을 맡긴 뒤 결과를 검증하려고 같은 계산을 처음부터 다시 하면, 검증 비용이 외주 계산의 이점을 줄일 수 있다. 결과와 함께 짧은 증명을 받아, 계산 전체를 다시 수행하는 것보다 적은 비용으로 확인할 수 있을까? SNARK가 겨냥하는 문제다.
여기에 비밀 입력이나 모델 가중치까지 숨기는 성질을 더하면 zk-SNARK가 된다. 짧은 증명, 빠른 검증, 정보 비공개는 각각 구별해야 하는 요구다.
1. 대화형 증명에서 달라지는 요구
Introduction to SNARK 강의 2쪽
QR와 그래프 동형 프로토콜에서는 증명자와 검증자가 메시지를 주고받았다. 검증자는 대화에 참여해 적절한 시점에 무작위 질문을 골라야 했다.
또한 대화 기록만 제삼자에게 보여 주는 것으로는 같은 확신을 전달하지 못했다. Witness 없이도 시뮬레이터가 그런 기록을 만들 수 있기 때문이다.
SNARK에서 원하는 사용 방식은 다음과 같다.
- 증명자가 계산 결과에 관한 증명 하나를 만든다.
- 검증자는 증명 생성 중에 온라인으로 질문을 보낼 필요가 없다.
- 나중에 증명을 받은 사람도 공개된 검증 정보로 확인할 수 있다.
- 원래 계산이 크더라도 증명이 짧고 검증이 빠르다.
%3b%7d%23mermaid-0 .cluster rect%7bfill:white%3bstroke:hsl(0%2c 0%25%2c 90%25)%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:black%3b%7d%23mermaid-0 .cluster span%7bcolor:black%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:white%3bborder:1px solid hsl(0%2c 0%25%2c 90%25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%2328332d%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:%23edf4ef%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:%23edf4ef%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:%23edf4ef%3bfill:%23edf4ef%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%239bafa2%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239bafa2%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M118%2c86L118%2c88.5C118%2c91%2c118%2c96%2c118%2c100.333C118%2c104.667%2c118%2c108.333%2c118%2c110.167L118%2c112' id='mermaid-0-L_A_P_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_P_0' data-points='W3sieCI6MTE4LCJ5Ijo4Nn0seyJ4IjoxMTgsInkiOjEwMX0seyJ4IjoxMTgsInkiOjExNn1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c194L118%2c196.5C118%2c199%2c118%2c204%2c118%2c208.333C118%2c212.667%2c118%2c216.333%2c118%2c218.167L118%2c220' id='mermaid-0-L_P_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P_B_0' data-points='W3sieCI6MTE4LCJ5IjoxOTR9LHsieCI6MTE4LCJ5IjoyMDl9LHsieCI6MTE4LCJ5IjoyMjR9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c278L118%2c280.5C118%2c283%2c118%2c288%2c118%2c292.333C118%2c296.667%2c118%2c300.333%2c118%2c302.167L118%2c304' id='mermaid-0-L_B_V_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_V_0' data-points='W3sieCI6MTE4LCJ5IjoyNzh9LHsieCI6MTE4LCJ5IjoyOTN9LHsieCI6MTE4LCJ5IjozMDh9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c386L118%2c388.5C118%2c391%2c118%2c396%2c118%2c400.333C118%2c404.667%2c118%2c408.333%2c118%2c410.167L118%2c412' id='mermaid-0-L_V_R_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_V_R_0' data-points='W3sieCI6MTE4LCJ5IjozODZ9LHsieCI6MTE4LCJ5Ijo0MDF9LHsieCI6MTE4LCJ5Ijo0MTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_P_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P_B_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_B_V_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_V_R_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-A-0' data-look='classic' transform='translate(118%2c 47)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b3%b5%ea%b0%9c %ec%9e%85%eb%a0%a5 u %2b %eb%b9%84%eb%b0%80 witness w%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-P-1' data-look='classic' transform='translate(118%2c 155)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ec%a6%9d%eb%aa%85%ec%9e%90: %ea%b3%84%ec%82%b0 %ec%88%98%ed%96%89 %eb%b0%8f %ec%a6%9d%eb%aa%85 %ec%83%9d%ec%84%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-B-3' data-look='classic' transform='translate(118%2c 251)'%3e%3crect class='basic label-container' style='' x='-98.1875' y='-27' width='196.375' height='54'/%3e%3cg class='label' style='' transform='translate(-68.1875%2c -12)'%3e%3crect/%3e%3cforeignObject width='136.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b3%b5%ea%b0%9c %ea%b2%b0%ea%b3%bc%ec%99%80 %ec%a6%9d%eb%aa%85 %cf%80%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-V-5' data-look='classic' transform='translate(118%2c 347)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b2%80%ec%a6%9d%ec%9e%90: %ea%b3%b5%ea%b0%9c %ea%b2%80%ec%a6%9d %ec%a0%95%eb%b3%b4%eb%a1%9c %ed%99%95%ec%9d%b8%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-R-7' data-look='classic' transform='translate(118%2c 443)'%3e%3crect class='basic label-container' style='' x='-79.8046875' y='-27' width='159.609375' height='54'/%3e%3cg class='label' style='' transform='translate(-49.8046875%2c -12)'%3e%3crect/%3e%3cforeignObject width='99.609375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eaccept / reject%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-0-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='%239bafa2' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(137.1428571429%2c 0%25%2c 84.3137254902%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
%3b%7d%23mermaid-dark-0%20.cluster%20rect%7bfill:hsl(220%2c%2058.9285714286%25%2c%2037.9607843137%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-0%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-0%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:%231e293b%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-0%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23e2e8f0%3b%7d%23mermaid-dark-0%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-0%20.icon-shape%2c%23mermaid-dark-0%20.image-shape%7bbackground-color:%23111827%3btext-align:center%3b%7d%23mermaid-dark-0%20.icon-shape%20p%2c%23mermaid-dark-0%20.image-shape%20p%7bbackground-color:%23111827%3bpadding:2px%3b%7d%23mermaid-dark-0%20.icon-shape%20.label%20rect%2c%23mermaid-dark-0%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:%23111827%3bfill:%23111827%3b%7d%23mermaid-dark-0%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-0%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-0%20.node%20.neo-node%7bstroke:%2300f0ff%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%2300f0ff%3bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20:root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M118%2c86L118%2c88.5C118%2c91%2c118%2c96%2c118%2c100.333C118%2c104.667%2c118%2c108.333%2c118%2c110.167L118%2c112'%20id='mermaid-dark-0-L_A_P_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_A_P_0'%20data-points='W3sieCI6MTE4LCJ5Ijo4Nn0seyJ4IjoxMTgsInkiOjEwMX0seyJ4IjoxMTgsInkiOjExNn1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c194L118%2c196.5C118%2c199%2c118%2c204%2c118%2c208.333C118%2c212.667%2c118%2c216.333%2c118%2c218.167L118%2c220'%20id='mermaid-dark-0-L_P_B_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P_B_0'%20data-points='W3sieCI6MTE4LCJ5IjoxOTR9LHsieCI6MTE4LCJ5IjoyMDl9LHsieCI6MTE4LCJ5IjoyMjR9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c278L118%2c280.5C118%2c283%2c118%2c288%2c118%2c292.333C118%2c296.667%2c118%2c300.333%2c118%2c302.167L118%2c304'%20id='mermaid-dark-0-L_B_V_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_B_V_0'%20data-points='W3sieCI6MTE4LCJ5IjoyNzh9LHsieCI6MTE4LCJ5IjoyOTN9LHsieCI6MTE4LCJ5IjozMDh9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c386L118%2c388.5C118%2c391%2c118%2c396%2c118%2c400.333C118%2c404.667%2c118%2c408.333%2c118%2c410.167L118%2c412'%20id='mermaid-dark-0-L_V_R_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_V_R_0'%20data-points='W3sieCI6MTE4LCJ5IjozODZ9LHsieCI6MTE4LCJ5Ijo0MDF9LHsieCI6MTE4LCJ5Ijo0MTZ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_A_P_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P_B_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_B_V_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_V_R_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-A-0'%20data-look='classic'%20transform='translate(118%2c%2047)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b3%b5%ea%b0%9c%20%ec%9e%85%eb%a0%a5%20u%20%2b%20%eb%b9%84%eb%b0%80%20witness%20w%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-P-1'%20data-look='classic'%20transform='translate(118%2c%20155)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ec%a6%9d%eb%aa%85%ec%9e%90:%20%ea%b3%84%ec%82%b0%20%ec%88%98%ed%96%89%20%eb%b0%8f%20%ec%a6%9d%eb%aa%85%20%ec%83%9d%ec%84%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-B-3'%20data-look='classic'%20transform='translate(118%2c%20251)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-98.1875'%20y='-27'%20width='196.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-68.1875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='136.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b3%b5%ea%b0%9c%20%ea%b2%b0%ea%b3%bc%ec%99%80%20%ec%a6%9d%eb%aa%85%20%cf%80%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-V-5'%20data-look='classic'%20transform='translate(118%2c%20347)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b2%80%ec%a6%9d%ec%9e%90:%20%ea%b3%b5%ea%b0%9c%20%ea%b2%80%ec%a6%9d%20%ec%a0%95%eb%b3%b4%eb%a1%9c%20%ed%99%95%ec%9d%b8%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-R-7'%20data-look='classic'%20transform='translate(118%2c%20443)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-79.8046875'%20y='-27'%20width='159.609375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-49.8046875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='99.609375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eaccept%20/%20reject%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-0-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
이 그림은 역할을 설명하는 개념도다. 증명자가 비용 없이 를 얻는다는 뜻은 아니다. 검증 비용을 줄이기 위해 증명 생성 쪽에 상당한 계산이 들어갈 수 있다.
2. Statement와 witness: 1GB 메시지의 예
강의 3쪽
강의의 예시는 다음 주장이다.
- 공개 statement: 해시 출력이 지정된 값이라는 관계.
- 비밀 witness: 그 관계를 만족하는 메시지 .
- 검증할 관계: 인지 여부.
메시지 이 1GB라면 가장 직접적인 증명은 자체를 보내는 것이다. 그러나 검증자는 1GB를 받아 모두 해시해야 한다. 통신도 크고 검증도 무겁다.
SNARK는 이 관계에 대한 짧은 증명과 빠른 검증을 목표로 한다. zk-SNARK는 여기에 에 관한 추가 정보를 공개하지 않는 성질까지 요구한다.
| 방식 | 무엇을 전달하는가 | 검증할 때의 차이 | 비밀 보호 |
|---|---|---|---|
| Witness 직접 전달 | 전체 | 원래 관계를 직접 계산 | 이 드러남 |
| SNARK | 짧은 | 증명 검증 알고리즘 실행 | 이름만으로 ZK를 보장하지 않음 |
| zk-SNARK | 짧은 | 증명 검증 알고리즘 실행 | 공개 statement를 넘어서는 witness 정보의 누출을 막음 |
이 예시는 이미 witness를 아는 증명자를 가정한다. SNARK가 SHA-256의 원상을 쉽게 찾아 준다는 뜻은 아니다. Witness 찾기의 어려움과, 주어진 witness를 이용해 주장을 증명하는 문제는 별개다.
공개 statement와 증명 도 다른 값이다. Statement는 “무엇이 참인지”를 지정하고, 는 그 주장을 받아들일 근거로 검증 알고리즘에 넣는 데이터다. 이 예제에서는 목표 해시값과 검사할 관계를 미리 알 수 있지만, 그것만으로 그 관계를 만족하는 비밀 메시지를 얻는 것은 아니다. 검증자는 메시지를 직접 받는 대신 해당 statement에 대한 를 검사한다.
3. SNARK라는 이름을 풀어 읽기
강의 4쪽
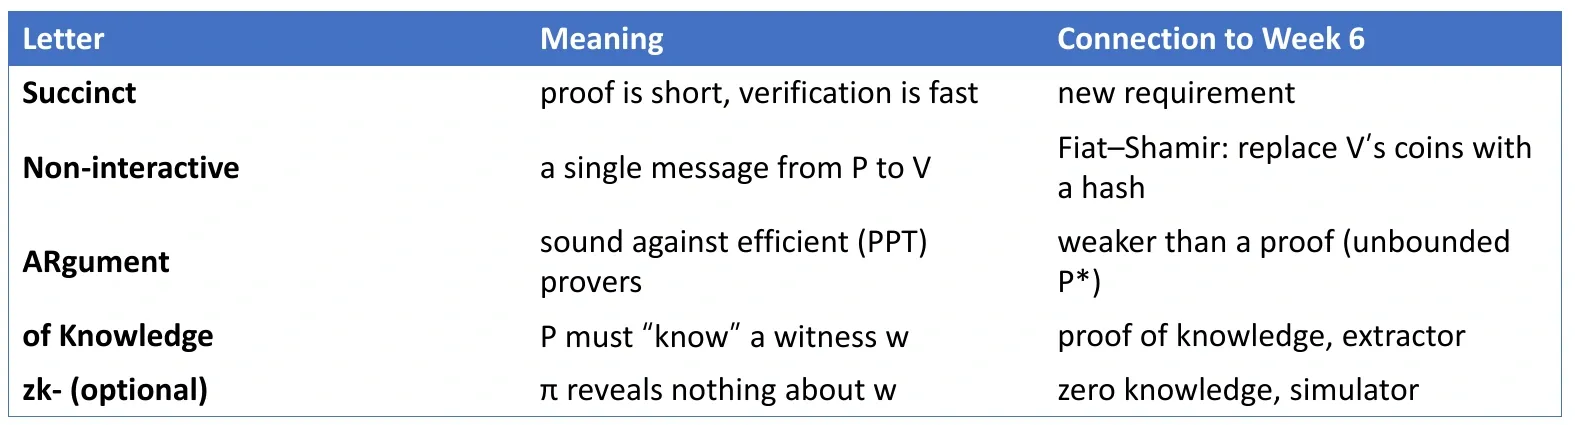
S: Succinct
증명 길이와 검증 비용이 원래 큰 계산에 비해 작아야 한다. 증명이 짧다는 것과 검증이 빠르다는 것 모두 포함한다.
관계를 검사하는 계산의 크기를 라 할 때, 단순히 에 비례하는 실행 기록 전체를 보내고 전부 재검사하게 하는 방식과 다르다. 구체적인 증명 길이와 검증 복잡도는 방식에 따라 달라지며, 이 도입 자료는 특정 수치를 정하지 않는다.
공개 입력 자체가 크면 그 입력을 읽는 비용도 있다. “어떤 크기의 공개 입력이든 아무 비용 없이 검증한다”거나 “모든 SNARK는 같은 크기의 증명을 가진다”는 뜻은 아니다.
N: Non-interactive
증명자는 증명 메시지를 보내고, 검증자는 자신의 무작위 질문에 대한 추가 응답을 기다리지 않고 검사한다.
공개 매개변수나 검증키가 필요 없다는 뜻은 아니다. 증명 생성·검증 단계의 대화가 없다는 성질과, 사전 설정을 어떻게 준비하는지는 별도 문제다.
AR: Argument
건전성(soundness)을 효율적인 PPT 증명자에 대해 요구한다. 계산 능력이 무제한인 증명자까지 거짓 증명을 막는 proof와 구별한다.
수업이나 실무에서 를 관례적으로 “proof”라고 부르더라도, SNARK의 엄밀한 분류는 argument다. 공격자의 계산 제한과 암호학적 가정이 보안의 일부다.
K: Knowledge
검증자를 충분히 높은 확률로 설득하는 증명자의 동작에서 witness를 추출할 수 있어야 한다. 단순히 참인 명제가 존재한다는 membership soundness와 구별한다.
실제 검증자에게 witness가 전달된다는 뜻은 아니다. 추출기는 보안 정의에 등장하는 알고리즘이며, 실제 검증자가 받은 를 해독해 비밀을 읽는 기능이 아니다.
zk-: 선택적으로 추가하는 영지식성(zero-knowledge)
증명이 공개 입력과 주장의 참 여부를 넘어서는 witness 정보를 드러내지 않도록 한다. 강의에서 zk-는 optional이라고 한 이유다.
따라서 다음 두 문장은 다르다.
- SNARK이므로 지식 건전성(knowledge soundness)을 요구한다.
- zk-SNARK이므로 영지식성(zero-knowledge)도 요구한다.
짧음이 정보 비공개를 뜻하지는 않는다. 짧은 문자열에도 비밀의 특정 비트가 그대로 들어갈 수 있다.
4. 보충: 무엇을 증명하는지 먼저 정한다
강의의 여러 응용을 같은 방식으로 읽으려면 공개 입력과 witness를 나누면 된다.
는 검증자가 확인하려는 공개 statement이고, 는 이를 만족시키는 증명자의 데이터다. 예를 들면 다음과 같다.
| 응용 | 공개 입력의 예 | Witness의 예 |
|---|---|---|
| 해시 원상 지식 | 목표 해시값 | 원래 메시지 |
| 상태 전이 검증 | 이전·이후 상태에 대한 commitment, 배치 정보 | 거래 데이터와 실행에 필요한 내부 값 |
| 비공개 거래 | 공개 commitment와 중복 사용 방지 정보 | 소유권 비밀, 금액, commitment의 opening |
| 모델 추론 검증 | 입력·출력, 모델 commitment | 모델 가중치와 commitment의 opening |
이 표는 공개 범위를 설명하는 예다. 실제 구성에서는 어떤 값을 숨기고 어떤 값을 공개할지에 따라 와 관계가 달라진다.
전형적인 인터페이스는 다음처럼 읽을 수 있다.
와 는 각각 증명과 검증에 쓰이는 매개변수다. 같은 매개변수를 공유하는 방식도 있고 별도 키를 사용하는 방식도 있다. 이 표현은 특정한 trusted setup 방식을 가정하지 않는다.
검증 성공이 뜻하는 것은 선택한 관계 에 관한 보장이다. 관계에서 빠뜨린 조건까지 자동으로 검사해 주지는 않는다.
관계 은 witness를 직접 받았다면 확인했을 검사 규칙이라고 생각하면 된다. 예를 들어 모델의 출력만 확인하도록 관계를 작성하면, 약속한 모델을 썼는지까지는 확인하지 못한다. 모델 commitment와 연결하는 조건도 관계 안에 넣어야 한다. 이 단계에서 빠진 조건은 증명 시스템 자체가 안전하더라도 보완되지 않는다.
5. Fiat-Shamir: 질문을 해시로 만드는 아이디어
강의 4쪽의 연결 설명을 보충
앞선 public-coin 프로토콜에서는 검증자가 무작위 challenge를 보냈다. Fiat-Shamir 변환은 적절한 프로토콜에서 그 challenge를 공개 입력과 앞선 transcript의 해시로 유도하는 방법이다.
개념적으로 첫 메시지를 라 하면
처럼 쓴다. 증명자는 이 에 대한 응답 를 계산하고, 검증자는 같은 해시를 다시 계산해 응답을 검사한다. 실제 인코딩에서는 각 필드를 모호하지 않게 구분해야 한다.
%3b%7d%23mermaid-1 .cluster rect%7bfill:white%3bstroke:hsl(0%2c 0%25%2c 90%25)%3bstroke-width:1px%3b%7d%23mermaid-1 .cluster text%7bfill:black%3b%7d%23mermaid-1 .cluster span%7bcolor:black%3b%7d%23mermaid-1 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:white%3bborder:1px solid hsl(0%2c 0%25%2c 90%25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-1 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%2328332d%3b%7d%23mermaid-1 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-1 .icon-shape%2c%23mermaid-1 .image-shape%7bbackground-color:%23edf4ef%3btext-align:center%3b%7d%23mermaid-1 .icon-shape p%2c%23mermaid-1 .image-shape p%7bbackground-color:%23edf4ef%3bpadding:2px%3b%7d%23mermaid-1 .icon-shape .label rect%2c%23mermaid-1 .image-shape .label rect%7bopacity:0.5%3bbackground-color:%23edf4ef%3bfill:%23edf4ef%3b%7d%23mermaid-1 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-1 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-1 .node .neo-node%7bstroke:%239bafa2%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node rect%2c%23mermaid-1 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-1 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-1-gradient)%3bstroke-width:1px%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239bafa2%3bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-1 :root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M118%2c62L118%2c64.5C118%2c67%2c118%2c72%2c118%2c76.333C118%2c80.667%2c118%2c84.333%2c118%2c86.167L118%2c88' id='mermaid-1-L_A_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_H_0' data-points='W3sieCI6MTE4LCJ5Ijo2Mn0seyJ4IjoxMTgsInkiOjc3fSx7IngiOjExOCwieSI6OTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c170L118%2c172.5C118%2c175%2c118%2c180%2c118%2c184.333C118%2c188.667%2c118%2c192.333%2c118%2c194.167L118%2c196' id='mermaid-1-L_H_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_H_C_0' data-points='W3sieCI6MTE4LCJ5IjoxNzB9LHsieCI6MTE4LCJ5IjoxODV9LHsieCI6MTE4LCJ5IjoyMDB9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c254L118%2c256.5C118%2c259%2c118%2c264%2c118%2c268.333C118%2c272.667%2c118%2c276.333%2c118%2c278.167L118%2c280' id='mermaid-1-L_C_Z_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_Z_0' data-points='W3sieCI6MTE4LCJ5IjoyNTR9LHsieCI6MTE4LCJ5IjoyNjl9LHsieCI6MTE4LCJ5IjoyODR9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c338L118%2c340.5C118%2c343%2c118%2c348%2c118%2c352.333C118%2c356.667%2c118%2c360.333%2c118%2c362.167L118%2c364' id='mermaid-1-L_Z_V_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Z_V_0' data-points='W3sieCI6MTE4LCJ5IjozMzh9LHsieCI6MTE4LCJ5IjozNTN9LHsieCI6MTE4LCJ5IjozNjh9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_H_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_H_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_C_Z_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Z_V_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-1-flowchart-A-0' data-look='classic' transform='translate(118%2c 35)'%3e%3crect class='basic label-container' style='' x='-89.1171875' y='-27' width='178.234375' height='54'/%3e%3cg class='label' style='' transform='translate(-59.1171875%2c -12)'%3e%3crect/%3e%3cforeignObject width='118.234375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ec%b2%ab %eb%a9%94%ec%8b%9c%ec%a7%80 a %ec%83%9d%ec%84%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-H-1' data-look='classic' transform='translate(118%2c 131)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b3%b5%ea%b0%9c %ec%9e%85%eb%a0%a5%ea%b3%bc %ec%95%9e%ec%84%a0 %eb%a9%94%ec%8b%9c%ec%a7%80%eb%a5%bc %ed%95%b4%ec%8b%9c%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-C-3' data-look='classic' transform='translate(118%2c 227)'%3e%3crect class='basic label-container' style='' x='-88.6953125' y='-27' width='177.390625' height='54'/%3e%3cg class='label' style='' transform='translate(-58.6953125%2c -12)'%3e%3crect/%3e%3cforeignObject width='117.390625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3echallenge c %ea%b2%b0%ec%a0%95%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-Z-5' data-look='classic' transform='translate(118%2c 311)'%3e%3crect class='basic label-container' style='' x='-107.34375' y='-27' width='214.6875' height='54'/%3e%3cg class='label' style='' transform='translate(-77.34375%2c -12)'%3e%3crect/%3e%3cforeignObject width='154.6875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ewitness%eb%a1%9c %ec%9d%91%eb%8b%b5 z %ec%83%9d%ec%84%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-V-7' data-look='classic' transform='translate(118%2c 407)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b2%80%ec%a6%9d%ec%9e%90%eb%8f%84 %ea%b0%99%ec%9d%80 c%eb%a5%bc %ec%9e%ac%ea%b3%84%ec%82%b0%ed%95%98%ec%97%ac %ea%b2%80%ec%82%ac%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-1-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='%239bafa2' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(137.1428571429%2c 0%25%2c 84.3137254902%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
%3b%7d%23mermaid-dark-1%20.cluster%20rect%7bfill:hsl(220%2c%2058.9285714286%25%2c%2037.9607843137%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-1%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-1%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-1%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:%231e293b%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-1%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23e2e8f0%3b%7d%23mermaid-dark-1%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-1%20.icon-shape%2c%23mermaid-dark-1%20.image-shape%7bbackground-color:%23111827%3btext-align:center%3b%7d%23mermaid-dark-1%20.icon-shape%20p%2c%23mermaid-dark-1%20.image-shape%20p%7bbackground-color:%23111827%3bpadding:2px%3b%7d%23mermaid-dark-1%20.icon-shape%20.label%20rect%2c%23mermaid-dark-1%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:%23111827%3bfill:%23111827%3b%7d%23mermaid-dark-1%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-1%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-1%20.node%20.neo-node%7bstroke:%2300f0ff%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-1%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-1-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%2300f0ff%3bfilter:none%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20:root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M118%2c62L118%2c64.5C118%2c67%2c118%2c72%2c118%2c76.333C118%2c80.667%2c118%2c84.333%2c118%2c86.167L118%2c88'%20id='mermaid-dark-1-L_A_H_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_A_H_0'%20data-points='W3sieCI6MTE4LCJ5Ijo2Mn0seyJ4IjoxMTgsInkiOjc3fSx7IngiOjExOCwieSI6OTJ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c170L118%2c172.5C118%2c175%2c118%2c180%2c118%2c184.333C118%2c188.667%2c118%2c192.333%2c118%2c194.167L118%2c196'%20id='mermaid-dark-1-L_H_C_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_H_C_0'%20data-points='W3sieCI6MTE4LCJ5IjoxNzB9LHsieCI6MTE4LCJ5IjoxODV9LHsieCI6MTE4LCJ5IjoyMDB9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c254L118%2c256.5C118%2c259%2c118%2c264%2c118%2c268.333C118%2c272.667%2c118%2c276.333%2c118%2c278.167L118%2c280'%20id='mermaid-dark-1-L_C_Z_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_C_Z_0'%20data-points='W3sieCI6MTE4LCJ5IjoyNTR9LHsieCI6MTE4LCJ5IjoyNjl9LHsieCI6MTE4LCJ5IjoyODR9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c338L118%2c340.5C118%2c343%2c118%2c348%2c118%2c352.333C118%2c356.667%2c118%2c360.333%2c118%2c362.167L118%2c364'%20id='mermaid-dark-1-L_Z_V_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Z_V_0'%20data-points='W3sieCI6MTE4LCJ5IjozMzh9LHsieCI6MTE4LCJ5IjozNTN9LHsieCI6MTE4LCJ5IjozNjh9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_A_H_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_H_C_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_C_Z_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Z_V_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-A-0'%20data-look='classic'%20transform='translate(118%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-89.1171875'%20y='-27'%20width='178.234375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-59.1171875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='118.234375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ec%b2%ab%20%eb%a9%94%ec%8b%9c%ec%a7%80%20a%20%ec%83%9d%ec%84%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-H-1'%20data-look='classic'%20transform='translate(118%2c%20131)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b3%b5%ea%b0%9c%20%ec%9e%85%eb%a0%a5%ea%b3%bc%20%ec%95%9e%ec%84%a0%20%eb%a9%94%ec%8b%9c%ec%a7%80%eb%a5%bc%20%ed%95%b4%ec%8b%9c%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-C-3'%20data-look='classic'%20transform='translate(118%2c%20227)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-88.6953125'%20y='-27'%20width='177.390625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-58.6953125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='117.390625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3echallenge%20c%20%ea%b2%b0%ec%a0%95%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-Z-5'%20data-look='classic'%20transform='translate(118%2c%20311)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-107.34375'%20y='-27'%20width='214.6875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-77.34375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='154.6875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ewitness%eb%a1%9c%20%ec%9d%91%eb%8b%b5%20z%20%ec%83%9d%ec%84%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-V-7'%20data-look='classic'%20transform='translate(118%2c%20407)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b2%80%ec%a6%9d%ec%9e%90%eb%8f%84%20%ea%b0%99%ec%9d%80%20c%eb%a5%bc%20%ec%9e%ac%ea%b3%84%ec%82%b0%ed%95%98%ec%97%ac%20%ea%b2%80%ec%82%ac%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-1-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-1-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-1-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
이 설명만으로 모든 대화형 증명을 안전하게 비대화형으로 바꿀 수 있다고 결론 내리면 안 된다. 적용할 프로토콜의 조건과 해시를 random oracle로 다루는 보안 분석 등이 필요하다. Fiat-Shamir 변환 기술 초안[1]
특히 앞 글의 한 비트 QR 질문을 그대로 해시 한 비트로 바꾸는 것만으로 강한 보안을 얻지는 못한다. 공격자가 자신이 답할 수 있는 질문에 맞춘 첫 메시지를 여러 번 시도할 수 있기 때문이다. 적절한 challenge 공간과 변환 전체의 분석이 필요하다.
앞 글의 시뮬레이터처럼 원하는 비트 와 응답 를 정하고 그에 맞는 첫 메시지 를 만들었다고 하자. 이제 해시가 낸 질문이 우연히 와 같으면 그 기록을 제출할 수 있다. 해시 한 비트가 독립적인 공정한 값처럼 나온다고 보면 새 후보마다 성공 확률이 여서 평균 두 번의 시도로 맞출 수 있다. 상호작용을 지우는 것뿐 아니라, 이런 반복 시도로 질문을 골라 맞추는 공격도 막아야 하는 이유다.
또한 Fiat-Shamir는 주로 상호작용을 없애는 연결 고리다. 비대화형이 되었다고 증명 길이까지 자동으로 짧아지는 것은 아니다.
공개 검증과 시뮬레이션은 어떻게 함께 가능한가
앞의 대화형 QR에서는 공개 입력만으로 누구나 수락 기록을 만들어 제삼자에게 전달할 수 있었다. 그런데 공개 검증 가능한 zk-SNARK에서도 시뮬레이터가 있으니 같은 일이 생기는 것은 아닐까?
보충으로, 비대화형 ZK의 시뮬레이션은 사용하는 모형의 설정까지 고려한다. CRS 모형의 시뮬레이터는 설정을 만들 때 얻는 시뮬레이션용 정보 등을 사용할 수 있고, random-oracle 모형에서는 오라클 프로그래밍이 쓰일 수 있다. 일반 검증자가 실제 공개 정보만으로 그 권한을 가지는 것은 아니다.
따라서 실제 공개 검증자의 능력과 보안 증명 속 시뮬레이터의 권한을 같다고 놓으면 안 된다. 비대화형 영지식의 설정과 시뮬레이션에 관한 설명은 Thaler, Proofs, Arguments, and Zero-Knowledge[2]에서 더 다룬다.
6. Transferability와 공개 검증
강의 2·4쪽
여기서 다루는 공개 검증형 SNARK에서는 공개 입력, 검증 정보, 증명 를 가진 사람이 검증할 수 있다. 증명 생성 당시 대화에 참여했던 특정 검증자일 필요가 없다.
| 대화형 QR·GI | 공개 검증형 SNARK |
|---|---|
| 검증자가 적절한 시점에 질문 선택 | 증명 메시지를 받아 검증 |
| 기록만으로 원래 대화를 제삼자에게 입증하기 어려움 | 같은 공개 입력과 검증 정보로 나중에도 확인 가능 |
| 시뮬레이션에 따른 부인 가능성이 특징 | 공개 재검증 가능성이 목표 |
다만 non-interactive라는 단어 자체가 모든 체계의 공개 검증 가능성을 뜻하지는 않는다. 이 강의가 대상으로 삼는 SNARK의 사용 방식에서 두 요구가 함께 등장하는 것이다.
Transferable하다는 말도 무조건 재사용해도 된다는 뜻은 아니다. 인증이나 거래 승인에 사용한다면 계정, 세션, 거래 내용 같은 맥락을 공개 statement에 결합해야 다른 상황으로 증명이 옮겨지는 문제를 막을 수 있다.
7. 계산보다 검증을 싸게 하기
강의 5쪽
강의는 Babai·Fortnow·Levin·Szegedy의 1991년 연구 Checking Computations in Polylogarithmic Time을 소개한다. 작은 신뢰 가능한 컴퓨터가 더 큰 비신뢰 계산 자원의 작업을 확인한다는 관점이다.
이를 블록체인에 옮기면 다음처럼 읽을 수 있다.
- 많은 계산은 오프체인의 서버나 GPU가 수행한다.
- 여러 참여자가 함께 검증해야 하는 L1은 짧은 증명을 검사한다.
- 계산을 수행하는 주체와, 결과를 신뢰할지 결정하는 주체를 나눈다.
가 큰 계산이라고 해서 모든 검증자가 만큼 다시 실행해야 하는 것은 아니라는 점이 핵심이다. 다만 증명자의 작업량, 증명 생성 시간, 검증 시간, 공개 입력 크기는 서로 다른 비용이다. 검증 비용 감소를 시스템 전체의 계산량 감소와 동일시하면 안 된다.
예를 들어 같은 계산 결과를 많은 참여자가 확인해야 한다면, 각자가 큰 계산을 반복하는 대신 한 번 생성한 증명을 각자 검증하는 방식이 유용할 수 있다. 증명 생성에는 추가 비용이 들지만 검증자마다 지출하는 비용을 줄일 수 있기 때문이다. 실제 이득은 증명 생성 비용과 검증 횟수 등을 함께 비교해야 하며, succinctness만으로 모든 상황에서 전체 비용이 줄어든다고 결론 내리지는 않는다.
8. 블록체인 응용 I: 계산 외주와 확장성
강의 6쪽
Proof-based rollup
오프체인 서비스가 여러 거래를 묶어 처리하고, 처리 결과가 정해진 상태 전이 규칙을 만족한다는 증명을 만든다. L1은 거래 전체를 그대로 재실행하는 대신 해당 증명을 검증한다.
%3b%7d%23mermaid-2 .cluster rect%7bfill:white%3bstroke:hsl(0%2c 0%25%2c 90%25)%3bstroke-width:1px%3b%7d%23mermaid-2 .cluster text%7bfill:black%3b%7d%23mermaid-2 .cluster span%7bcolor:black%3b%7d%23mermaid-2 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:white%3bborder:1px solid hsl(0%2c 0%25%2c 90%25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-2 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%2328332d%3b%7d%23mermaid-2 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-2 .icon-shape%2c%23mermaid-2 .image-shape%7bbackground-color:%23edf4ef%3btext-align:center%3b%7d%23mermaid-2 .icon-shape p%2c%23mermaid-2 .image-shape p%7bbackground-color:%23edf4ef%3bpadding:2px%3b%7d%23mermaid-2 .icon-shape .label rect%2c%23mermaid-2 .image-shape .label rect%7bopacity:0.5%3bbackground-color:%23edf4ef%3bfill:%23edf4ef%3b%7d%23mermaid-2 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-2 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-2 .node .neo-node%7bstroke:%239bafa2%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node rect%2c%23mermaid-2 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-2 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-2-gradient)%3bstroke-width:1px%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239bafa2%3bfilter:none%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-2 :root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M149.434%2c62L149.434%2c64.5C149.434%2c67%2c149.434%2c72%2c149.434%2c76.333C149.434%2c80.667%2c149.434%2c84.333%2c149.434%2c86.167L149.434%2c88' id='mermaid-2-L_T_O_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_T_O_0' data-points='W3sieCI6MTQ5LjQzMzU5Mzc1LCJ5Ijo2Mn0seyJ4IjoxNDkuNDMzNTkzNzUsInkiOjc3fSx7IngiOjE0OS40MzM1OTM3NSwieSI6OTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M94.658%2c146L89.586%2c148.5C84.514%2c151%2c74.37%2c156%2c69.298%2c160.333C64.227%2c164.667%2c64.227%2c168.333%2c64.227%2c170.167L64.227%2c172' id='mermaid-2-L_O_N_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_O_N_0' data-points='W3sieCI6OTQuNjU3NjQ1MDg5Mjg1NzIsInkiOjE0Nn0seyJ4Ijo2NC4yMjY1NjI1LCJ5IjoxNjF9LHsieCI6NjQuMjI2NTYyNSwieSI6MTc2fV0=' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M204.21%2c146L209.281%2c148.5C214.353%2c151%2c224.497%2c156%2c229.569%2c160.333C234.641%2c164.667%2c234.641%2c168.333%2c234.641%2c170.167L234.641%2c172' id='mermaid-2-L_O_P_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_O_P_0' data-points='W3sieCI6MjA0LjIwOTU0MjQxMDcxNDI4LCJ5IjoxNDZ9LHsieCI6MjM0LjY0MDYyNSwieSI6MTYxfSx7IngiOjIzNC42NDA2MjUsInkiOjE3Nn1d' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M64.227%2c230L64.227%2c232.5C64.227%2c235%2c64.227%2c240%2c67.608%2c244.643C70.99%2c249.286%2c77.753%2c253.573%2c81.135%2c255.716L84.517%2c257.859' id='mermaid-2-L_N_L_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_N_L_0' data-points='W3sieCI6NjQuMjI2NTYyNSwieSI6MjMwfSx7IngiOjY0LjIyNjU2MjUsInkiOjI0NX0seyJ4Ijo4Ny44OTUxODIyOTE2NjY2NiwieSI6MjYwfV0=' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M234.641%2c230L234.641%2c232.5C234.641%2c235%2c234.641%2c240%2c231.259%2c244.643C227.877%2c249.286%2c221.114%2c253.573%2c217.732%2c255.716L214.351%2c257.859' id='mermaid-2-L_P_L_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P_L_0' data-points='W3sieCI6MjM0LjY0MDYyNSwieSI6MjMwfSx7IngiOjIzNC42NDA2MjUsInkiOjI0NX0seyJ4IjoyMTAuOTcyMDA1MjA4MzMzMzQsInkiOjI2MH1d' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M149.434%2c338L149.434%2c340.5C149.434%2c343%2c149.434%2c348%2c149.434%2c352.333C149.434%2c356.667%2c149.434%2c360.333%2c149.434%2c362.167L149.434%2c364' id='mermaid-2-L_L_S_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_L_S_0' data-points='W3sieCI6MTQ5LjQzMzU5Mzc1LCJ5IjozMzh9LHsieCI6MTQ5LjQzMzU5Mzc1LCJ5IjozNTN9LHsieCI6MTQ5LjQzMzU5Mzc1LCJ5IjozNjh9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_T_O_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_O_N_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_O_P_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_N_L_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P_L_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_L_S_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-2-flowchart-T-0' data-look='classic' transform='translate(149.43359375%2c 35)'%3e%3crect class='basic label-container' style='' x='-107.5625' y='-27' width='215.125' height='54'/%3e%3cg class='label' style='' transform='translate(-77.5625%2c -12)'%3e%3crect/%3e%3cforeignObject width='155.125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b1%b0%eb%9e%98 %eb%b0%b0%ec%b9%98 %2b %ec%9d%b4%ec%a0%84 %ec%83%81%ed%83%9c%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-O-1' data-look='classic' transform='translate(149.43359375%2c 119)'%3e%3crect class='basic label-container' style='' x='-80.2265625' y='-27' width='160.453125' height='54'/%3e%3cg class='label' style='' transform='translate(-50.2265625%2c -12)'%3e%3crect/%3e%3cforeignObject width='100.453125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ec%98%a4%ed%94%84%ec%b2%b4%ec%9d%b8 %ec%8b%a4%ed%96%89%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-N-3' data-look='classic' transform='translate(64.2265625%2c 203)'%3e%3crect class='basic label-container' style='' x='-56.2265625' y='-27' width='112.453125' height='54'/%3e%3cg class='label' style='' transform='translate(-26.2265625%2c -12)'%3e%3crect/%3e%3cforeignObject width='52.453125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ec%83%88 %ec%83%81%ed%83%9c%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-P-5' data-look='classic' transform='translate(234.640625%2c 203)'%3e%3crect class='basic label-container' style='' x='-90.1875' y='-27' width='180.375' height='54'/%3e%3cg class='label' style='' transform='translate(-60.1875%2c -12)'%3e%3crect/%3e%3cforeignObject width='120.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ec%83%81%ed%83%9c %ec%a0%84%ec%9d%b4 %ec%a6%9d%eb%aa%85 %cf%80%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-L-7' data-look='classic' transform='translate(149.43359375%2c 299)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eL1: %ea%b3%b5%ea%b0%9c %ec%9e%85%eb%a0%a5%ea%b3%bc %ec%a6%9d%eb%aa%85 %ea%b2%80%ec%a6%9d%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-S-11' data-look='classic' transform='translate(149.43359375%2c 407)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b2%80%ec%a6%9d %ec%84%b1%ea%b3%b5 %ec%8b%9c %ec%83%81%ed%83%9c %ea%b0%b1%ec%8b%a0%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-2-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-2-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-2-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='%239bafa2' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(137.1428571429%2c 0%25%2c 84.3137254902%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
%3b%7d%23mermaid-dark-2%20.cluster%20rect%7bfill:hsl(220%2c%2058.9285714286%25%2c%2037.9607843137%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-2%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-2%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-2%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:%231e293b%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-2%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23e2e8f0%3b%7d%23mermaid-dark-2%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-2%20.icon-shape%2c%23mermaid-dark-2%20.image-shape%7bbackground-color:%23111827%3btext-align:center%3b%7d%23mermaid-dark-2%20.icon-shape%20p%2c%23mermaid-dark-2%20.image-shape%20p%7bbackground-color:%23111827%3bpadding:2px%3b%7d%23mermaid-dark-2%20.icon-shape%20.label%20rect%2c%23mermaid-dark-2%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:%23111827%3bfill:%23111827%3b%7d%23mermaid-dark-2%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-2%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-2%20.node%20.neo-node%7bstroke:%2300f0ff%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-2%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-2-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%2300f0ff%3bfilter:none%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20:root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M149.434%2c62L149.434%2c64.5C149.434%2c67%2c149.434%2c72%2c149.434%2c76.333C149.434%2c80.667%2c149.434%2c84.333%2c149.434%2c86.167L149.434%2c88'%20id='mermaid-dark-2-L_T_O_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_T_O_0'%20data-points='W3sieCI6MTQ5LjQzMzU5Mzc1LCJ5Ijo2Mn0seyJ4IjoxNDkuNDMzNTkzNzUsInkiOjc3fSx7IngiOjE0OS40MzM1OTM3NSwieSI6OTJ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M94.658%2c146L89.586%2c148.5C84.514%2c151%2c74.37%2c156%2c69.298%2c160.333C64.227%2c164.667%2c64.227%2c168.333%2c64.227%2c170.167L64.227%2c172'%20id='mermaid-dark-2-L_O_N_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_O_N_0'%20data-points='W3sieCI6OTQuNjU3NjQ1MDg5Mjg1NzIsInkiOjE0Nn0seyJ4Ijo2NC4yMjY1NjI1LCJ5IjoxNjF9LHsieCI6NjQuMjI2NTYyNSwieSI6MTc2fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M204.21%2c146L209.281%2c148.5C214.353%2c151%2c224.497%2c156%2c229.569%2c160.333C234.641%2c164.667%2c234.641%2c168.333%2c234.641%2c170.167L234.641%2c172'%20id='mermaid-dark-2-L_O_P_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_O_P_0'%20data-points='W3sieCI6MjA0LjIwOTU0MjQxMDcxNDI4LCJ5IjoxNDZ9LHsieCI6MjM0LjY0MDYyNSwieSI6MTYxfSx7IngiOjIzNC42NDA2MjUsInkiOjE3Nn1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M64.227%2c230L64.227%2c232.5C64.227%2c235%2c64.227%2c240%2c67.608%2c244.643C70.99%2c249.286%2c77.753%2c253.573%2c81.135%2c255.716L84.517%2c257.859'%20id='mermaid-dark-2-L_N_L_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_N_L_0'%20data-points='W3sieCI6NjQuMjI2NTYyNSwieSI6MjMwfSx7IngiOjY0LjIyNjU2MjUsInkiOjI0NX0seyJ4Ijo4Ny44OTUxODIyOTE2NjY2NiwieSI6MjYwfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M234.641%2c230L234.641%2c232.5C234.641%2c235%2c234.641%2c240%2c231.259%2c244.643C227.877%2c249.286%2c221.114%2c253.573%2c217.732%2c255.716L214.351%2c257.859'%20id='mermaid-dark-2-L_P_L_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P_L_0'%20data-points='W3sieCI6MjM0LjY0MDYyNSwieSI6MjMwfSx7IngiOjIzNC42NDA2MjUsInkiOjI0NX0seyJ4IjoyMTAuOTcyMDA1MjA4MzMzMzQsInkiOjI2MH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M149.434%2c338L149.434%2c340.5C149.434%2c343%2c149.434%2c348%2c149.434%2c352.333C149.434%2c356.667%2c149.434%2c360.333%2c149.434%2c362.167L149.434%2c364'%20id='mermaid-dark-2-L_L_S_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_L_S_0'%20data-points='W3sieCI6MTQ5LjQzMzU5Mzc1LCJ5IjozMzh9LHsieCI6MTQ5LjQzMzU5Mzc1LCJ5IjozNTN9LHsieCI6MTQ5LjQzMzU5Mzc1LCJ5IjozNjh9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_T_O_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_O_N_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_O_P_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_N_L_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P_L_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_L_S_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-T-0'%20data-look='classic'%20transform='translate(149.43359375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-107.5625'%20y='-27'%20width='215.125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-77.5625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='155.125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b1%b0%eb%9e%98%20%eb%b0%b0%ec%b9%98%20%2b%20%ec%9d%b4%ec%a0%84%20%ec%83%81%ed%83%9c%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-O-1'%20data-look='classic'%20transform='translate(149.43359375%2c%20119)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-80.2265625'%20y='-27'%20width='160.453125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-50.2265625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='100.453125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ec%98%a4%ed%94%84%ec%b2%b4%ec%9d%b8%20%ec%8b%a4%ed%96%89%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-N-3'%20data-look='classic'%20transform='translate(64.2265625%2c%20203)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-56.2265625'%20y='-27'%20width='112.453125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-26.2265625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='52.453125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ec%83%88%20%ec%83%81%ed%83%9c%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-P-5'%20data-look='classic'%20transform='translate(234.640625%2c%20203)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-90.1875'%20y='-27'%20width='180.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-60.1875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='120.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ec%83%81%ed%83%9c%20%ec%a0%84%ec%9d%b4%20%ec%a6%9d%eb%aa%85%20%cf%80%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-L-7'%20data-look='classic'%20transform='translate(149.43359375%2c%20299)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eL1:%20%ea%b3%b5%ea%b0%9c%20%ec%9e%85%eb%a0%a5%ea%b3%bc%20%ec%a6%9d%eb%aa%85%20%ea%b2%80%ec%a6%9d%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-S-11'%20data-look='classic'%20transform='translate(149.43359375%2c%20407)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b2%80%ec%a6%9d%20%ec%84%b1%ea%b3%b5%20%ec%8b%9c%20%ec%83%81%ed%83%9c%20%ea%b0%b1%ec%8b%a0%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-2-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-2-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-2-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
강의가 강조하는 것은 이 사용 목적에는 영지식이 반드시 필요한 것은 아니라는 점이다. 계산 결과의 정확성을 짧게 검증하는 succinctness가 중심이고, 거래 데이터를 모두 숨기는지는 별도 설계다.
이름에 zk가 들어간 zkRollup을 보더라도 어떤 정보가 공개되는지 따로 확인해야 한다.
Bridge와 proof of consensus
Chain B가 Chain A의 어떤 블록에 대한 합의가 올바르게 성립했다는 증명을 검증하게 할 수 있다. 이를 바탕으로 체인 사이의 자산 이동이나 상태 연동을 설계한다.
여기서 증명해야 하는 것은 블록 데이터가 존재한다는 사실만이 아니다. 해당 체인의 합의 검증 규칙을 만족한다는 관계가 포함돼야 한다. 강의는 이를 zkBridge의 사용 방향으로 제시한다.
보충으로, 올바른 상태 전이 증명을 받았다는 것과 사용자에게 필요한 데이터가 실제로 제공된다는 것은 다른 조건이다. Rollup의 데이터 가용성이나 bridge의 신뢰 기준까지 증명 길이 하나로 해결되는 것은 아니다.
9. 블록체인 응용 II: 프라이버시와 조건 증명
강의 7쪽
비공개 거래
공개 블록체인에서도 소유권과 금액 보존 같은 조건을 확인하면서 거래의 세부 값을 숨길 수 있다.
예를 들어 다음 관계를 생각할 수 있다.
Witness에는 소유권을 나타내는 비밀과 금액 등이 들어가고, 공개 입력에는 관련 commitment와 중복 사용 방지 정보 등을 둘 수 있다. 공개하는 필드는 프로토콜에 따라 달라진다.
강의가 열거한 예시는 Zcash, Tornado Cash, IronFish, Aleo다. 서로 다른 시스템을 같은 프로토콜로 취급하기보다는, 유효성을 공개적으로 확인하면서 특정 데이터를 숨기려는 응용 예시로 이해하면 된다.
정책 준수와 지급 능력
강의는 다음 두 방향도 든다.
- 비공개 거래가 정해진 정책 조건을 만족함을 증명하는 예: Espresso.
- 개별 고객 잔액을 공개하지 않고 자산이 부채 이상임을 증명하는 예: Raposa.
후자의 관계를 단순화하면
다. 영지식은 그 부등식에 사용한 개별 값을 감추는 데 도움을 준다.
보충으로, 어떤 부채가 계산에 포함되었는지도 중요하다. 일부 부채를 누락한 집합에서 부등식을 정확히 증명해도 전체 지급 능력을 보였다고 할 수 없다. 증명은 입력 데이터의 현실 세계 완전성까지 자동으로 보장하지 않는다.
정책 준수도 마찬가지다. 검증 가능한 조건을 관계로 표현하고 그 관계를 증명하는 것이며, 증명 하나가 모든 법적 판단을 대신한다는 뜻은 아니다.
10. AI 보안 I: 검증 가능한 추론
강의 8쪽
서비스가 “이 결과는 이 모델로 계산했다”고 말할 때 사용자는 실제로 약속한 모델을 사용했는지 확인하고 싶을 수 있다.
는 입력, 는 모델 가중치, 는 출력이다. 단순히 “어떤 모델이 이 출력을 낸다”는 주장만으로는 광고한 모델과 연결되지 않는다. 그래서 미리 고정한 모델에 대한 commitment가 필요하다.
보충 예제: 모델 commitment와 계산 결과 연결
모델 commitment를
라 하자. 공개 입력을 , witness를 로 두면
라는 관계를 증명할 수 있다. 실제 증명 방식은 내부 계산 값도 witness의 일부로 사용할 수 있다.
%3b%7d%23mermaid-3 .cluster rect%7bfill:white%3bstroke:hsl(0%2c 0%25%2c 90%25)%3bstroke-width:1px%3b%7d%23mermaid-3 .cluster text%7bfill:black%3b%7d%23mermaid-3 .cluster span%7bcolor:black%3b%7d%23mermaid-3 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:white%3bborder:1px solid hsl(0%2c 0%25%2c 90%25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-3 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%2328332d%3b%7d%23mermaid-3 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-3 .icon-shape%2c%23mermaid-3 .image-shape%7bbackground-color:%23edf4ef%3btext-align:center%3b%7d%23mermaid-3 .icon-shape p%2c%23mermaid-3 .image-shape p%7bbackground-color:%23edf4ef%3bpadding:2px%3b%7d%23mermaid-3 .icon-shape .label rect%2c%23mermaid-3 .image-shape .label rect%7bopacity:0.5%3bbackground-color:%23edf4ef%3bfill:%23edf4ef%3b%7d%23mermaid-3 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-3 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-3 .node .neo-node%7bstroke:%239bafa2%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node rect%2c%23mermaid-3 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-3 %5bdata-look='neo'%5d.node polygon%7bstroke:url(%23mermaid-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node path%7bstroke:url(%23mermaid-3-gradient)%3bstroke-width:1px%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239bafa2%3bfilter:none%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node circle%7bstroke:url(%23mermaid-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:url(%23mermaid-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:url(%23mermaid-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-3 :root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M68.491%2c110L66.064%2c112.5C63.637%2c115%2c58.783%2c120%2c56.357%2c131.5C53.93%2c143%2c53.93%2c161%2c53.93%2c179C53.93%2c197%2c53.93%2c215%2c57.186%2c226.135C60.442%2c237.269%2c66.954%2c241.538%2c70.21%2c243.673L73.467%2c245.807' id='mermaid-3-L_U_R_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_U_R_0' data-points='W3sieCI6NjguNDkxMTIyMTU5MDkwOSwieSI6MTEwfSx7IngiOjUzLjkyOTY4NzUsInkiOjEyNX0seyJ4Ijo1My45Mjk2ODc1LCJ5IjoxNzl9LHsieCI6NTMuOTI5Njg3NSwieSI6MjMzfSx7IngiOjc2LjgxMTk0MTk2NDI4NTcyLCJ5IjoyNDh9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M167.509%2c110L169.936%2c112.5C172.363%2c115%2c177.217%2c120%2c179.643%2c125C182.07%2c130%2c182.07%2c135%2c182.07%2c137.5L182.07%2c140' id='mermaid-3-L_U_W_0' class='edge-thickness-invisible edge-pattern-solid' style='%3b' data-edge='true' data-et='edge' data-id='L_U_W_0' data-points='W3sieCI6MTY3LjUwODg3Nzg0MDkwOTEsInkiOjExMH0seyJ4IjoxODIuMDcwMzEyNSwieSI6MTI1fSx7IngiOjE4Mi4wNzAzMTI1LCJ5IjoxNDB9XQ==' data-look='classic'/%3e%3cpath d='M182.07%2c218L182.07%2c220.5C182.07%2c223%2c182.07%2c228%2c178.814%2c232.635C175.558%2c237.269%2c169.046%2c241.538%2c165.79%2c243.673L162.533%2c245.807' id='mermaid-3-L_W_R_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_W_R_0' data-points='W3sieCI6MTgyLjA3MDMxMjUsInkiOjIxOH0seyJ4IjoxODIuMDcwMzEyNSwieSI6MjMzfSx7IngiOjE1OS4xODgwNTgwMzU3MTQyOCwieSI6MjQ4fV0=' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c302L118%2c304.5C118%2c307%2c118%2c312%2c118%2c316.333C118%2c320.667%2c118%2c324.333%2c118%2c326.167L118%2c328' id='mermaid-3-L_R_P_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_R_P_0' data-points='W3sieCI6MTE4LCJ5IjozMDJ9LHsieCI6MTE4LCJ5IjozMTd9LHsieCI6MTE4LCJ5IjozMzJ9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M118%2c410L118%2c412.5C118%2c415%2c118%2c420%2c118%2c424.333C118%2c428.667%2c118%2c432.333%2c118%2c434.167L118%2c436' id='mermaid-3-L_P_V_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P_V_0' data-points='W3sieCI6MTE4LCJ5Ijo0MTB9LHsieCI6MTE4LCJ5Ijo0MjV9LHsieCI6MTE4LCJ5Ijo0NDB9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_U_R_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_U_W_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_W_R_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_R_P_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P_V_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-3-flowchart-U-0' data-look='classic' transform='translate(118%2c 59)'%3e%3crect class='basic label-container' style='' x='-91.7890625' y='-51' width='183.578125' height='102'/%3e%3cg class='label' style='' transform='translate(-61.7890625%2c -36)'%3e%3crect/%3e%3cforeignObject width='123.578125' height='72'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label'%3e%3cp%3e%ea%b3%b5%ea%b0%9c %ec%9e%85%eb%a0%a5%3cbr /%3e%eb%aa%a8%eb%8d%b8 commitment%3cbr /%3e%ec%9e%85%eb%a0%a5 a%ec%99%80 %ec%b6%9c%eb%a0%a5 y%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-R-1' data-look='classic' transform='translate(118%2c 275)'%3e%3crect class='basic label-container' style='' x='-72.2265625' y='-27' width='144.453125' height='54'/%3e%3cg class='label' style='' transform='translate(-42.2265625%2c -12)'%3e%3crect/%3e%3cforeignObject width='84.453125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ec%a6%9d%eb%aa%85%ed%95%a0 %ea%b4%80%ea%b3%84%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-W-3' data-look='classic' transform='translate(182.0703125%2c 179)'%3e%3crect class='basic label-container' style='' x='-106.140625' y='-39' width='212.28125' height='78'/%3e%3cg class='label' style='' transform='translate(-76.140625%2c -24)'%3e%3crect/%3e%3cforeignObject width='152.28125' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b'%3e%3cspan class='nodeLabel markdown-node-label'%3e%3cp%3e%eb%b9%84%eb%b0%80 witness%3cbr /%3e%ea%b0%80%ec%a4%91%ec%b9%98 %ce%b8%ec%99%80 opening %cf%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-P-7' data-look='classic' transform='translate(118%2c 371)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ea%b0%99%ec%9d%80 %ce%b8%ea%b0%80 commitment%ec%99%80 %ec%b6%94%eb%a1%a0%ec%8b%9d%ec%9d%84 %eb%aa%a8%eb%91%90 %eb%a7%8c%ec%a1%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-V-9' data-look='classic' transform='translate(118%2c 479)'%3e%3crect class='basic label-container' style='' x='-110' y='-39' width='220' height='78'/%3e%3cg class='label' style='' transform='translate(-80%2c -24)'%3e%3crect/%3e%3cforeignObject width='160' height='48'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table%3b white-space: break-spaces%3b line-height: 1.5%3b max-width: 160px%3b text-align: center%3b width: 160px%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%ec%82%ac%ec%9a%a9%ec%9e%90%eb%8a%94 %ea%b0%80%ec%a4%91%ec%b9%98%eb%a5%bc %eb%b0%9b%ec%a7%80 %ec%95%8a%ea%b3%a0 %ec%a6%9d%eb%aa%85 %ea%b2%80%ec%a6%9d%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-3-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-3-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient id='mermaid-3-gradient' gradientUnits='objectBoundingBox' x1='0%25' y1='0%25' x2='100%25' y2='0%25'%3e%3cstop offset='0%25' stop-color='%239bafa2' stop-opacity='1'/%3e%3cstop offset='100%25' stop-color='hsl(137.1428571429%2c 0%25%2c 84.3137254902%25)' stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
%3b%7d%23mermaid-dark-3%20.cluster%20rect%7bfill:hsl(220%2c%2058.9285714286%25%2c%2037.9607843137%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-3%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-3%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-3%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:Arial%2csans-serif%3bfont-size:12px%3bbackground:%231e293b%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-3%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23e2e8f0%3b%7d%23mermaid-dark-3%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-3%20.icon-shape%2c%23mermaid-dark-3%20.image-shape%7bbackground-color:%23111827%3btext-align:center%3b%7d%23mermaid-dark-3%20.icon-shape%20p%2c%23mermaid-dark-3%20.image-shape%20p%7bbackground-color:%23111827%3bpadding:2px%3b%7d%23mermaid-dark-3%20.icon-shape%20.label%20rect%2c%23mermaid-dark-3%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:%23111827%3bfill:%23111827%3b%7d%23mermaid-dark-3%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-3%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-3%20.node%20.neo-node%7bstroke:%2300f0ff%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-3%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-3-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%2300f0ff%3bfilter:none%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20:root%7b--mermaid-font-family:Arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M68.491%2c110L66.064%2c112.5C63.637%2c115%2c58.783%2c120%2c56.357%2c131.5C53.93%2c143%2c53.93%2c161%2c53.93%2c179C53.93%2c197%2c53.93%2c215%2c57.186%2c226.135C60.442%2c237.269%2c66.954%2c241.538%2c70.21%2c243.673L73.467%2c245.807'%20id='mermaid-dark-3-L_U_R_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_U_R_0'%20data-points='W3sieCI6NjguNDkxMTIyMTU5MDkwOSwieSI6MTEwfSx7IngiOjUzLjkyOTY4NzUsInkiOjEyNX0seyJ4Ijo1My45Mjk2ODc1LCJ5IjoxNzl9LHsieCI6NTMuOTI5Njg3NSwieSI6MjMzfSx7IngiOjc2LjgxMTk0MTk2NDI4NTcyLCJ5IjoyNDh9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M167.509%2c110L169.936%2c112.5C172.363%2c115%2c177.217%2c120%2c179.643%2c125C182.07%2c130%2c182.07%2c135%2c182.07%2c137.5L182.07%2c140'%20id='mermaid-dark-3-L_U_W_0'%20class='edge-thickness-invisible%20edge-pattern-solid'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_U_W_0'%20data-points='W3sieCI6MTY3LjUwODg3Nzg0MDkwOTEsInkiOjExMH0seyJ4IjoxODIuMDcwMzEyNSwieSI6MTI1fSx7IngiOjE4Mi4wNzAzMTI1LCJ5IjoxNDB9XQ=='%20data-look='classic'/%3e%3cpath%20d='M182.07%2c218L182.07%2c220.5C182.07%2c223%2c182.07%2c228%2c178.814%2c232.635C175.558%2c237.269%2c169.046%2c241.538%2c165.79%2c243.673L162.533%2c245.807'%20id='mermaid-dark-3-L_W_R_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_W_R_0'%20data-points='W3sieCI6MTgyLjA3MDMxMjUsInkiOjIxOH0seyJ4IjoxODIuMDcwMzEyNSwieSI6MjMzfSx7IngiOjE1OS4xODgwNTgwMzU3MTQyOCwieSI6MjQ4fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c302L118%2c304.5C118%2c307%2c118%2c312%2c118%2c316.333C118%2c320.667%2c118%2c324.333%2c118%2c326.167L118%2c328'%20id='mermaid-dark-3-L_R_P_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_R_P_0'%20data-points='W3sieCI6MTE4LCJ5IjozMDJ9LHsieCI6MTE4LCJ5IjozMTd9LHsieCI6MTE4LCJ5IjozMzJ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M118%2c410L118%2c412.5C118%2c415%2c118%2c420%2c118%2c424.333C118%2c428.667%2c118%2c432.333%2c118%2c434.167L118%2c436'%20id='mermaid-dark-3-L_P_V_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P_V_0'%20data-points='W3sieCI6MTE4LCJ5Ijo0MTB9LHsieCI6MTE4LCJ5Ijo0MjV9LHsieCI6MTE4LCJ5Ijo0NDB9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_U_R_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_U_W_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_W_R_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_R_P_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P_V_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-U-0'%20data-look='classic'%20transform='translate(118%2c%2059)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-91.7890625'%20y='-51'%20width='183.578125'%20height='102'/%3e%3cg%20class='label'%20style=''%20transform='translate(-61.7890625%2c%20-36)'%3e%3crect/%3e%3cforeignObject%20width='123.578125'%20height='72'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel%20markdown-node-label'%3e%3cp%3e%ea%b3%b5%ea%b0%9c%20%ec%9e%85%eb%a0%a5%3cbr%20/%3e%eb%aa%a8%eb%8d%b8%20commitment%3cbr%20/%3e%ec%9e%85%eb%a0%a5%20a%ec%99%80%20%ec%b6%9c%eb%a0%a5%20y%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-R-1'%20data-look='classic'%20transform='translate(118%2c%20275)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-72.2265625'%20y='-27'%20width='144.453125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-42.2265625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='84.453125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ec%a6%9d%eb%aa%85%ed%95%a0%20%ea%b4%80%ea%b3%84%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-W-3'%20data-look='classic'%20transform='translate(182.0703125%2c%20179)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-106.140625'%20y='-39'%20width='212.28125'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-76.140625%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='152.28125'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel%20markdown-node-label'%3e%3cp%3e%eb%b9%84%eb%b0%80%20witness%3cbr%20/%3e%ea%b0%80%ec%a4%91%ec%b9%98%20%ce%b8%ec%99%80%20opening%20%cf%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-P-7'%20data-look='classic'%20transform='translate(118%2c%20371)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ea%b0%99%ec%9d%80%20%ce%b8%ea%b0%80%20commitment%ec%99%80%20%ec%b6%94%eb%a1%a0%ec%8b%9d%ec%9d%84%20%eb%aa%a8%eb%91%90%20%eb%a7%8c%ec%a1%b1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-V-9'%20data-look='classic'%20transform='translate(118%2c%20479)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-110'%20y='-39'%20width='220'%20height='78'/%3e%3cg%20class='label'%20style=''%20transform='translate(-80%2c%20-24)'%3e%3crect/%3e%3cforeignObject%20width='160'%20height='48'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table%3b%20white-space:%20break-spaces%3b%20line-height:%201.5%3b%20max-width:%20160px%3b%20text-align:%20center%3b%20width:%20160px%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%ec%82%ac%ec%9a%a9%ec%9e%90%eb%8a%94%20%ea%b0%80%ec%a4%91%ec%b9%98%eb%a5%bc%20%eb%b0%9b%ec%a7%80%20%ec%95%8a%ea%b3%a0%20%ec%a6%9d%eb%aa%85%20%ea%b2%80%ec%a6%9d%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-3-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-3-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-3-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
Commitment는 서비스가 결과에 맞춰 다른 모델을 끼워 넣지 못하도록 모델의 정체를 연결한다. 그 commitment가 어떤 모델을 대표하는지에 대한 사전 등록이나 신뢰 기준도 있어야 한다.
Commitment는 값을 정해 둔 뒤 나중에 다른 값이었다고 바꾸기 어렵게 만드는 공개값이다. 여기서 opening은 그 공개값이 특정 로 만들어졌음을 확인하는 데 필요한 데이터이며, 위 표기에서는 와 난수 가 그 역할을 한다. 모델을 숨기려면 commitment 자체도 적절한 은닉성을 가져야 한다. 첫 식은 “등록한 모델과 같은 모델인가”, 둘째 식은 “그 모델로 이 출력을 계산했는가”를 확인하므로 둘을 같은 witness에 묶는 것이 중요하다.
정확한 실행과 좋은 예측은 다르다
를 증명해도 가 현실에서 올바른 답이라는 결론은 바로 나오지 않는다. 약속한 모델이 틀린 예측을 해도 실행 관계 자체는 참일 수 있다.
또한 모델을 실제 증명 관계로 옮길 때 양자화, 유한체 표현, 비선형 연산, 반올림 규칙 등을 정해야 한다. 증명은 정의한 계산 의미에 대해 성립한다. 구현한 계산과 원래 모델의 수치 의미가 맞는지 확인하는 문제가 남는다.
11. AI 보안 II: 모델을 숨긴 채 성능을 증명하기
강의 8쪽
가중치를 witness로 두면 모델을 공개하지 않고 특정 데이터셋에 대한 정확도도 증명할 수 있다. 강의의 예시는 정확도 90% 이상이다.
고정된 테스트셋 에 대해
정수 연산으로 쓰면 90% 조건은
이다. 모델 commitment와 이 조건을 함께 묶어 같은 모델이 해당 점수를 냈음을 증명한다.
보충 예제로 테스트셋이 20개라면 정답이 최소 18개여야 한다. 17개면 85%이므로 증명이 통과해서는 안 된다.
여기서 공개적으로 고정해야 하는 것은 모델만이 아니다. 테스트셋과 평가 규칙도 고정해야 유리한 데이터만 골라 평가하는 일을 막을 수 있다. 그리고 특정 테스트셋의 90%를 증명했다는 사실만으로 모든 실제 입력에 대한 정확도나 일반화 성능을 보장하지는 않는다.
위 식의 은 괄호 안 조건이 참이면 , 거짓이면 인 지시 함수다. 이를 모든 테스트 항목에 대해 더하면 정답 개수가 된다. 이 양수일 때 그 개수를 으로 나눈 값이 이상이라는 조건의 양변에 을 곱하면 정수 부등식을 얻는다. 따라서 90%라는 소수를 그대로 계산하지 않고도 동일한 평가 조건을 표현할 수 있다.
zkML과 zkCNN
이처럼 영지식과 검증 가능한 머신러닝을 연결하는 분야를 zkML이라 부른다. 강의는 Liu·Xie·Zhang의 zkCNN, CCS 2021을 예로 든다.
zkCNN은 CNN의 추론 결과가 해당 모델의 계산에서 나왔음을 모델을 공개하지 않고 증명하며, 비밀 CNN의 공개 데이터셋 정확도 증명으로도 확장한다. zkCNN 논문 정보와 초록[3]
이 글의 90%와 20개 예제는 강의 조건을 설명하기 위한 계산이며, 특정 논문의 실험 성능 수치가 아니다.
12. AI 보안 III: 콘텐츠 출처와 C2PA
강의 8쪽
강의는 C2PA와 zk-SNARK를 결합하는 콘텐츠 출처 검증도 언급한다. 생성·편집 이력이나 특정 변환의 적법한 수행을 확인하면서 필요한 정보를 제한적으로 공개하는 방향으로 생각할 수 있다.
다만 다음 세 가지를 구별해야 한다.
| 질문 | 확인하려는 대상 |
|---|---|
| 서명과 출처 기록이 유효한가 | 어떤 주체가 어떤 이력에 서명했고 기록이 변조되지 않았는가 |
| 특정 연산이 수행되었는가 | 공개한 입력·출력 또는 commitment 사이의 계산 관계 |
| 사진에 담긴 사건이 실제로 일어났는가 | 현실 세계의 사실 |
C2PA의 provenance는 콘텐츠의 출처와 이력에 관한 검증 가능한 기록이다. 유효한 기록이 있다는 사실만으로 내용의 진실성을 판정하거나 모든 조작을 자동 탐지하는 것은 아니다. C2PA 공식 설명의 목표와 비목표[4]
zk-SNARK를 덧붙여도 보장 범위는 증명한 관계에 달려 있다. 예를 들어 “서명된 원본에서 허용된 편집을 수행했다”는 관계와 “원본이 현실의 참된 사건을 담았다”는 주장은 다르다.
13. 성질을 나눠서 확인하기
| 확인할 것 | 의미 | 자동으로 따라오지 않는 것 |
|---|---|---|
| Succinctness | 증명이 짧고 검증이 빠름 | 빠른 증명 생성, 정보 비공개 |
| Non-interactivity | 증명 단계의 질문·응답이 불필요 | 사전 설정 불필요, 모든 체계의 공개 검증 |
| Argument soundness | 효율적인 거짓 증명자를 막음 | 무제한 계산 공격자에 대한 동일한 보장 |
| Knowledge soundness | 잘 설득하는 증명자에서 witness 추출 가능 | 실제 검증자가 비밀을 읽는 기능 |
| Zero knowledge | 공개 statement를 넘어서는 정보 누출을 막음 | 공개 입력·출력까지 숨기는 기능 |
| Verifiable inference | 정한 모델과 계산 규칙에 맞는 출력 | 예측의 진실성·공정성·일반화 성능 |
14. 복습문제
1. SNARK의 네 요소를 풀어 쓰고, zk-가 추가하는 조건을 설명하라.
Succinct, Non-interactive, ARgument of Knowledge다. 짧은 증명과 빠른 검증, 증명 단계의 비대화성, 효율적인 공격자에 대한 건전성(soundness), witness 지식을 요구한다. zk-는 영지식성(zero-knowledge) 조건을 추가한다.
2. SHA256(m)=0인 1GB 메시지를 그대로 보내면 왜 succinct한 방식이 아닌가?
메시지 전체를 전송해야 하고, 검증자가 1GB를 읽고 해시 계산을 수행해야 한다. 통신과 검증이 큰 witness 크기에 직접 비례한다.
3. SNARK가 있으면 SHA-256의 원상을 쉽게 찾을 수 있는가?
아니다. Witness 찾기와 주어진 witness로 증명을 생성하기는 다르다. 강의의 증명자는 관계를 만족하는 메시지를 이미 안다고 가정한다.
4. Proof와 argument의 차이는 검증자가 빠른지에 관한 것인가?
주된 구별은 건전성(soundness)에서 상대하는 증명자의 계산 능력이다. Proof는 무제한 증명자까지, argument는 PPT 증명자를 상대로 건전성(soundness)을 요구한다.
5. Fiat-Shamir로 비대화형이 되면 자동으로 SNARK가 되는가?
아니다. 안전한 변환을 위한 프로토콜·해시 모형·challenge 조건이 필요하고, 변환만으로 증명의 succinctness까지 자동으로 생기지 않는다.
6. zkRollup은 모든 거래 정보를 숨긴다는 뜻인가?
아니다. 강의에서 중심 역할은 오프체인 계산 결과를 L1이 짧은 증명으로 검증하는 것이다. 무엇을 숨기는지는 별도의 공개 입력·witness 설계에 달려 있다.
7. 자산≥부채의 증명이 유효하면 거래소의 모든 부채를 검증한 것인가?
아니다. 증명 관계에 들어간 데이터에 대해서만 부등식이 보장된다. 부채 누락 여부와 입력 데이터의 완전성은 추가로 확보해야 한다.
8. 모델 가중치를 숨기면서 약속한 모델을 썼음을 보이려면 무엇을 연결해야 하는가?
동일한 가중치가 공개 모델 commitment의 opening 조건과 추론식 를 모두 만족함을 하나의 관계로 묶어야 한다.
9. 20개 테스트 입력에서 정확도 90% 이상을 증명하려면 최소 몇 개가 정답이어야 하는가?
최소 18개다. 이고, 17개는 85%라 조건을 만족하지 않는다. 테스트셋과 평가 규칙도 고정되어 있어야 한다.
10. 검증 가능한 추론은 모델의 답이 현실에서도 맞음을 보장하는가?
아니다. 정한 모델과 수치 규칙으로 결과를 계산했다는 보장이다. 모델이 잘못된 예측을 하거나 편향된 답을 내는 문제와는 구별된다.
11. 공개 검증이 가능한데도 영지식을 가질 수 있는 이유는?
검증은 공개 statement와 증명의 유효성을 확인하는 과정이지 witness를 읽는 과정이 아니다. 비대화형 ZK의 시뮬레이터는 설정이나 random-oracle 모형에서 주어진 권한을 사용하며, 일반 공개 검증자가 같은 권한을 갖는 것은 아니다.
12. 유효한 C2PA 기록과 계산 증명만으로 사진 속 사건의 진실성을 확정할 수 있는가?
아니다. 출처 기록의 무결성, 특정 계산 관계, 현실 세계의 진실은 서로 다른 주장이다. 무엇이 공개 입력이고 무엇을 증명하는 관계인지 확인해야 한다.
참고 링크
- https://www.ietf.org/ietf-ftp/internet-drafts/draft-irtf-cfrg-fiat-shamir-03.html
- https://people.cs.georgetown.edu/jthaler/ProofsArgsAndZK.pdf
- https://experts.illinois.edu/en/publications/zkcnn-zero-knowledge-proofs-for-convolutional-neural-network-pred/
- https://spec.c2pa.org/specifications/specifications/2.2/explainer/Explainer.html
Comments